Nvidia Vera — разбор архитектуры передового CPU Nvidia
Введение
Nvidia давно стала крупнейшим в мире поставщиком ИИ-ускорителей и сетевого оборудования для дата-центров, но с процессорами у зеленой компании все было не так однозначно. Предыдущий серверный CPU Grace собирался из стандартных ядер Arm Neoverse V2, и в системах Grace Blackwell он играл скорее вспомогательную роль: кормить данными видеокарты и не мешаться под ногами. С новым поколением старина Хуанг решил, что пора выходить на рынок CPU всерьез. Так появился Vera — первый серверный процессор Nvidia на ядрах собственной разработки Olympus, который компания позиционирует не просто как хост для GPU, а как "CPU для агентов". В этой статье специалисты компании ServerFlow разберут архитектуру Nvidia Vera: как устроено ядро Olympus, что такое Spatial Multithreading, зачем серверному процессору LPDDR5X и в каких системах Vera будет работать, а также посмотрим, насколько убедительны заявления Nvidia о производительности.
Nvidia Grace vs Nvidia Vera
Чтобы понять масштаб изменений, проще всего положить характеристики Vera рядом с его предшественником:
Прирост виден по всем фронтам, но главное изменение в ядрах. Отказавшись от лицензионных ядер Arm, Nvidia получила полный контроль над микроархитектурой и смогла заточить ядро под свои задачи. По словам компании, Olympus выполняет в 1,5 раза больше инструкций за такт, чем Neoverse V2 в Grace. При этом совместимость с экосистемой Arm сохранилась полностью: ядро реализует набор инструкций Armv9.2-A, так что весь софт, собранный под Grace и другие Arm-серверы, запустится на Vera без изменений.
Стоит отметить и то, что Nvidia впервые за много лет вернулась к собственным процессорным ядрам. Раньше она уже разрабатывала ядра Denver и Carmel, но только для мобильных и встраиваемых чипов Tegra. Olympus — первое ядро Nvidia, созданное для серверов.
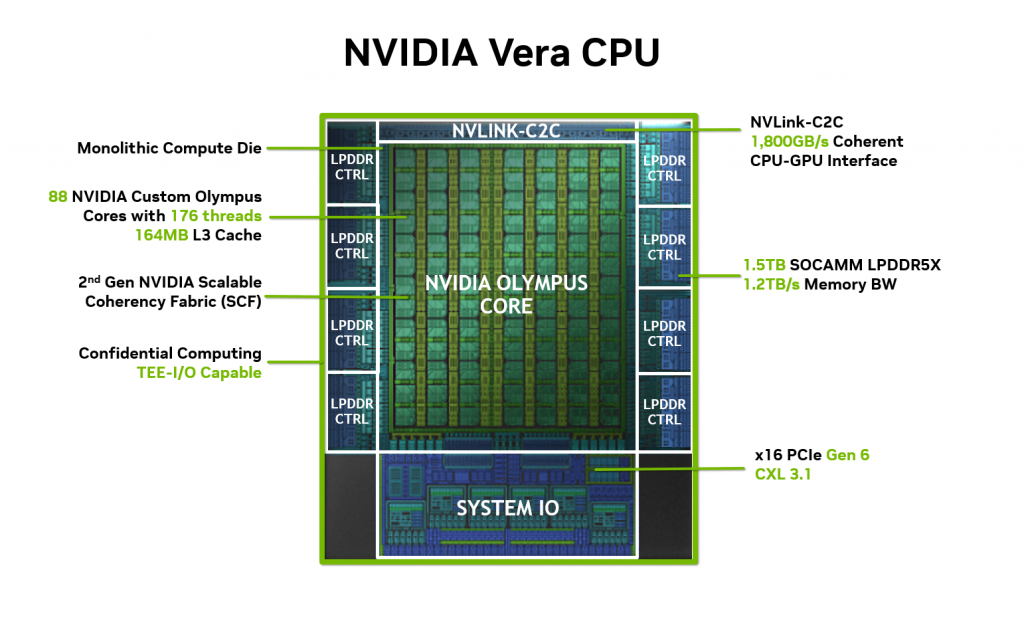
Архитектура центрального процессора Nvidia Vera. Источник: .
ARM-ядро Olympus
Nvidia исходила из простой идеи: ИИ-агентам нужны не сотни слабых ядер, а быстрые ядра, которые как можно скорее выполнят очередной вызов инструмента, кусок кода или запрос к базе данных и перейдут к следующей задаче. Поэтому Olympus получился очень "толстым" ядром. Пройдемся по его основным блокам.
Бэкенд
В каждом ядре 18 исполнительных конвейеров:
- 8 целочисленных ALU, два из которых умеют выполнять сложные операции вроде умножения и деления, плюс 4 блока обработки переходов;
- 6 векторных конвейеров SVE2 шириной 128 бит с поддержкой FP8, два из которых дополнительно ускоряют криптографию — AES, SHA, SM3;
- 4 конвейера загрузки и 2 конвейера записи данных.
Обратите внимание: целочисленных конвейеров больше, чем векторных. Olympus в первую очередь заточен под "обычный" серверный код с ветвлениями и указателями, а не под тяжелую векторную математику.
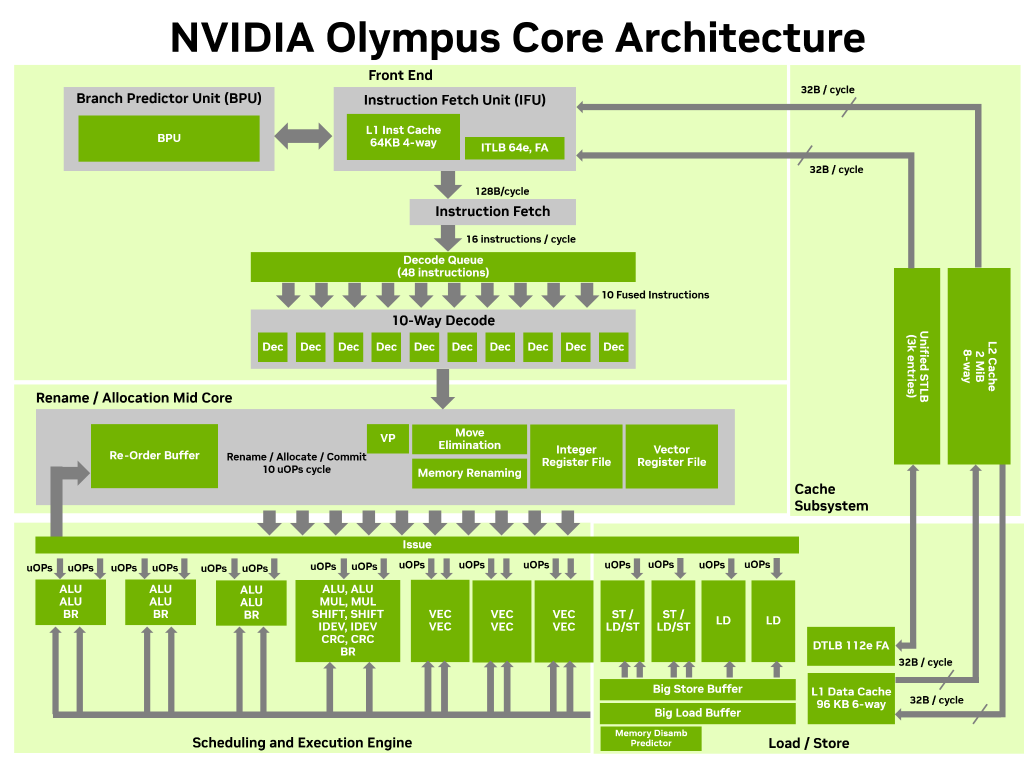
Архитектура ядра Olympus. Источник: .
Кэши и предвыборка
Каждое ядро получило 96 КБ L1-кэша данных и 2 МБ собственного L2-кэша. Отдельной гордостью Nvidia стал графовый префетчер — блок, который распознает в коде цепочки указателей и заранее подгружает данные по конечному адресу, не дожидаясь, пока указатель будет вычислен. Такие структуры данных постоянно встречаются в графовой аналитике, рантаймах агентов и базах данных, а аналогов этого блока у Intel и AMD пока нет.
Spatial Multithreading
У Grace многопоточности не было вовсе: 72 ядра — 72 потока. В Vera Nvidia ее добавила, но сделала по-своему и даже дала ей отдельное название — Spatial Multithreading (пространственная многопоточность).
В классической многопоточности, которую используют Intel и AMD, два потока делят между собой почти все ресурсы ядра, и аппаратура на лету решает, какому потоку что достанется. Это эффективно, но у такого подхода есть обратная сторона: если соседний поток начинает активно нагружать ядро, первый поток неизбежно замедляется. В облаках, где на соседних потоках могут работать задачи разных клиентов, это превращается в непредсказуемые задержки — проблему "шумного соседа".
Nvidia пошла другим путем и статически разделила ресурсы ядра между двумя потоками. Каждый поток получает свою половину конвейеров, буферов и очередей. Именно поэтому все исполнительные блоки Olympus сгруппированы парами, а фронтенд сделан таким широким: его хватает на обслуживание сразу двух независимых потоков. На практике ядро может работать в двух режимах:
- Один поток выполняет основную тяжелую задачу, а второй в это время занимается служебной работой вроде обработки системных вызовов или мониторинга;
- Два потока работают как две независимые среды исполнения, практически не мешая друг другу.
По словам Nvidia, в многопоточных нагрузках такая схема дает примерно тот же прирост, что и классический SMT, но с куда более стабильными задержками. Правда, на вопрос, может ли один поток забирать простаивающие ресурсы второго, если тот ничем не занят, компания пока не ответила. От этого во многом зависит, насколько хорошо Vera покажет себя в однопоточных задачах при включенной многопоточности.
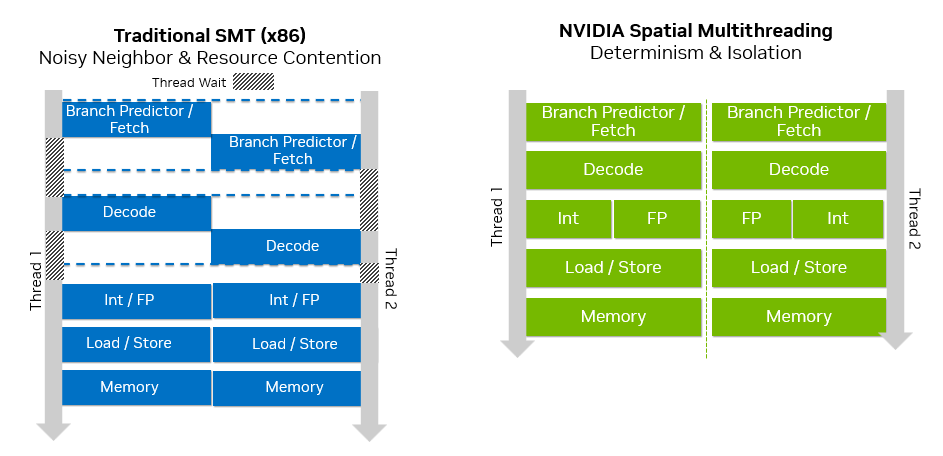
Сравнение традиционной технологии многопоточности и пространственной многопоточности Nvidia. Источник: .
Компоновка
В спорах о чиплетах и монолитах Nvidia заняла промежуточную позицию. Все 88 ядер Olympus размещены на одном монолитном вычислительном кристалле, а вот контроллеры памяти и ввод-вывод вынесены в отдельные чиплеты. Всего в Vera шесть кристаллов, установленных на общий интерпозер. Причина проста: все вместе на один кристалл максимально допустимого размера просто не помещалось.
Почему ядра не стали дробить на чиплеты, как это делает AMD и Intel? Ответ — в межъядерных задержках. Когда ядра разнесены по разным чиплетам, обмен данными между ними идет через внешний I/O-кристалл, и это заметно медленнее, чем внутри одного кристалла. Nvidia даже ввела для этого эффекта собственный термин — "налог на чиплеты". В монолитном кристалле Vera все ядра находятся в одном домене: никаких NUMA-узлов внутри процессора нет, а задержка обращения к любому ядру и любой части кэша примерно одинакова.
Связывает все это новая версия фирменной фабрики Scalable Coherency Fabric (SCF), которая впервые появилась в Grace. Это сетка из коммутационных узлов, которые соединяют ядра с распределенным по кристаллу L3-кэшем объемом 164 МБ, а также с контроллерами памяти, вводом-выводом и интерфейсом NVLink-C2C. Пропускная способность SCF составляет 3,4 ТБ/с, и, по данным Nvidia, этого хватает, чтобы под полной нагрузкой использовать более 90% пиковой пропускной способности памяти.
Любопытная деталь: L2-кэша в Vera суммарно больше, чем L3 — 176 МБ против 164 МБ. По меркам x86-процессоров это немного: у Xeon 6980P 504 МБ L3, а у EPYC 9996 целый гигабайт. Nvidia делает ставку не на гигантский общий кэш, а на большие собственные кэши каждого ядра и быструю память.
Память
В отличие от Intel и AMD, которые делают ставку на DDR5 и MRDIMM, Nvidia второй раз подряд выбрала для серверного процессора мобильную память LPDDR5X. Но если в Grace она была распаяна прямо рядом с процессором, то в Vera память устанавливается в виде съемных модулей SOCAMM2. Это значит, что объем можно подобрать под задачу, а вышедший из строя модуль — заменить, не меняя всю плату.
Как Nvidia получила 1,2 ТБ/с на мобильной памяти? Давайте разберемся. На плате с Vera устанавливается 8 модулей SOCAMM2, и у каждого из них шина шириной 128 бит. В сумме это 1024 бита — столько же, сколько у 16 каналов DDR5 в Venice или Diamond Rapids. Умножаем на скорость 9600 MT/s и получаем около 1,23 ТБ/с. Объем памяти — от 256 ГБ до 1,5 ТБ на процессор.
Главный аргумент Nvidia в пользу LPDDR5X — энергоэффективность. По данным компании, полностью укомплектованная подсистема памяти Vera потребляет всего 30–40 Вт в зависимости от объема. Для сравнения, 16 модулей DDR5 RDIMM в обычном сервере легко потребляют в несколько раз больше. А в масштабах ИИ-фабрик, где счет идет на тысячи процессоров, каждый сэкономленный ватт превращается в мегаватты.
Второй аргумент — пропускная способность в пересчете на ядро. На каждое из 88 ядер Vera приходится около 14 ГБ/с, тогда как у 256-ядерных Venice и Diamond Rapids при сопоставимой суммарной пропускной способности получается лишь около 6 ГБ/с на ядро. Для задач, где каждое ядро активно работает с памятью, это серьезное преимущество.
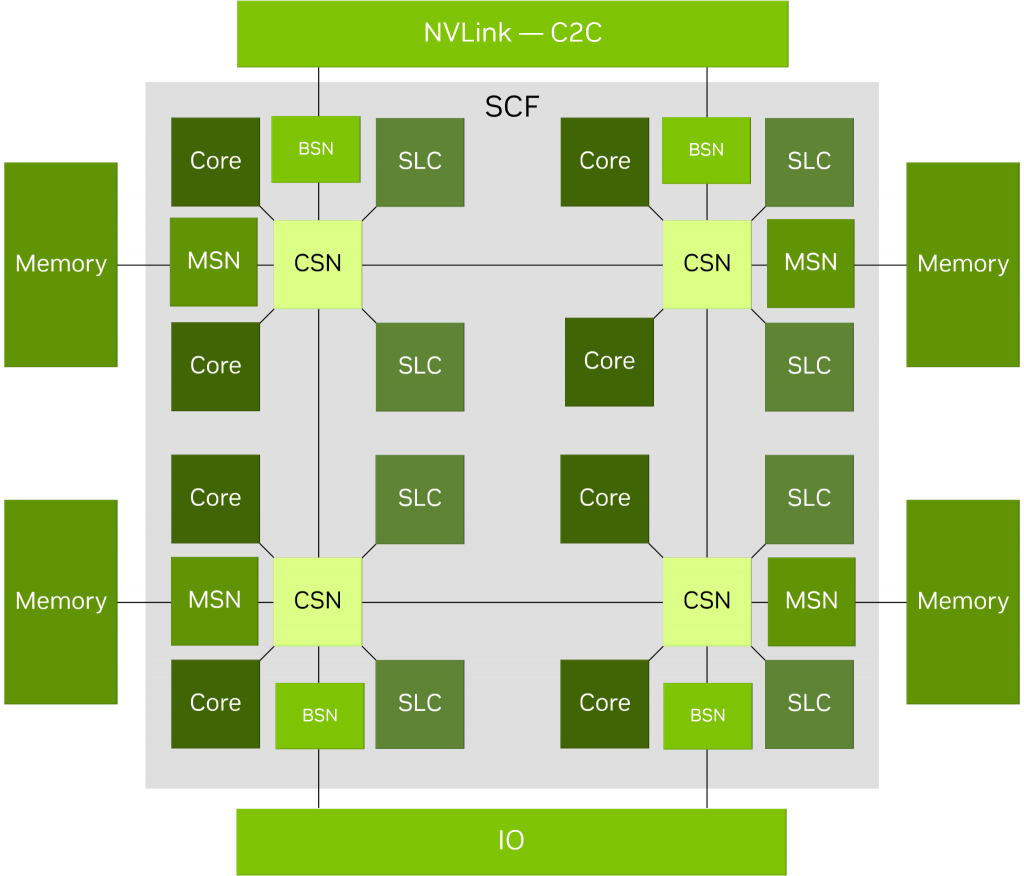
Архитектура сети и подсистемы памяти Nvidia Vera. Источник: .
Есть и обратная сторона. LPDDR5X не поддерживает такой же уровень коррекции ошибок, как серверные DDR5 RDIMM, которые способны пережить отказ целой микросхемы памяти. AMD в своем whitepaper по EPYC 9006 не упустила случая на это указать. Кроме того, 1,5 ТБ на сокет — это меньше, чем 4 ТБ у Venice, так что для самых больших баз данных в памяти Vera подойдет хуже.
I/O
А теперь разберем всю “периферийную” начинку чипов Vera, и во многом именно в ней раскрывается вся инновационность центральных процессоров Nvidia.
PCIe 6.0 и CXL 3.1
За ввод-вывод в Vera отвечает отдельный I/O-чиплет с поддержкой PCIe 6.0 и CXL 3.1. Количество линий зависит от системы: в серверах на одних только процессорах Vera доступно 88 линий PCIe 6.0 на сокет, а в составе платформы Vera Rubin — 96. Линии можно делить вплоть до x2 (бифуркация), что удобно для подключения большого количества NVMe-накопителей. В двухпроцессорном сервере набирается 176 линий PCIe 6.0. Для сравнения, у Venice SP7 в однопроцессорной конфигурации 96 линий, а у Diamond Rapids — 128. Так что по вводу-выводу Vera находится примерно на уровне флагманского EPYC, но уступает будущему Xeon. В ИИ-системах Nvidia это не так критично: значительная часть линий уходит на сетевые карты ConnectX, а с GPU процессор общается по другому каналу.
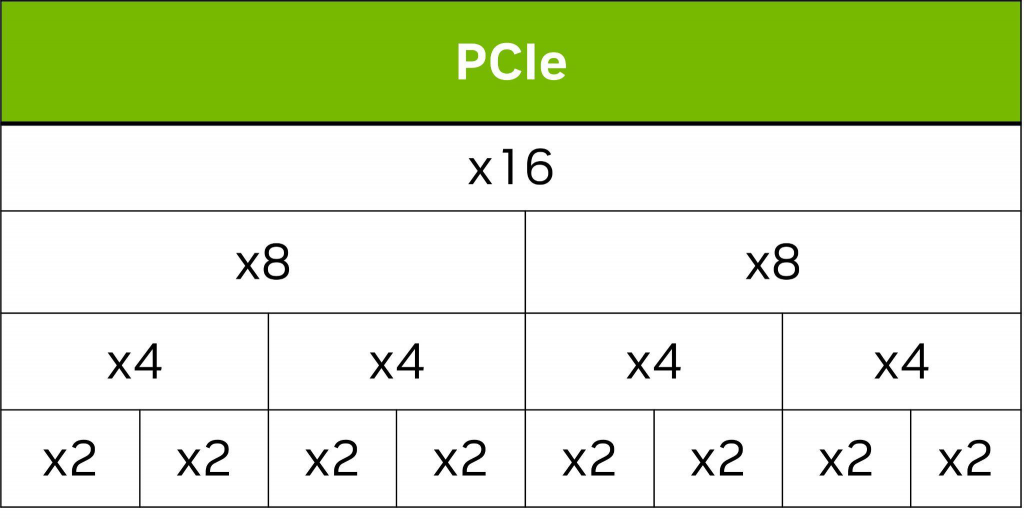
Схема бифуркации PCIe Nvidia Vera. Источник: .
NVLink-C2C
Этот канал — NVLink-C2C с пропускной способностью 1,8 ТБ/с, вдвое больше, чем у Grace. Через него Vera когерентно соединяется с ускорителями Rubin: GPU видит память процессора как продолжение своей собственной, а синхронизировать данные между ними вручную не нужно. Для сравнения, даже PCIe 6.0 x16 дает лишь около 256 ГБ/с в обе стороны. Тот же интерфейс используется и для связи двух процессоров Vera между собой. В двухсокетном сервере получается 176 ядер и 352 потока. Кроме того, NVLink-C2C — открытый для партнеров интерфейс, так что в теории к Vera можно подключить и чужие ускорители, если их производитель реализует поддержку этого протокола.
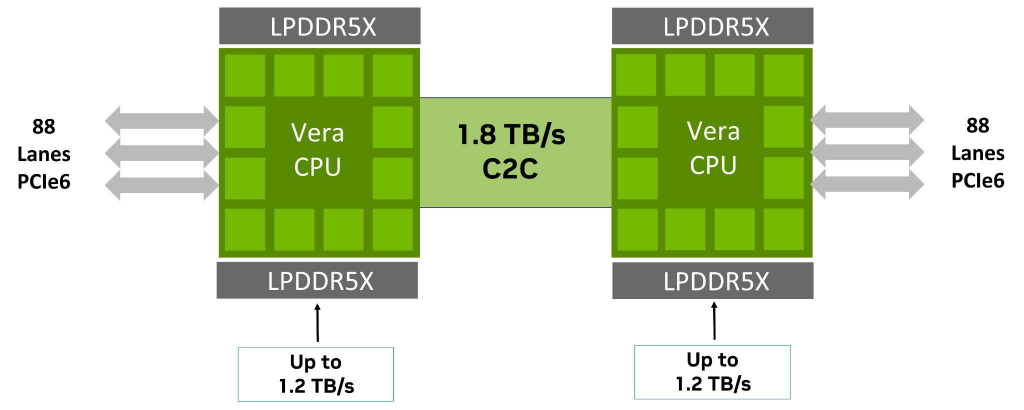
Схема работы двухсокетной конфигурации системы Nvidia Vera. Источник: .
Где будет работать Vera
В отличие от Grace, который продавался в основном в составе систем Nvidia, Vera изначально задуман как самостоятельный процессор для широкого круга серверов. Платформ на его основе будет сразу несколько:
- Vera Rubin NVL72 — флагманская стоечная система, в которой процессоры Vera через NVLink-C2C связаны с ускорителями Rubin. Именно здесь Vera выступает в своей "родной" роли хоста для GPU.
- HGX Rubin NVL8 — классические ИИ-серверы с восемью ускорителями Rubin, где Vera также может выступать хост-процессором.
- Vera CPU Rack — стойка с жидкостным охлаждением исключительно на процессорах Vera: до четырех узлов в лотке высотой 1U и до 256 процессоров на стойку, плюс DPU BlueField-4 и сетевые карты ConnectX. Такие системы рассчитаны на агентные нагрузки, аналитику и обучение с подкреплением, где нужно много быстрых CPU-ядер без видеокарт.
- Однопроцессорные и двухпроцессорные серверы от OEM- и ODM-партнеров Nvidia — для тех, кто хочет использовать Vera как обычный серверный процессор.
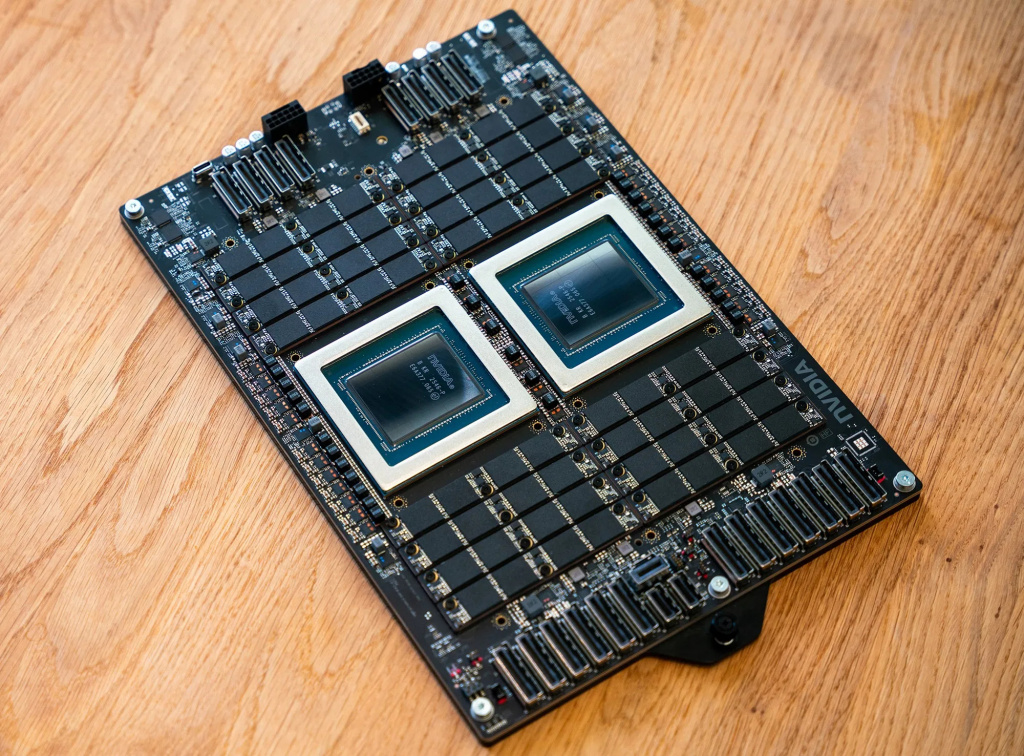
Вычислительный суперчип Nvidia Vera. Источник: .
По данным Nvidia, Vera уже находится в массовом производстве, а системы от партнеров, таких как Supermicro и Gigabyte, уже скоро поступят в продажу.
Производительность
На Hot Chips 2026 и различных партнерских демонстрациях Nvidia показала первые результаты тестирования Vera. Главным соперником она выбрала AMD EPYC 9755 — 128-ядерный процессор поколения Turin. Вот основные заявления компании:
- Однопоточная производительность. В тестах SPEC CPU 2026 Integer, которые измеряют скорость целочисленных вычислений на одном ядре, Vera опережает EPYC 9755 во всех без исключения подтестах. Это прямое подтверждение того, что Olympus проектировался как ядро с максимальной производительностью на такт.
- Агентные нагрузки. На подборке тестов SPEC, которые, по мнению Nvidia, лучше всего отражают работу ИИ-агентов, Vera быстрее x86-конкурента примерно в 1,8 раза, а на задачах обработки данных — в 1,5 раза. В изолированных песочницах, где агенты исполняют код, прирост достигает 50%.
- Масштабирование на графах. В алгоритме PageRank, который обходит графовую структуру данных, Vera на 32 ядрах работает в 29,3 раза быстрее, чем на одном, а у системы на EPYC прирост останавливается на уровне чуть выше 10 раз. Здесь как раз проявляют себя графовый префетчер и высокая пропускная способность памяти.
- Многопоточная производительность. В SPECrate 2026 Integer, где процессор нагружается на все ядра сразу, двухпроцессорная система на Vera набрала 925 баллов против 898 у системы на EPYC 9755 — преимущество всего 3%.
Последний пункт, к слову, Nvidia в своих слайдах предпочла не выпячивать, и неспроста. В официальной базе результатов SPEC уже есть системы на EPYC 9755 с компилятором AMD, набирающие более 1000 баллов, а системы на 192-ядерных Turin Dense — более 1200. Да и для однопоточных сравнений EPYC 9755 — не лучший выбор: у AMD есть высокочастотные модели с индексом F, которые разгоняются до 5 ГГц против 4,1 ГГц у 9755. Все результаты Vera при этом получены на предсерийных образцах и официально считаются оценочными, а данных о производительности в вычислениях с плавающей запятой Nvidia не публиковала вовсе.
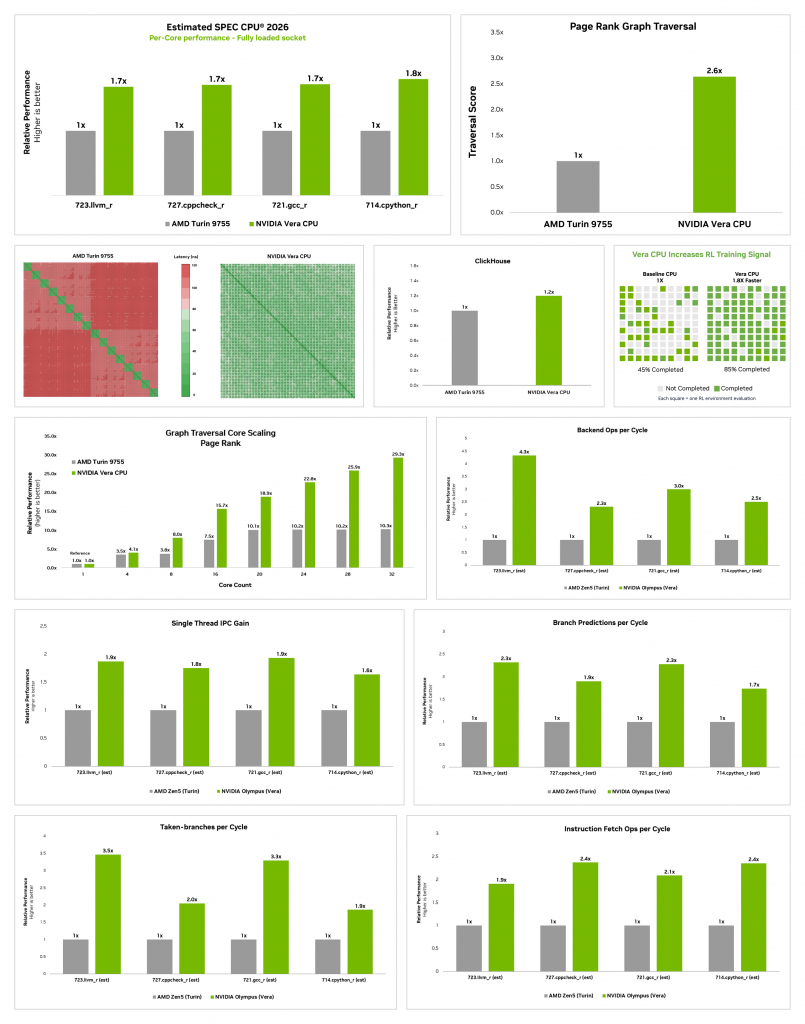
Результаты тестирования Nvidia Vera. Источник: .
Что Nvidia пока не рассказала
Несмотря на подробный whitepaper и доклад на Hot Chips, ряд ключевых характеристик Vera официально не раскрыт:
- Тактовые частоты. Ни базовой, ни максимальной частоты ядер Olympus Nvidia не называет, поэтому оценить, сколько производительности дает архитектура, а сколько — частота, пока невозможно.
- Техпроцесс. Официально Nvidia не подтвердила, по какой технологии TSMC выпускаются кристаллы Vera.
- Детали ядра. Размер буфера переупорядочивания и регистровых файлов не раскрыт, как и то, может ли один поток в Spatial Multithreading занимать простаивающие ресурсы второго.
- Производительность с плавающей запятой. Результатов SPEC CPU 2026 Floating Point Nvidia не публиковала.
Есть и вопрос, который касается не самого процессора, а экосистемы. Vera — это Arm, а значит, x86-приложения без перекомпиляции на нем не запустятся. Для облаков и ИИ-компаний, которые давно собирают софт под Arm, это не проблема, но для корпоративных заказчиков с большим парком x86-приложений переход на Vera может обернуться заметными затратами на миграцию.
Выводы
Vera — это не попытка Nvidia обыграть Intel и AMD на их же поле. Вместо того чтобы гнаться за количеством ядер, зеленые создали процессор с другой философией: 88 широких ядер Olympus с высокой производительностью на такт, многопоточность со статическим разделением ресурсов ради предсказуемых задержек, монолитный вычислительный кристалл без NUMA-доменов, экономичная память LPDDR5X с рекордной пропускной способностью на ядро и когерентный канал к GPU на 1,8 ТБ/с. Все это заточено под одну задачу — как можно быстрее выполнять цепочки действий ИИ-агентов и не давать простаивать дорогим ускорителям Rubin. Когда серверы на Nvidia Vera станут доступны для заказа, ServerFlow обязательно включит их в свой ассортимент. А пока вы можете подобрать в нашем интернет-магазине GPU-серверы и платформы на Intel Xeon и AMD EPYC.
