Intel Diamond Rapids — разбор грядущих 256-ядерных CPU Xeon 7
Введение
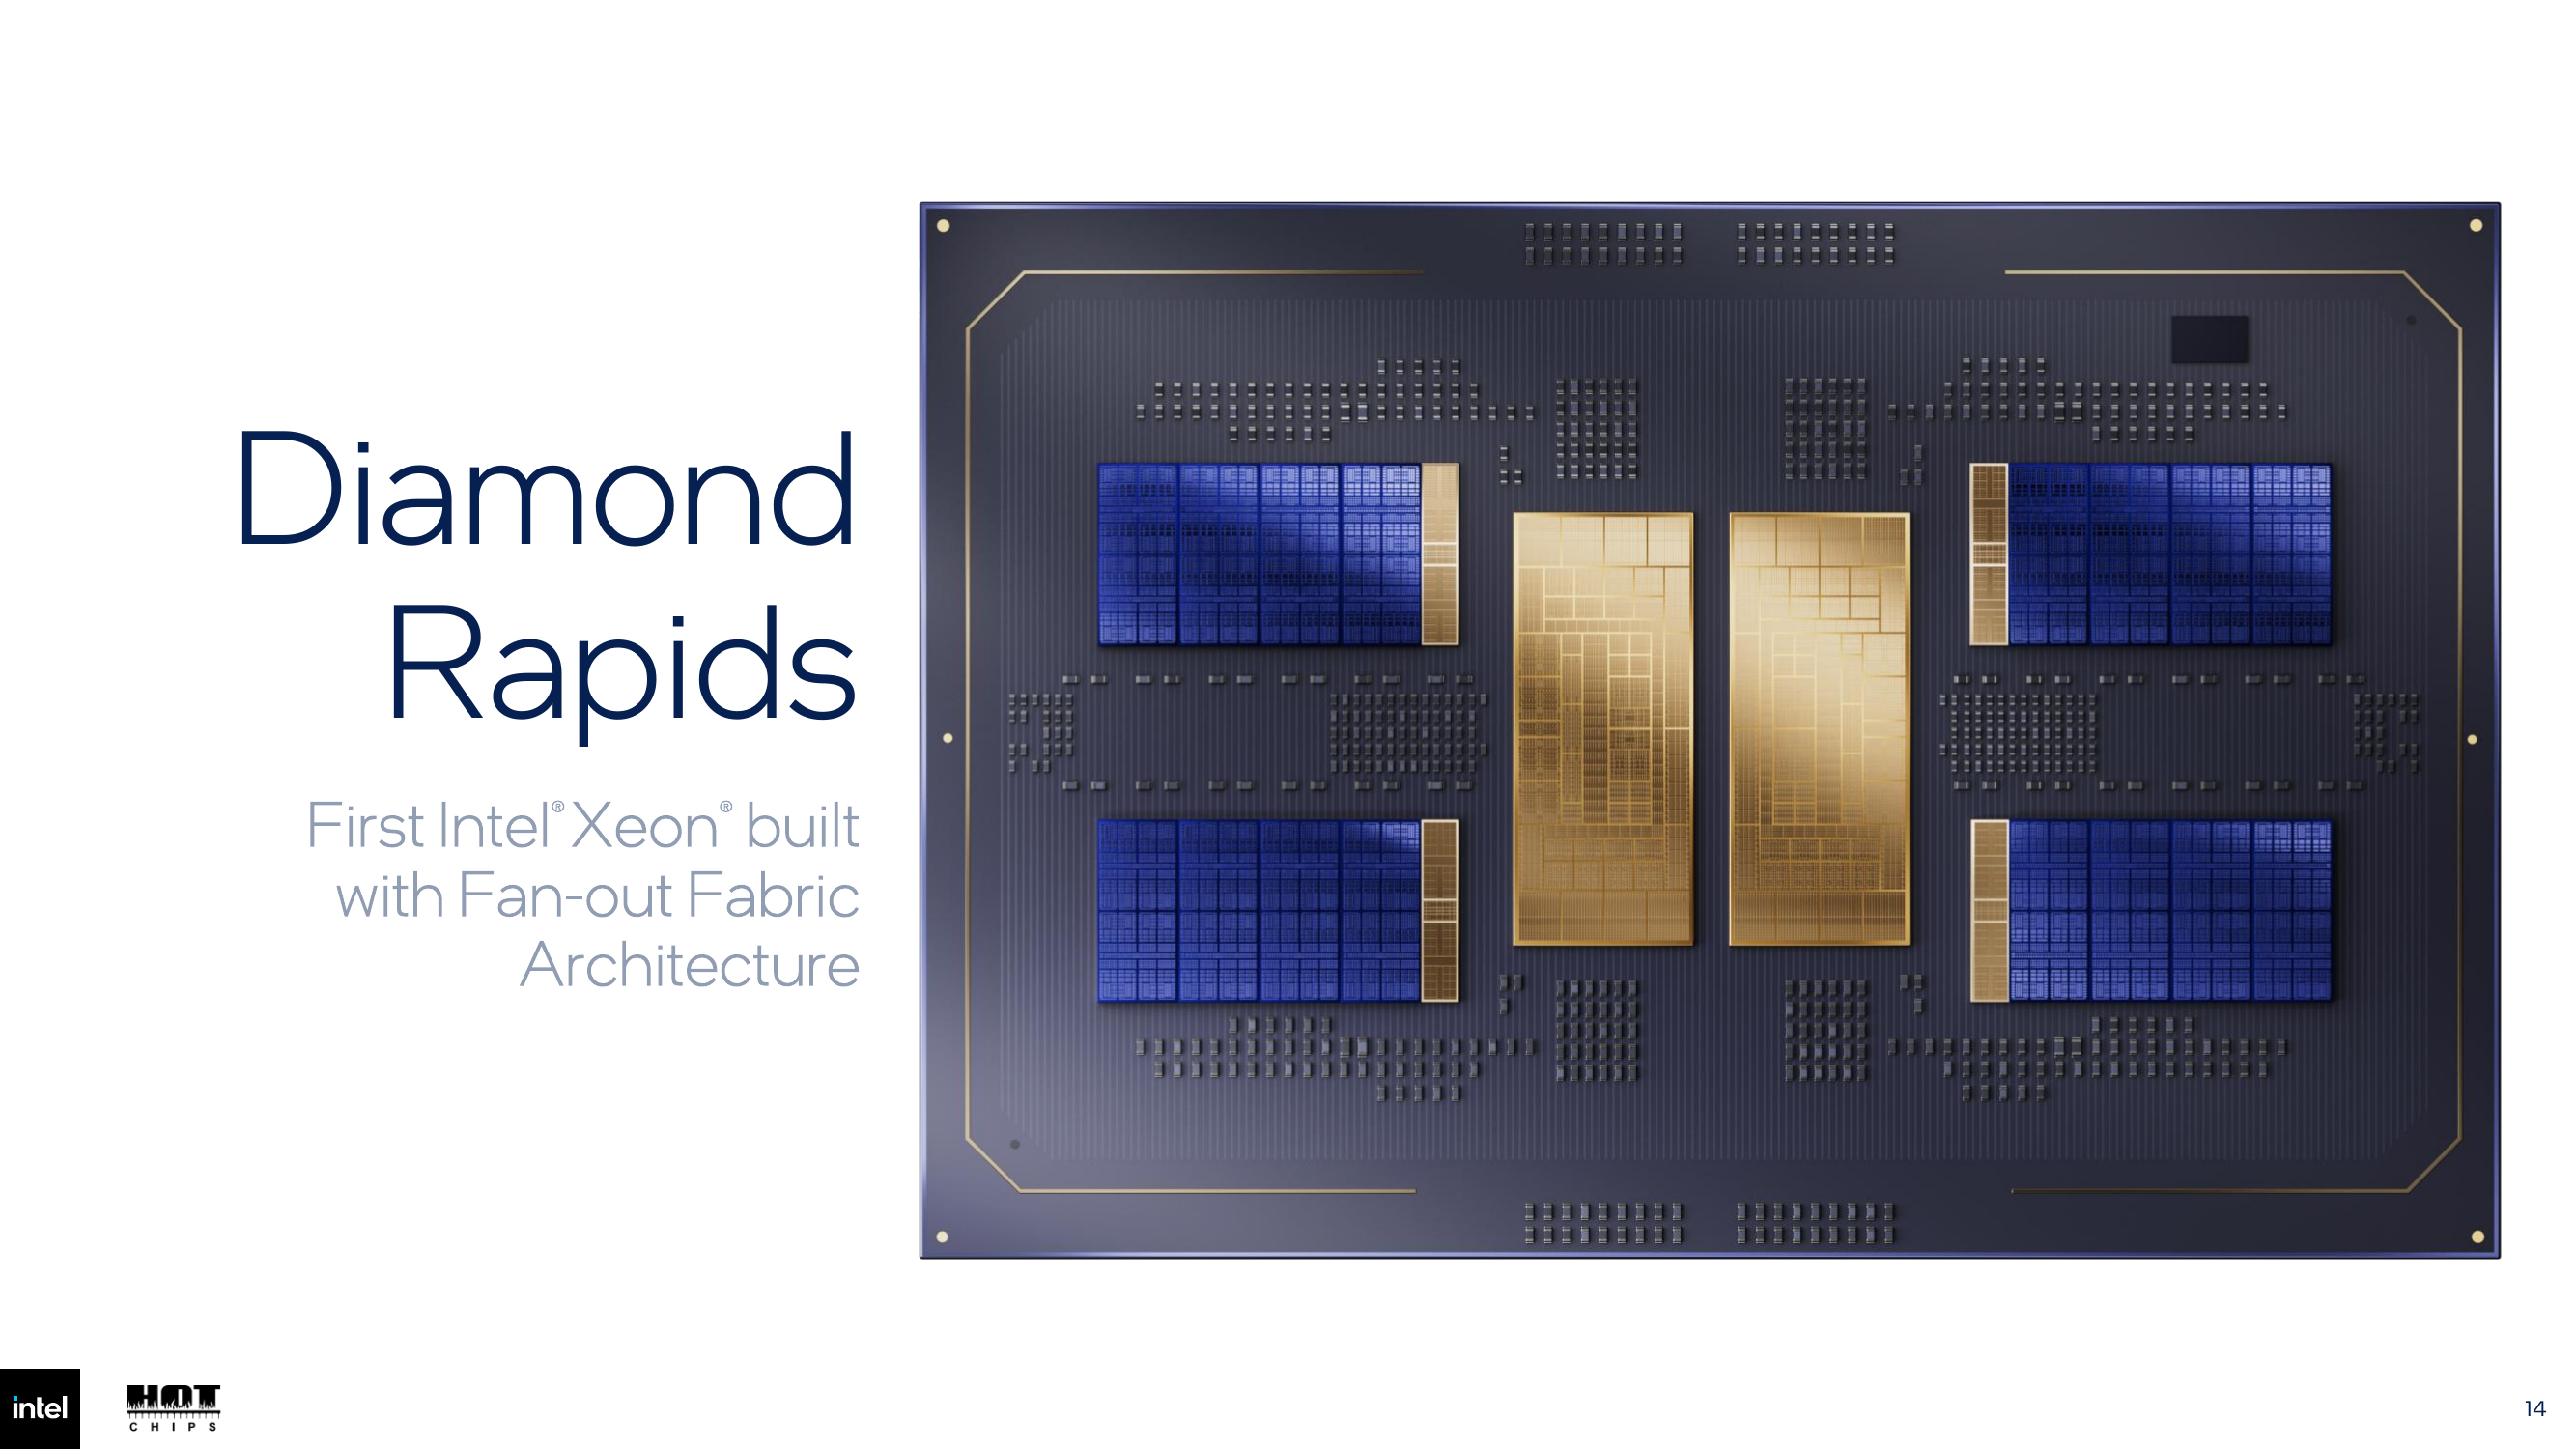
Пока AMD уже вовсю отгружает 256-ядерные EPYC Venice, а Nvidia примеряет на себя роль процессорного вендора со своим Vera, Intel решила, что пора раскрыть карты. На конференции Hot Chips 2026 Кришнакант Систла, главный инженер компании по серверным CPU, представил Xeon 7 Diamond Rapids — новейшее поколение серверных процессоров Intel, которое выйдет в 2027 году. И цифры на слайдах такие, что поначалу хочется протереть глаза: 256 производительных ядер, 1,28 ГБ кэша последнего уровня, 16 каналов DDR5-памяти с пропускной способностью 1,6 ТБ/с и 128 линий PCIe 6.0. И дело не только в цифрах — Intel буквально вывернула свои процессоры наизнанку, построив Xeon 7 на новой архитектуре Fan-out Fabric: ядра уехали на края подложки, а память и ввод-вывод собрались в центре. По сути, синие впервые со времен перехода на чиплеты перестраивают Xeon практически с нуля, и этот апдейт определенно стоит вашего внимания. В этой статье специалисты компании ServerFlow подробно раскроют все особенности Xeon 7 Diamond Rapids, расскажут, как они устроены, и объяснят, о чем Intel решила умолчать.
Fan-out Fabric
Главная новинка Diamond Rapids — архитектура Fan-out Fabric, которую Intel без скромности называет "трансформационной". Она держится на четырех китах:
- Масштабируемые вычислительные блоки (Compute Building Blocks, CBB) — модули с ядрами, их L2-кэшем и общим LLC.
- Централизованные память и ввод-вывод в Fabric Hub — все контроллеры DDR, линии PCIe и ускорители собраны в отдельных хабах.
- Единая фабрика памяти (Unified Memory Fabric) — подсистема, отвечающая за контроллеры памяти, шифрование и когерентность.
- Гибкая фабрика ввода-вывода (Flexbus I/O Fabric) — линии, которые можно конфигурировать под разные протоколы.
Топология выглядит так: в центре подложки стоят два Fabric Hub, а вокруг них "веером" расходятся четыре CBB — два сверху и два снизу. Отсюда и название fan-out. Важный нюанс: каждый CBB подключен сразу к обоим хабам, поэтому любое ядро имеет прямой путь к любому контроллеру памяти и любому порту ввода-вывода.
А теперь сравните это с Granite Rapids. В Xeon 6 контроллеры памяти сидят прямо на вычислительных тайлах вместе с ядрами, вычислительные тайлы занимают центр подложки, а тайлы ввода-вывода прижаты к ее краям. В Diamond Rapids все ровно наоборот: ядра уехали на периферию, а память и I/O собрались в центре. Знакомая картина? Еще бы — это очень похоже на подход AMD с ее CCD-чиплетами вокруг центрального IOD, так что синие в каком-то смысле признали правоту красных.
Но полной копией EPYC чипы Diamond Rapids назвать нельзя. У AMD кэш L3 заложен прямо в чиплеты, а у Intel огромный LLC вынесен в отдельный базовый тайл под ядрами, и один такой кэш делят между собой 64 ядра. Кроме того, у перестановки есть и чисто физический бонус: самые горячие элементы (ядра) теперь стоят по краям корпуса, откуда тепло отводить проще.
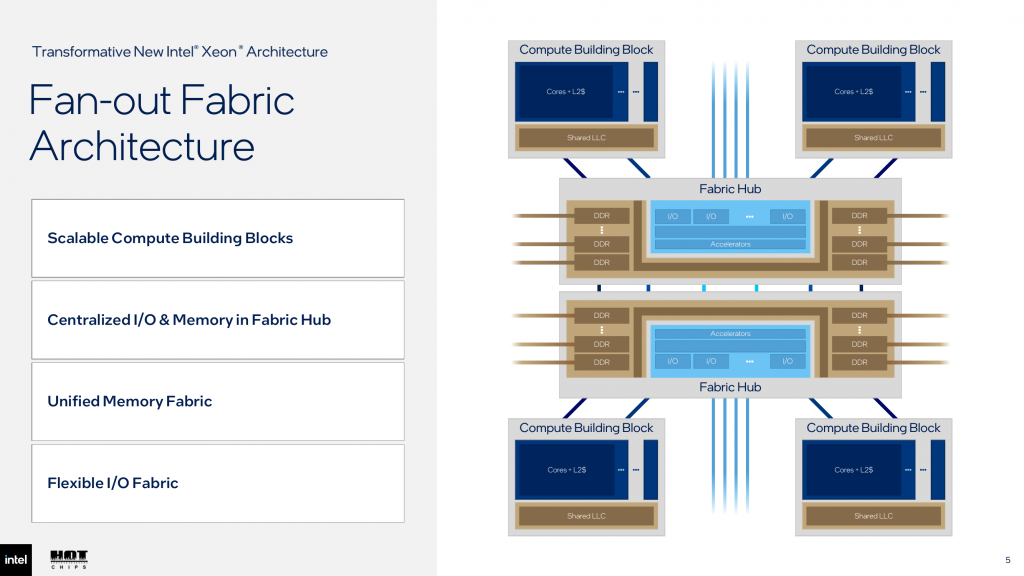
Архитектура Fan-Out Fabric в центральных процессорах Intel Xeon 7 Diamond Rapids. Источник: .
Compute Building Block
Теперь заглянем внутрь вычислительного блока. CBB — это двухэтажная конструкция:
- Верхний этаж — вычислительные чиплеты. В каждом до 16 P-ядер Panther Cove, у каждого ядра собственный L2-кэш. Здесь же расположен интерфейс 3D Xbar.
- Нижний этаж — базовый тайл. В нем находится общий LLC, агент кэширования (Caching Agent) со snoop-фильтром и die-to-die интерфейс для связи с Fabric Hub.
- 3D Xbar — вертикальная перекрестная коммутация, которая соединяет ядра каждого чиплета с кэшем на базовом тайле прямо сквозь гибридное соединение. Это уже точно не перевыпуск Skylake.
Важная деталь, которую подчеркивает Intel: архитектура масштабируется сразу в двух измерениях. Можно менять количество ядерных чиплетов на одном базовом тайле и количество CBB на одном процессоре. Проще говоря, из одних и тех же "кубиков" Intel может собрать целую линейку процессоров — от относительно скромных моделей до флагмана.
Во флагманской конфигурации чип получит:
- 4 CBB x 4 чиплета x 16 ядер = 256 ядер;
- 1,28 ГБ LLC / 4 базовых тайла = 320 МБ кэша на один CBB из 64 ядер;
- 320 МБ / 64 ядра = 5 МБ LLC на ядро.
Для сравнения, у Xeon 6980P на 128 ядер Redwood Cove приходится 504 МБ L3, то есть около 3,9 МБ на ядро. А у Xeon 6+ Clearwater Forest 576 МБ LLC делятся на 288 E-ядер, что дает лишь 2 МБ на ядро. Так что Diamond Rapids не просто удваивает количество P-ядер относительно Granite Rapids, но и заметно щедрее раздает кэш каждому из них. Для баз данных, аналитики и ИИ-агентов с большим рабочим набором данных это весьма приятный бонус.
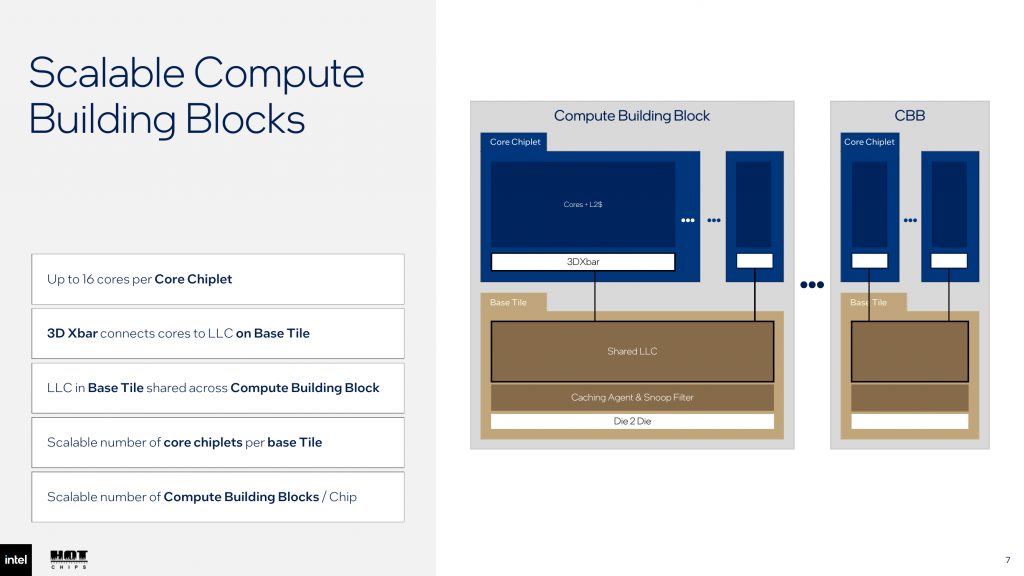
Архитектура вычислительных блоков Xeon 7 Diamond Rapids. Источник: .
Fabric Hub и Unified Memory Fabric
В Xeon 7 два Fabric Hub, и каждый объединяет в себе две большие подсистемы: фабрику ввода-вывода Flexbus и единую фабрику памяти. Судя по схеме, у каждого хаба шесть die-to-die интерфейсов: через них он связан со всеми четырьмя CBB и с соседним хабом.
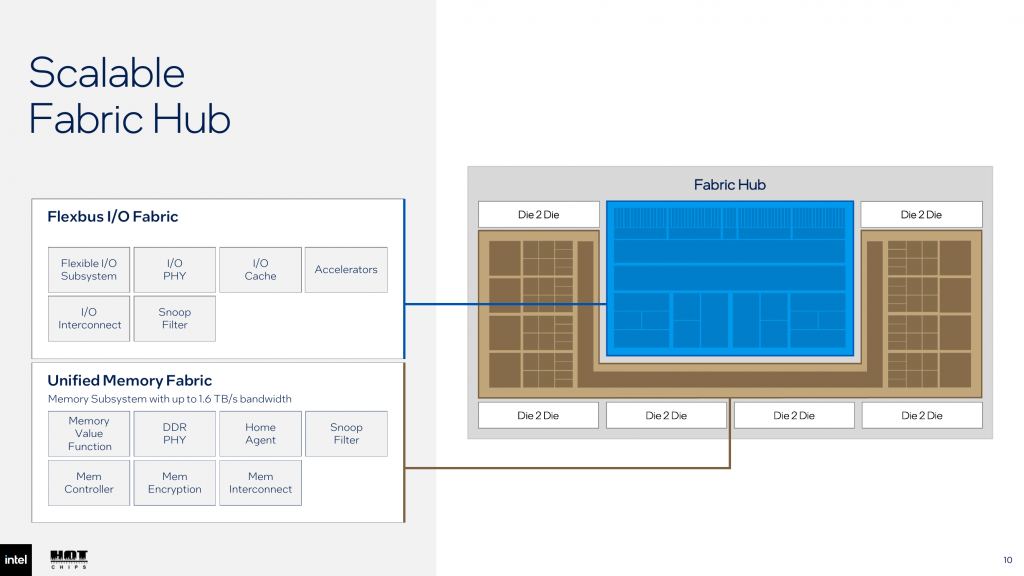
Архитектура Fabric Hub. Источник: .
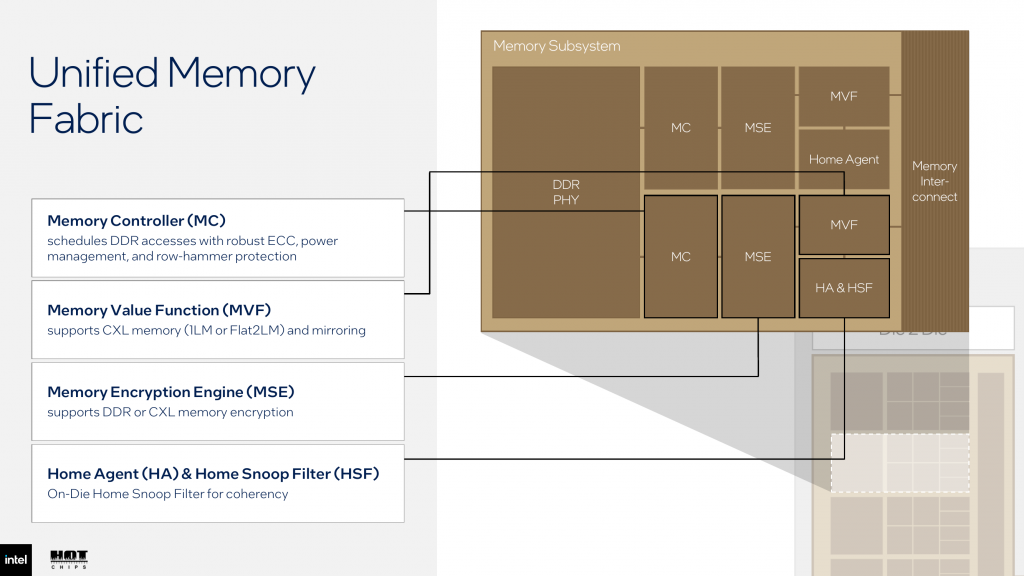
Unified Memory Fabric
Начнем с фабрики памяти. Diamond Rapids поддерживает 16 каналов DDR5 (по 8 на каждый хаб) со скоростью до 8000 MT/s для обычных модулей и до 12 800 MT/s для MRDIMM.
- 16 каналов x 12 800 MT/s x 8 байт = 1,64 ТБ/с с MRDIMM — отсюда и заявленные 1,6 ТБ/с;
- 16 каналов x 8000 MT/s x 8 байт = 1 ТБ/с с обычной DDR5.
Для сравнения, флагманский Xeon 6 с 12 каналами MRDIMM-8800 выдает около 845 ГБ/с, а Xeon 6+ с 12 каналами DDR5-8000 (MRDIMM он не поддерживает) — около 768 ГБ/с. То есть Diamond Rapids почти вдвое увеличивает пропускную способность памяти относительно обоих предшественников.
Теперь пройдемся по блокам единой фабрики памяти:
- Memory Controller (MC) — планирует обращения к DDR, отвечает за устойчивую ECC-коррекцию, управление питанием памяти и защиту от атак row-hammer.
- Memory Value Function (MVF) — поддерживает CXL-память в режимах 1LM (CXL-модули видны как отдельный уровень памяти) и Flat2LM (DDR и CXL объединяются в плоское адресное пространство), а также зеркалирование памяти.
- Memory Encryption Engine (MSE) — шифрует данные как в DDR, так и в CXL-памяти.
- Home Agent (HA) и Home Snoop Filter (HSF) — отвечают за когерентность, причем snoop-фильтр теперь живет прямо на кристалле.
Flexbus I/O Fabric
Вторая половина Fabric Hub — фабрика ввода-вывода Flexbus. И здесь, пожалуй, прячется одно из самых практически значимых изменений всего Diamond Rapids.
- I/O PHY — по 4 порта x16 высокоскоростных линий на каждый хаб, то есть 128 линий на процессор. Плюс еще по 4 линии PCIe 4.0 на хаб (всего 8) для платформенной инфраструктуры: BMC, загрузочных накопителей и прочей служебной периферии.
- Flexible I/O Subsystem — каждый порт x16 может работать как PCIe 6.0, CXL 3 или UPI 3, а также в комбинациях этих протоколов.
- I/O-кэш и фильтрация — до 16 МБ I/O-кэша со встроенным snoop-фильтром и агентом кэширования для поддержания когерентности с периферией.
- Комплексы ускорителей — в каждом хабе по два комплекса с Intel QAT (шифрование и сжатие), Intel DSA (перемещение данных) и Intel IAA (аналитика и распаковка данных в памяти).
PCIe 6.0 работает на скорости 64 GT/s, то есть около 8 ГБ/с на линию в каждую сторону. Умножаем на 128 линий и получаем около 1 ТБ/с в каждом направлении, или те самые до 2 ТБ/с двунаправленной пропускной способности, которыми хвастается Intel. У Xeon 6 и Xeon 6+ было 96 линий PCIe 5.0, из которых 64 поддерживали CXL 2.0. То есть Diamond Rapids дает на треть больше линий, и каждая из них при этом вдвое быстрее. Это очень пригодится GPU-серверам: 128 линий позволяют подключить 8 ускорителей по x16 к одному процессору напрямую, без PCIe-свичей, собирая полноценную Single-root топологию. Правда, в таком случае все линии уйдут под видеокарты, и для сетевых карт и NVMe-накопителей свичи или второй сокет все равно понадобятся.
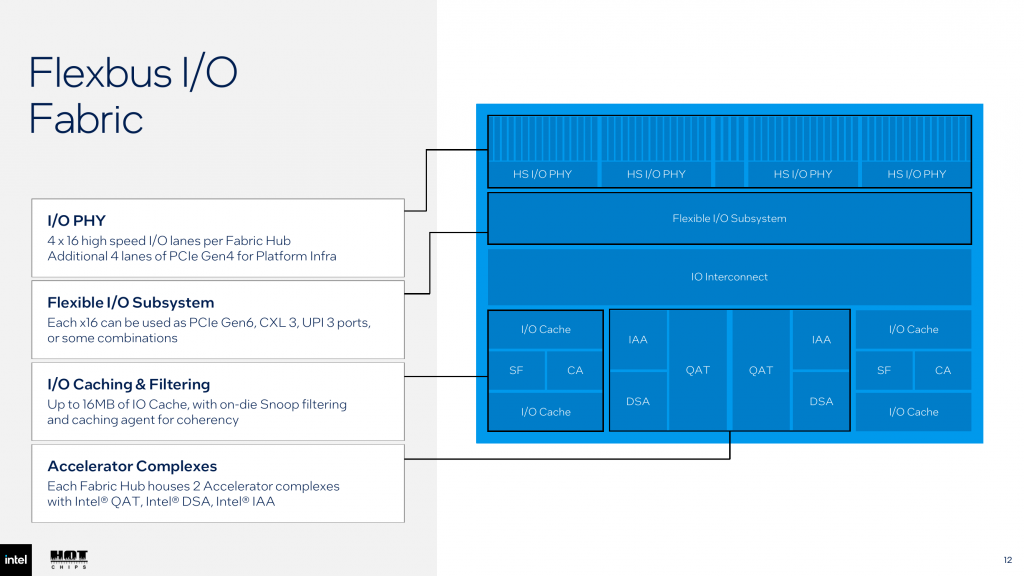
Фабрика ввода-вывода Flexbus Intel Xeon 7. Источник: .
Кстати, в нашей статье о Single-root и Dual-root серверах мы рассказывали, что у Xeon 6 межпроцессорный интерконнект UPI работает по выделенным линиям и не отнимает линии PCIe, чего нет у AMD с xGMI-линками. Так вот, если судить по слайду Intel, в Diamond Rapids UPI 3 переезжает на те же универсальные порты x16, что и PCIe с CXL. Это значит, что в двухсокетной системе часть из 128 линий придется отдать под межпроцессорные связи, как это происходит у AMD. Зато появляется гибкость: производитель платформы сам решает, сколько портов отдать под UPI, а сколько под периферию. Главное преимущество Xeon в двухсокетных конфигурациях, похоже, уходит в прошлое, но подтвердится ли это на выходе чипов — узнаем в 2027 году.
Питание
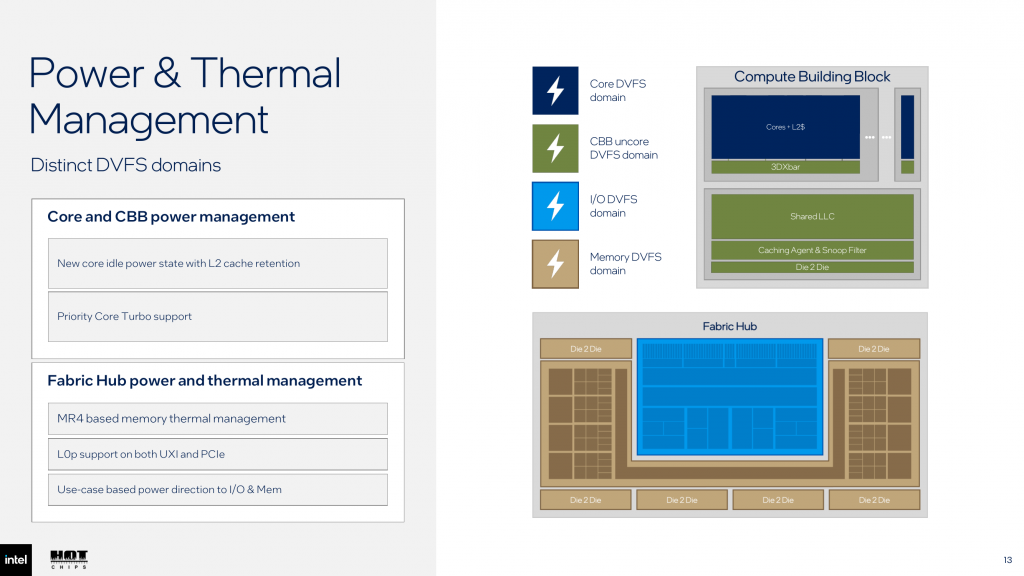
Когда на одной подложке уживаются 256 ядер, гигабайт кэша и 16 каналов памяти, управлять энергопотреблением одной ручкой уже не получится. Поэтому Intel разбила Diamond Rapids на четыре независимых DVFS-домена (Dynamic Voltage and Frequency Scaling), в каждом из которых частота и напряжение регулируются отдельно:
- Домен ядер — сами P-ядра с их L2-кэшем.
- Домен uncore в CBB — 3D Xbar, общий LLC, агент кэширования и die-to-die интерфейсы.
- Домен ввода-вывода — Flexbus I/O Fabric в Fabric Hub.
- Домен памяти — Unified Memory Fabric с контроллерами DDR.
Представьте типичную ситуацию: сервер гоняет базу данных, которая упирается в память, а ядра при этом наполовину простаивают. Раньше процессору пришлось бы держать высокие частоты для всей системы, а теперь он может понизить частоту ядер и перебросить сэкономленный бюджет мощности на память и ввод-вывод.
На уровне ядер и CBB Intel добавила две функции:
- Новое состояние простоя ядра с сохранением L2-кэша — уснувшее ядро не теряет содержимое своего L2, поэтому после пробуждения ему не нужно заново подтягивать данные из LLC или памяти. Для нагрузок с короткими всплесками активности, вроде микросервисов или ИИ-агентов, которые то ждут ответа от GPU, то снова начинают работать, это заметно сокращает задержки.
- Priority Core Turbo — поддержка повышенных частот для выбранных приоритетных ядер. Эта функция уже появлялась в Xeon 6 для хост-процессоров GPU-систем, так что здесь Intel скорее переносит проверенную фишку в новое поколение.
На уровне Fabric Hub появились:
- Тепловое управление памятью на основе MR4 — процессор считывает температуру DRAM из регистра MR4 модулей DDR5 и регулирует частоту обращений, чтобы модули не перегревались.
- Поддержка L0p на линках UXI и PCIe — режим, в котором линк сокращает число активных линий при низкой нагрузке, не разрывая соединения. Это экономит энергию без заметных задержек на повторное установление связи.
Техпроцессы и упаковка
С архитектурой более-менее разобрались, осталось понять, из чего Diamond Rapids состоит физически. Полная конфигурация включает 22 кристалла трех типов:
|
Кристалл |
Количество |
Техпроцесс |
Что внутри |
|
Вычислительный чиплет |
16 |
По 16 P-ядер Panther Cove с L2 | |
|
Базовый тайл |
4 |
Intel 3-T |
LLC, агент кэширования, snoop-фильтр |
|
Fabric Hub |
2 |
Intel 3 |
Контроллеры памяти, PCIe/CXL/UPI, ускорители |
Для соединения всего этого хозяйства Intel использует два метода:
- Hybrid Bonding Interface (HBI) на базе Foveros Direct 3D — гибридное соединение медь-медь без микробампов, которым ядерные чиплеты крепятся прямо к базовым тайлам. Именно через него работает 3D Xbar. Технология уже обкатана на Xeon 6+ Clearwater Forest.
- Die-to-die интерфейс на медных линках в подложке (UCIe-S) — стандартный UCIe в варианте для обычной органической подложки, которым базовые тайлы связаны с Fabric Hub.
Любопытно, что Intel, похоже, отказалась от своей фирменной упаковки EMIB (Embedded Multi-die Interconnect Bridge), на котором держались Sapphire Rapids, Granite Rapids и даже Clearwater Forest. На сессии вопросов Intel объяснила, что дело в расстояниях. Вариант UCIe-A для продвинутой упаковки потребовал бы нескольких "прыжков" между кристаллами, а UCIe-S обеспечивает одинаково низкие задержки от любого CBB до обоих хабов, даже на больших расстояниях.
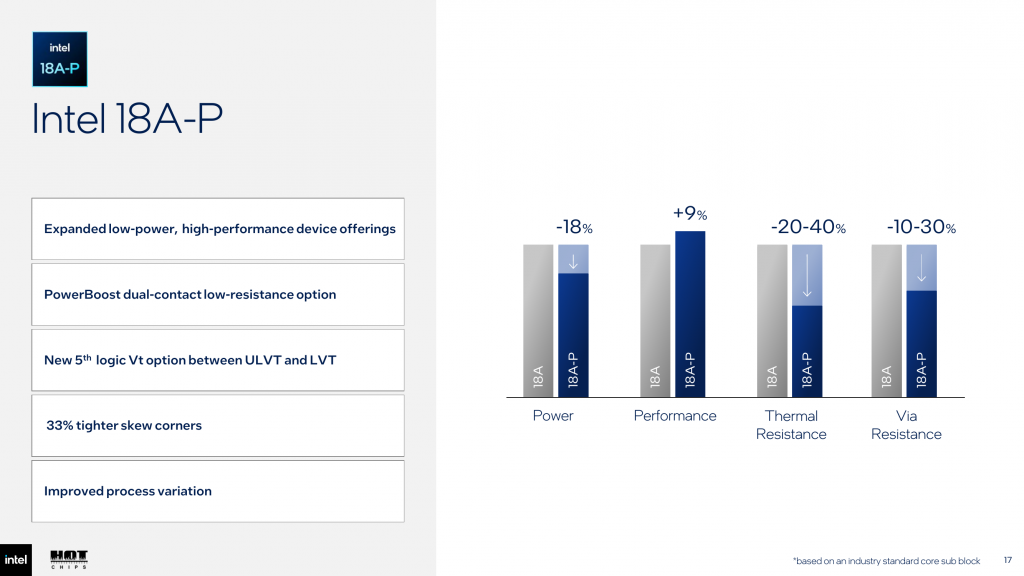
Характеристики техпроцесса Intel Xeon 7 Diamond Rapids. Источник: .
ISA: APX, AVX10.2, AMX
Про микроархитектуру ядер Panther Cove Intel на Hot Chips не рассказала практически ничего, но один слайд все-таки посвятила набору инструкций. И для разработчиков это, пожалуй, самая осязаемая новинка всего Diamond Rapids.
Intel APX
Intel Advanced Performance Extensions, или APX, — самое серьезное расширение базовой архитектуры x86-64 за многие годы. Анонсировали его еще в 2023 году, и Diamond Rapids станет первым Xeon с его поддержкой. Intel описывает APX как трехуровневую конструкцию:
- Новое состояние. Количество регистров общего назначения удваивается с 16 до 32, для регистров r16-r31 введена новая кодировка инструкций.
- Новые возможности на его основе. Трехоперандные инструкции NDD (результат пишется в отдельный регистр, не затирая исходные операнды), подавление установки флагов и поддержка сохранения расширенного состояния через XSAVE.
- Новые инструкции. Оптимизированные инструкции сохранения и восстановления регистров (spill/fill), условные инструкции и 64-битный абсолютный переход.
Звучит сложно, но суть простая. Когда у компилятора всего 16 регистров, ему постоянно приходится выгружать промежуточные значения в память и затем читать их обратно. 32 регистра резко сокращают эту беготню: по данным Intel, код с APX выполняет примерно на 10% меньше операций загрузки и на 20% меньше операций записи. Intel подчеркивает, что для прироста производительности достаточно перекомпилировать программу, менять исходный код не нужно. А старый x86-код продолжит работать как раньше.
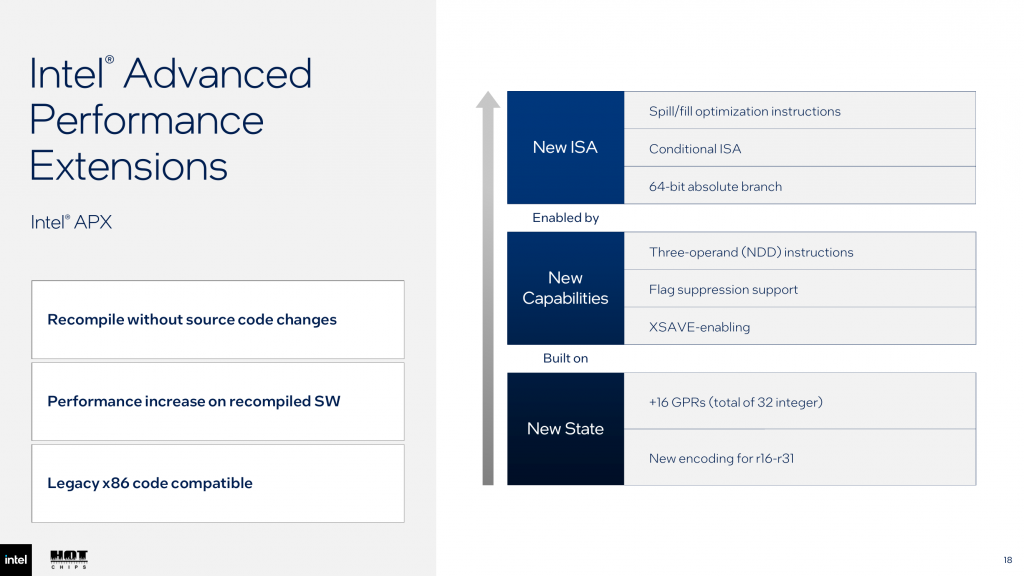
Расширение команд Intel APX. Источник: .
AVX10.2 и AMX
Векторные и матричные расширения тоже подтянули:
- AVX10.2 приходит на смену AVX10.1 из Granite Rapids. AVX10 — это новая унифицированная версия AVX-512, которую Intel развивает как единый векторный стандарт для всех своих ядер. У Xeon 6+ Clearwater Forest, к слову, AVX-512 нет вовсе, только AVX2 с VNNI.
- AMX и AVX10.2 с поддержкой FP8, FP16 и BF16. В Granite Rapids AMX работал с INT8, BF16 и FP16, а теперь к списку добавился FP8 — формат, ставший стандартом де-факто для инференса современных LLM.
Для локального инференса небольших моделей прямо на процессоре, без видеокарты, поддержка FP8 в AMX — весьма ценное дополнение. Особенно если вспомнить про 1,6 ТБ/с пропускной способности памяти, которые, как мы уже посчитали, дают процессору вполне приличный потолок в фазе decode.
Что осталось за кадром
Ну Intel не была бы Intel, если бы сразу выложила весь расклад. При всей подробности, в слайдах нет ни одного бенчмарка, а за кадром осталось немало важных вопросов и недоговорок.
- Нет Hyper-Threading. На слайдах об этом ни слова, но Intel подтвердила отсутствие SMT в Diamond Rapids по ходу Hot Chips. Для P-ядерного серверного процессора это смелое решение: у AMD EPYC Venice те же 256 ядер дают 512 потоков. Вернуть многопоточность в Xeon Intel обещает только в следующем поколении, Coral Rapids. Забавно, что даже в топовых ARM-CPU Nvidia Vera будет технология многопоточности, а у Intel, которая изобрела эту технологию, такой фишки не будет.
- Нет TDP, частот, сокета и модельного ряда. Судя по размерам подложки и 256 ядрам, тепловыделение флагмана вряд ли окажется ниже, чем у Granite Rapids-AP с его 500 Вт, но это пока лишь предположение. Ранние утечки и спецификации для 192-ядерных версий указывали на TDP 500 Вт, поэтому у топового 256-ядерного чипа можно смело прибавить 150 Вт.
- Неясны задержки. Как огромный LLC, разнесенный по четырем CBB, и линки UCIe-S на подложке поведут себя с точки зрения задержек при обращении к "чужому" кэшу или удаленному хабу памяти — большой вопрос.
Отдельно стоит сказать о сроках и конкурентах. Изначально Diamond Rapids ожидали раньше, но в начале года Intel сдвинула запуск на 2027 год. Более того, еще на Computex флагман обещал 192 ядра, и лишь к Hot Chips цифра выросла до 256, что вывело Intel на паритет по ядрам с AMD Venice. Проблема в том, что Venice скоро появятся в продаже, а Diamond Rapids появится только в следующем году. К тому моменту AMD успеет занять немалую часть рынка, а рядом с x86 все увереннее чувствуют себя Arm-процессоры вроде Nvidia Vera.
Выводы
Презентации и слайды это, конечно, хорошо, но верить Intel наслово будет очень опрометчиво — на бумаге все может выглядеть идеально, а на практике…А на практике узнаем только на релизе процессоров и при выходе первых тестов. Но уже можно сделать вывод, что Xeon 7 Diamond Rapids — это очередная попытка Intel изо всех сил угнаться за AMD: аналогичное количество ядер, аналогичный большой кэш, аналогичное количество каналов памяти и заявления, что у нас обязательно будет эффективнее, чем у красных. Но для Intel это, так или иначе, будет огромным скачком, который уменьшит отставание компании после затяжного кризисного периода.
