Nvidia DGX Spark или AMD Ryzen AI Max+ 395: какой мини-ПК для локальных LLM выбрать?
Введение
Локальный запуск искусственного интеллекта в современности перестал быть развлечением закаленных ИИ-гиков с GPU-серверами и мощными ИИ-ускорителями — на рынок вышли системы, которые умещаются буквально в углу рабочего стола, но способные тянуть модели на десятки или даже сотни миллиардов параметров. Эти устройства получили лаконичное название “ИИ-ПК”, на полную эксплуатирующие концепцию унифицированной памяти и эффективно миксующие мощности CPU, GPU, а иногда и NPU, в едином корпусе. Такую перспективную нишу сразу же заняли две акулы ИИ-бизнеса: Nvidia со своим “эталонным” DGX Spark GB10 и AMD с недавно выпущенной Ryzen AI Halo. И многие юзеры встали в ступор — а что же выбрать? С одной стороны, CUDA, FP4 и 128 ГБ памяти, но за раздутый прайс. С другой стороны — бюджетный ценник, отличная производительность и все те же 128 ГБ. Сложный вопрос, не правда ли? Вовсе нет, ведь в этой статье специалисты компании ServerFlow разберут по винтикам два топовых ИИ-ПК, расскажут об их плюсах и минусах, подробно опишут характеристики и, конечно же, расскажут о платформах-аналогах.
Что такое Nvidia DGX Spark
Nvidia DGX Spark, анонсированный на GTC 2025, — это устройство, которое и породило сам термин компактных “ИИ-ПК”, и ставшее прямым развитием корпоративных DGX-систем, но в настольном формате. По сути, перед нами полноценная ИИ-фабрика в миниатюре, ведь в ней все спроектировано для достижения максимальной ИИ-производительности локального ИИ-инференса.
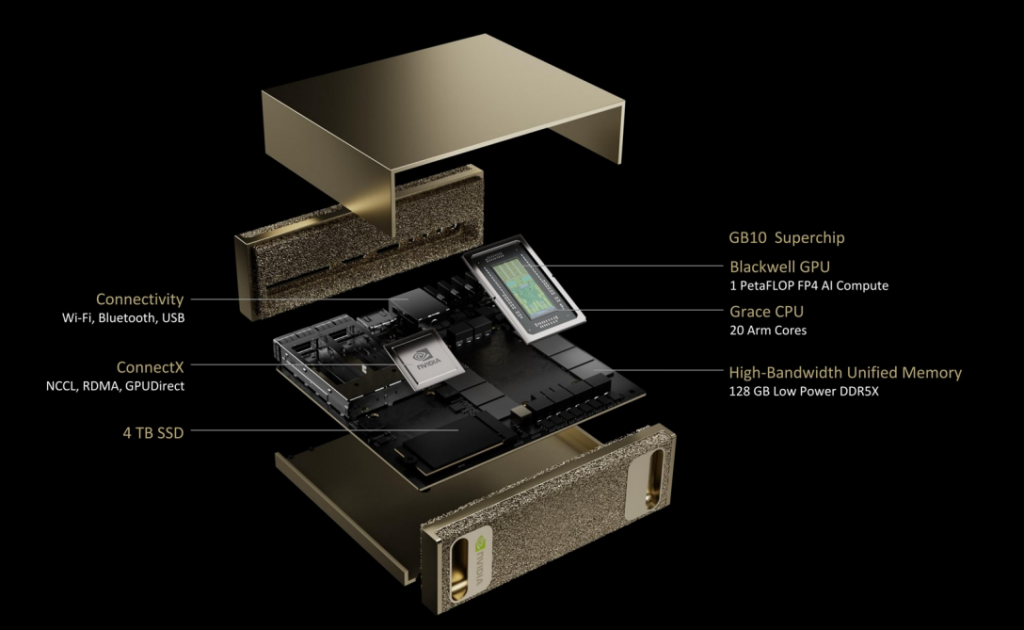
Компоненты ИИ-ПК Nvidia DGX Spark. Источник: .
Сердцем DGX Spark служит суперчип GB10, представляющий из себя связку ARM-CPU Grace с 20 ядрами Neoverse V2 и GPU на флагманской архитектуре Blackwell (аналог кристалла RTX 5070, но с большим количеством тензорных ядер), объединенные интерконнектом NVLink C2C. Этот чип способен выжать из себя до 500 TFLOPS в FP4 (без структурной разряженности).
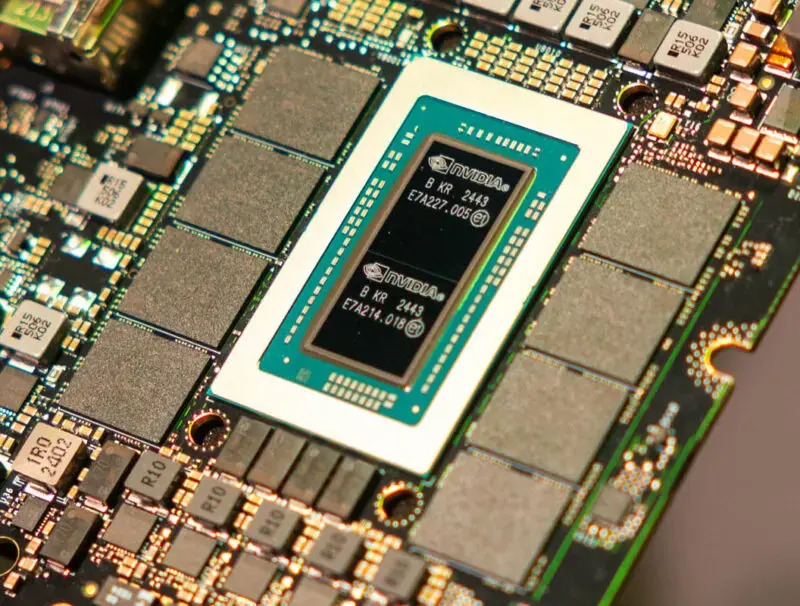
Nvidia GB10. Источник: .
Чтобы эта лошадка тянула тяжелые локальные LLM, DGX Spark имеет пул из 128 ГБ унифицированной памяти LPDDR5X с пропускной способностью 273 ГБ/с — в такую память спокойно можно загружать нейронки объемом 120 миллиардов параметров, вроде GPT-OSS, а благодаря мощному суперчипу вы будете получать скорость инференса на уровне 50-70 токенов в секунду. Но главная фишка Spark — поддержка формата вычислений FP4, который позволяет запускать нейронки в формате весов NVFP4 с огромной скоростью. Тензорные ядра Blackwell 5-ого поколения оптимизированны эффективно работать с этим форматом, что позволяет в 2 раза поднять пропускную способность по сравнению с FP8 и запускать в 2 раза более крупные модели в том же объеме памяти.
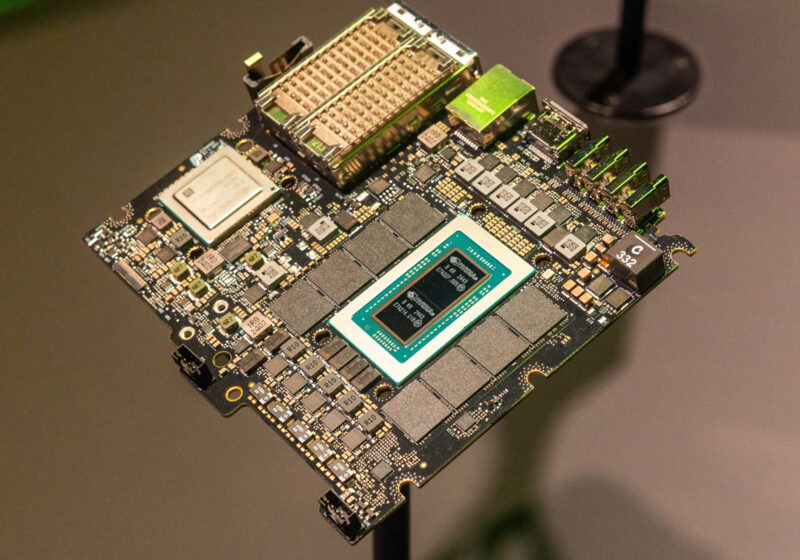
Плата ИИ-ПК Nvidia DGX Spark. На одной подложке с SoC-чипом GB10 расположены микросхемы LPDDR5X. Источник: .
Конечно же, мы не могли не пройти мимо еще одного козыря Хуанга — поддержки программной экосистемы CUDA, которая всегда была и остается самой зрелой средой для ИИ-разработки. DGX Spark получает к ней полный доступ без каких-либо ограничений: PyTorch, TensorRT-LLM, кастомные CUDA-ядра — все это работает на “ИИ-коробке прямо из коробки”.
Но за ширмой обильных похвал, весьма легко можно разглядеть и ряд весьма внушительных недостатков DGX Spark, главным из которых, наверное, является его цена. За ИИ-бокс нужно отдать аж $4,699, и это может показаться вполне оправданным, пока не всплывают другие подводные камни. Дело в том, что действительно быстро на DGX Spark запускаются только модели в формате NVFP4, тогда как нейронки в более популярном формате FP8 запускаются с умеренными 35 токенов в секунду в случае с той же GPT-OSS-120b, так как ошеломительные 500 TFLOPS в NVFP4 превращаются в 250 TFLOPS при переходе на FP8.
Однако главный козырь Spark, который часто замалчивают — сетевые возможности. В то время как AMD в своем Ryzen AI Halo установила обычную 10-Гбит/с сетевую карту (и пытается компенсировать это программным RDMA, что создает лишнюю нагрузку на CPU), DGX Spark оснащается выделенным ConnectX-7 на 200 Гбит/с с аппаратной поддержкой GPUDirect RDMA. Это позволяет объединять до трех Spark-станций в бесшовный кластер с микросекундными задержками, без потери производительности на пересылку данных — то, о чем AMD может только мечтать. Именно за эту сетевую инфраструктуру, полноценную экосистему CUDA и уникальный FP4-движок Nvidia просит дополнительные $700: вы платите не просто за коробку, а за готовое решение для профессионального инференса, где сеть и память не становятся узким горлышком даже при работе с моделями под 200 млрд параметров.
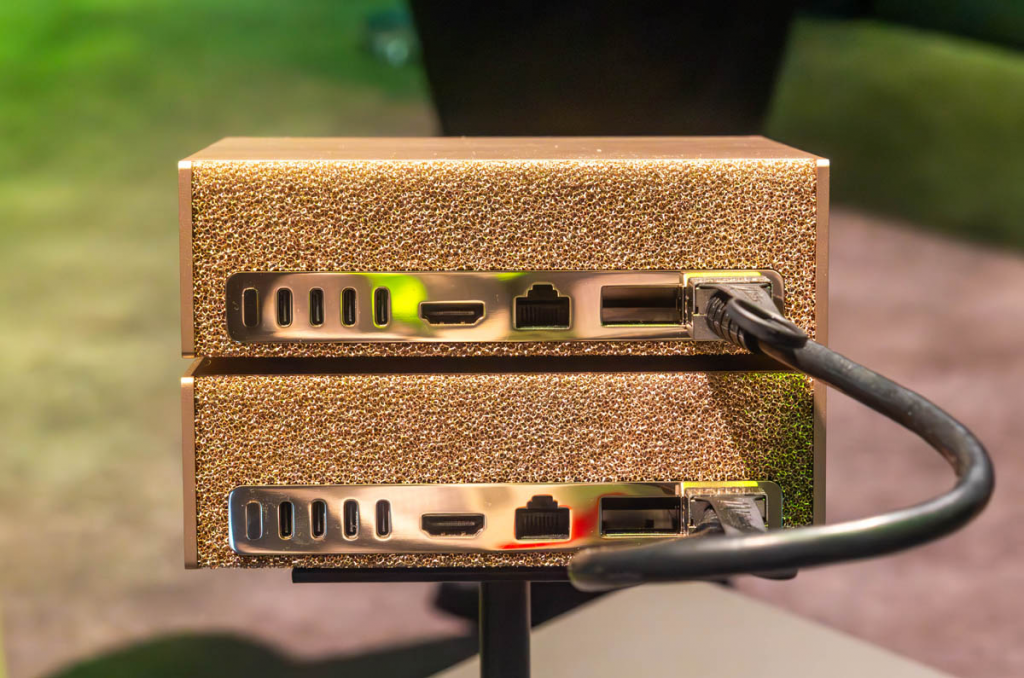
Сетевая карта ConnectX-7, интегрированная в Nvidi DGX Spark, позволяет бесшовно объединять до 3 ИИ-ПК без дополнительных программных утилит и настройки топологии. Источник: .
Что такое AMD Ryzen AI Halo
AMD Ryzen AI Halo — это принципиально другой зверь, запущенный на рынок в июне 2026 как противопоставление доминации DGX Spark на рынке ИИ-ПК.
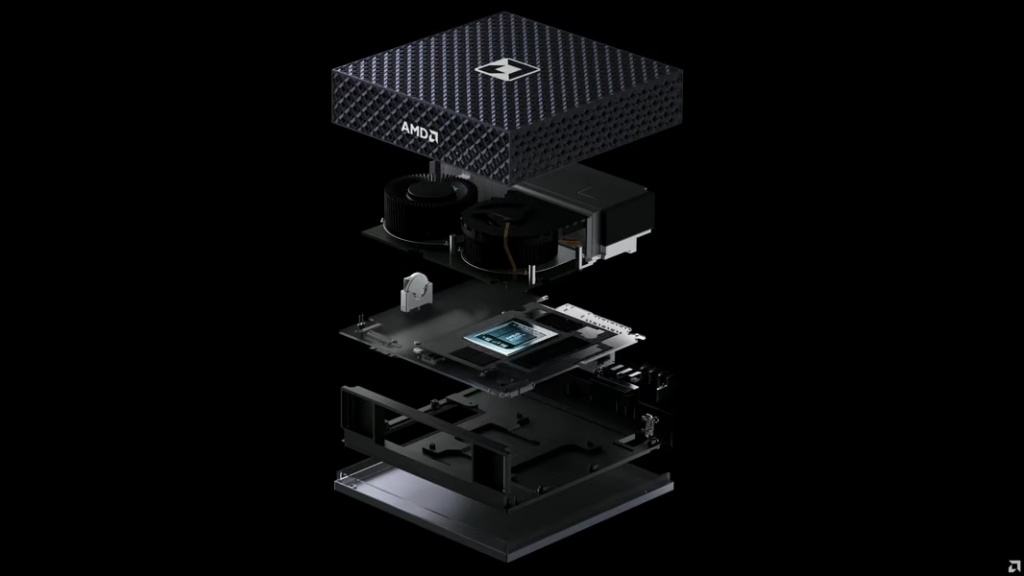
Компоненты AMD Ryzen AI Halo. Источник: .
Вместо специализированного ИИ-ускорителя AMD объединила на одном кристалле Strix Halo Ryzen AI Max+ 395 три компонента: 16 ядер Zen 5 (x86-64), графику RDNA 3.5 с 40 вычислительными блоками и выделенный нейросетевой движок XDNA 2, связка из которых обеспечивает 126 TOPS производительности — в два раза меньше, чем у Spark с его 250 TOPS без структурной разряженности. Все три работают с единым пулом унифицированной памяти LPDDR5X объемом до 128 ГБ и пропускной способностью около 273 ГБ/с. Форматов вычислений хватает на любой случай жизни: FP16, BF16, INT8 и INT4 поддерживаются на аппаратном уровне.
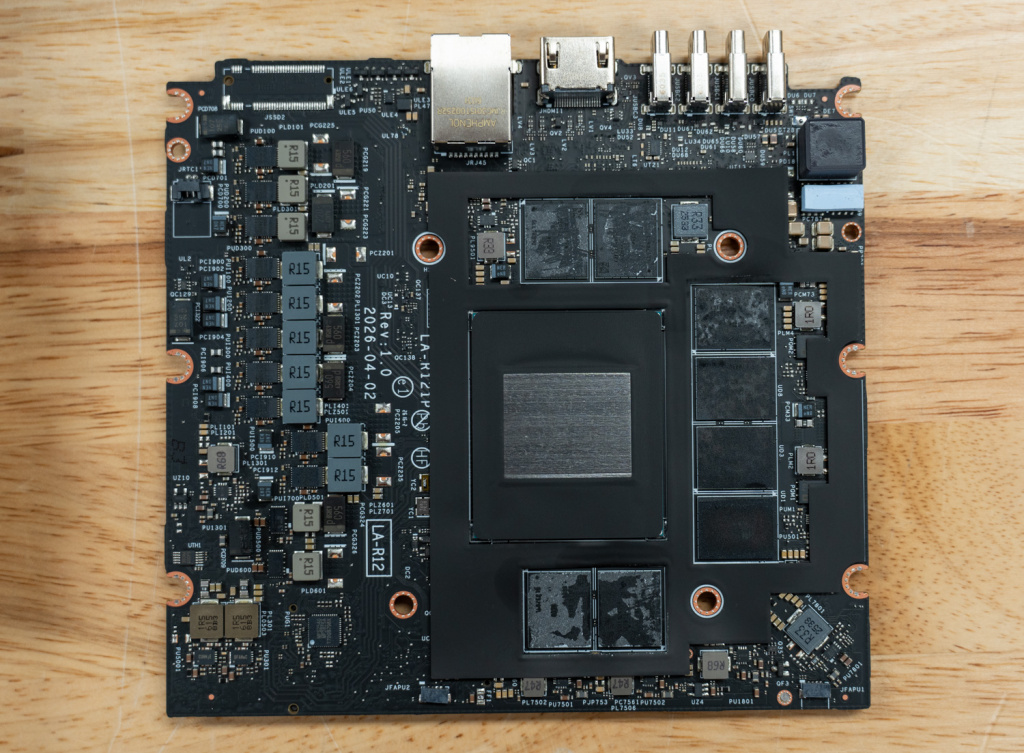
Плата ИИ-ПК AMD Ryzen AI Halo на базе чипа Ryzen AI Max+ 395. Источник: .
Главное преимущество Ryzen AI Halo перед специализированными ИИ-станциями — это универсальность. В отличие от ARM-решений, которые требуют эмуляции для совместимости с проприетарным софтом, в решении AMD стоит полноценный x86-процессор, на котором спокойно работает абсолютно любой софт. Утром можно генерировать токены на Qwen-3.6-27B через Ollama, днем монтировать видео в Premiere Pro, а вечером работать в CAD-системе — все на одной машине.
Что касается чисто ИИ-софта, Strix Halo использует ПО-стек ROCm под Linux, который уже достаточно созрел для запуска PyTorch, ONNX Runtime и vLLM. Windows-пользователи могут положиться на DirectML или Vulkan-бэкенды, которые поддерживаются в llama.cpp, Ollama и LM Studio. Количество токенов здесь ниже, чем у Blackwell с его аппаратным FP4 но в иных форматах они идут на равных, а универсальность и совместимость с корпоративным окружением перевешивают плюсы DGX Spark. А цена на ИИ-бокс AMD — всего $3999, аж на 700 баксов дешевле решения Nvidia. В комплекте также есть и возможность кластеризации до 4 узлов, и это еще один камень в огород Nvidia.
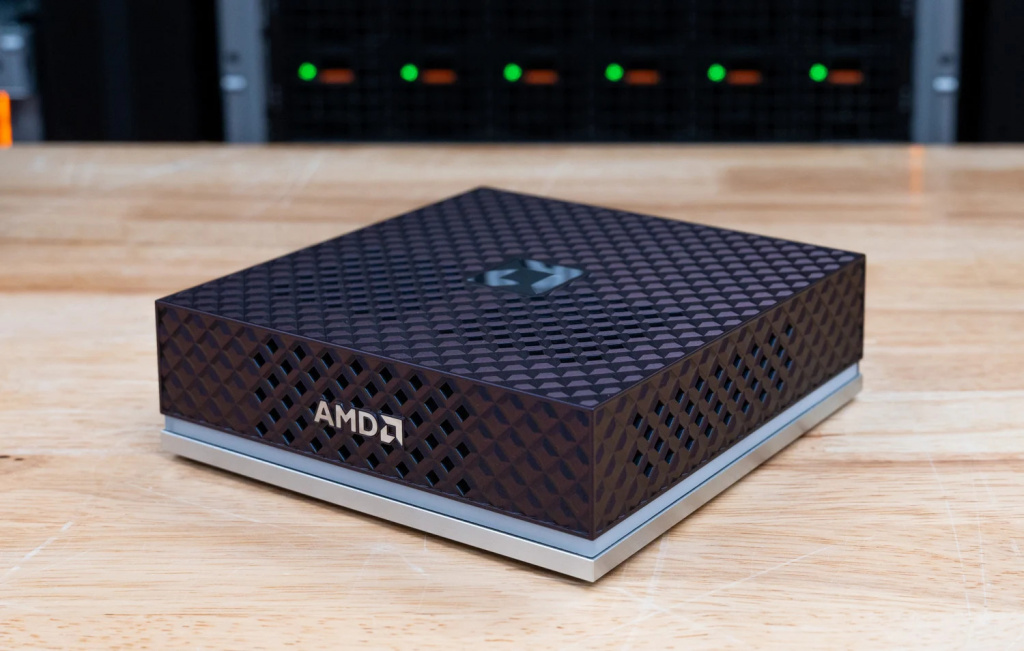
AMD Ryzen AI Halo. Источник: .
А теперь ознакомимся с небольшой табличкой, чтобы наглядно сравнить характеристики двух компактных ИИ-ПК:
|
Характеристика |
AMD Halo Box |
NVIDIA DGX Spark |
|
Процессор (CPU) |
AMD Ryzen AI Max+ PRO 395, 16 ядер/32 потока, Zen 5 |
NVIDIA GB10 Grace Blackwell Superchip 20-ядерный ARM (10x Cortex-X925 + 10x Cortex-A725) |
|
GPU |
Radeon 8060S (RDNA 3.5), 40 вычислительных блоков |
Blackwell, 6144 ядер CUDA, 384 тензорных ядер 5-го поколения |
|
NPU |
XDNA 2 NPU до 50 TOPS |
- |
|
Основная память |
128 ГБ LPDDR5X-8000, 256 ГБ/с |
128 ГБ LPDDR5X-8533, 273 ГБ/с |
|
Сеть |
1x 2.5GbE RJ-45 |
1x 10GbE RJ-45, 2x 200GbE QSFP28 ConnectX-7 Smart NIC |
|
Хранилище |
2x M.2 2280 PCIe 5.0 (макс. 8 ТБ) |
1x M.2 2242 PCIe 5.0 NVMe (макс. 4 ТБ) |
|
Производительность FP8 |
126 TOPS |
500 TOPS (со структурной разряженностью) |
|
Производительность FP4 |
- |
1000 TOPS (со структурной разряженностью) |
|
Цена |
$3 999 |
$4 699 |
CUDA против ROCm
Производительность ИИ-системы никогда не определяется только терафлопсами. Вопрос в том, запустится ли нужный фреймворк без плясок с бубном. Давайте вспомним, чем же отличаются CUDA и ROCm и как это влияет на инференсе с помощью DGX Spark и Ryzen AI Halo.
- CUDA остается золотым стандартом. Подавляющее большинство инструментов, таких как PyTorch, TensorFlow, TensorRT, vLLM, оптимизированы именно под Nvidia. Любой разработчик, скачавший свежую библиотеку, знает: на DGX Spark она заработает. Десятилетие доминирования CUDA в ИИ-разработке создало инерцию, которую трудно переломить, поэтому даже ИИ-экзотика запускается на CUDA без компромиссов.

Экосистема NVIDIA. Источник: .
- ROCm активно развивается. Под Linux экосистема AMD уже достаточно созрела: PyTorch, ONNX Runtime, vLLM работают с RDNA 3.5 без проблем. Однако пользователи Windows сталкиваются с ограничениями — официальной поддержки ROCm там нет, приходится использовать Vulkan-бэкенды. Инструменты вроде llama.cpp и Ollama умеют работать с AMD через ROCm или Vulkan. Open WebUI, будучи веб-оберткой, от железа их запуск не зависит вообще. Но экзотические фреймворки или тонкая оптимизация — это почти всегда прерогатива CUDA.

Экосистема AMD ROCm. Источник: .
Какие модели и движки можно запускать локально
Обе системы справляются с современными открытыми моделями, но нюансы есть. DGX Spark с его поддержкой FP4 позволяет загрузить Qwen3.6-72B в чистом 4-битном формате — такая модель занимает около 35 ГБ. Оставшиеся 90+ ГБ можно отдать под KV-кэш, получая контекст в десятки тысяч токенов без деградации скорости. Более того, FP4 и TensorRT-LLM открывают дорогу к запуску сверхтяжелых MoE-архитектур уровня DeepSeek V4 с мощной квантизацией. Активная часть модели помещается в памяти целиком, а эксперты подкачиваются из NVMe-диска.
Ryzen AI Max+ 395 также берет 72-миллиардные модели, но использует именно GGUF-квантование Q4_K_M. Такая модель весит около 40 ГБ, и со 128 ГБ на борту остается примерно 80 ГБ под контекст и системные нужды. Пиковая скорость генерации токенов здесь ниже, чем на Blackwell, так как производительность Ryzen AI Max+ 395 в два раза отстает от Spark, зато через Ollama можно одновременно держать загруженными две-три модели поменьше, например Qwen-3.6-32B или Gemma 4 27b, и переключаться между ними без перезагрузки. Модели до 30 миллиардов параметров летают на обеих платформах без каких-либо проблем. Монстры в FP16 уровня DeepSeek-V4 Pro (1,6T) или Qwen-3.6-397B-A17B (397B, 17B) пока не по зубам ни одной из этих систем, даже если объединять их в кластеры.
Но важно понимать, что в отличие от универсального “швейцарского ножа” AMD, DGX Spark — это узкоспециализированный ИИ-акселератор, и его сила раскрывается именно в работе с большими языковыми моделями. Да, на Spark без проблем запускается и llama.cpp с любыми квантованиями (вплоть до INT8 и INT4), и даже популярный формат Q4_K_M физически поддерживается, но использовать его здесь попросту бессмысленно: аппаратные тензорные ядра Blackwell пятого поколения оптимизированы под собственный формат NVFP4, который дает вдвое большую пропускную способность (500 TFLOPS против 250 в FP8) и, что критичнее, значительно более широкий динамический диапазон, чем у классических INT4-квантований. Это означает, что модель в NVFP4 выдает качество, близкое к FP16, при тех же затратах памяти и скорости, что и INT4, тогда как Q4_K_M на Spark будет работать медленнее и с худшим качеством, просто потому что железо заточено под другой стандарт.
Аналоги DGX Spark и AI Halo
Рынок не ограничивается дуэтом Nvidia и AMD. Apple, Intel и Qualcomm также поставляют свои процессоры для выпуска компактных ИИ-ПК, которые предлагают неплохие ИИ-возможности за более бюджетный или эквивалентный прайс.
- Apple Mac Studio (M3 Ultra) — профессиональная рабочая станция в компактном корпусе, которая делает ставку на огромный объем унифицированной памяти и рекордную пропускную способность, что критично для инференса больших языковых моделей. Чип M3 Ultra включает 28‑ядерный CPU, 60‑ядерный GPU и 32‑ядерный Neural Engine, поддерживает до 128 ГБ унифицированной памяти. Базовая конфигурация (96 ГБ памяти + 1 ТБ SSD) стартует от $3,999.
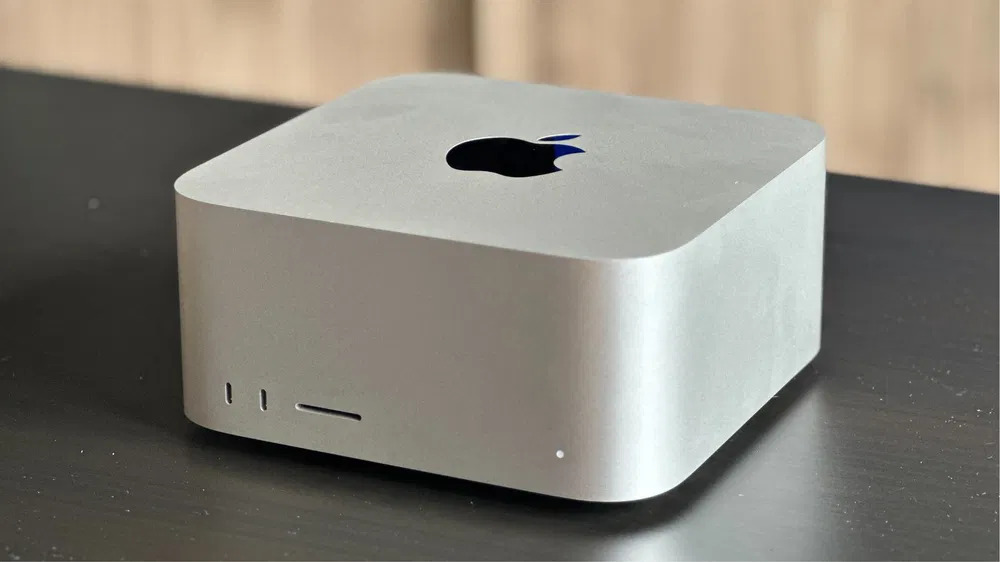
Apple Mac Studio на базе чипов M3 Ultra. Источник: .
- GMKtec EVO‑T2 — компактный мини‑ПК на базе новейших процессоров Intel Core Ultra серии 3 (Panther Lake, техпроцесс Intel 18A). Флагманские чипы Core Ultra X7 358H / X9 388H предлагают 16 ядер, встроенную графику Intel Arc B390 (производительность на уровне RTX 4050 Laptop GPU), а общая производительность достигает 180 TOPS. Устройство поддерживает 64 ГБ общей памяти LPDDR5X‑8533 и до 16 ТБ хранилища. Стартовая цена составляет $1,899.
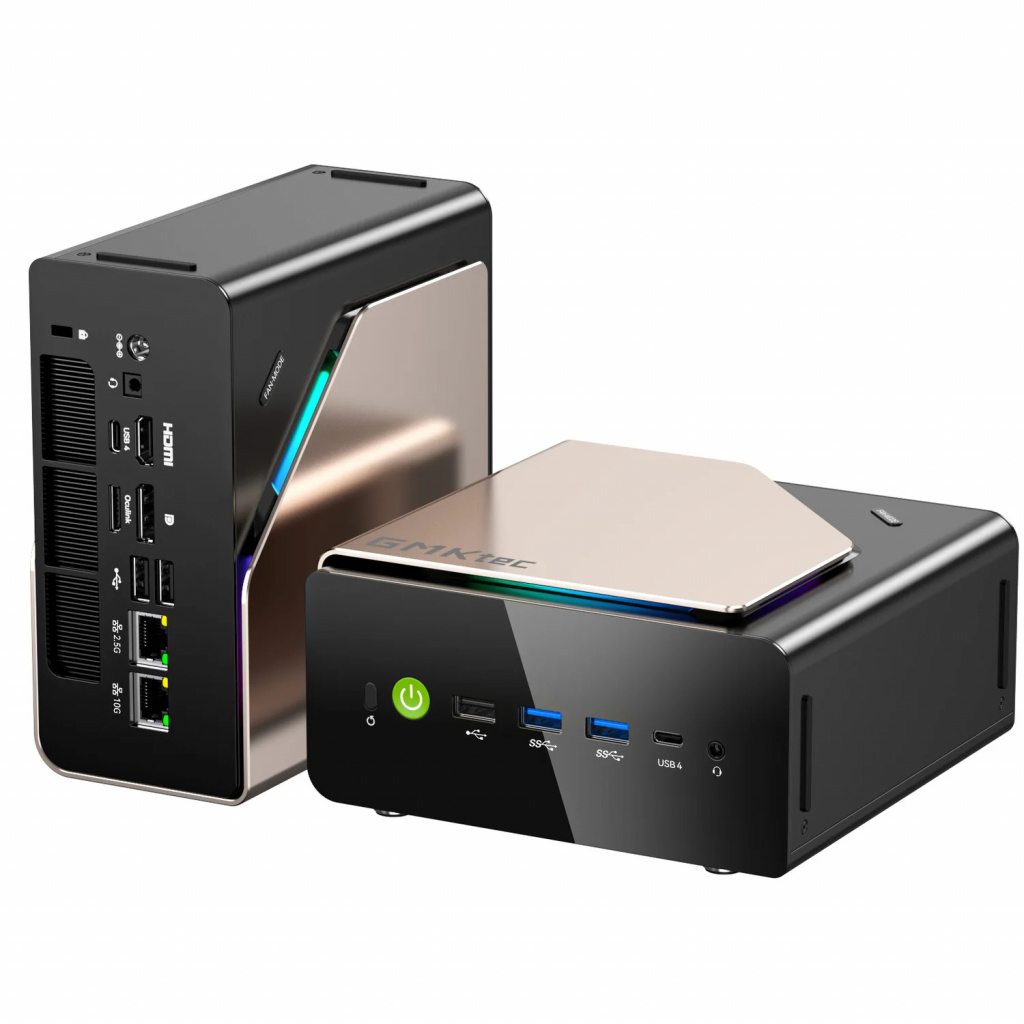
GMKtec EVO‑T2 на базе Intel Core Ultra 3. Источник: .
- ASUS Ascent QN10 — первый в мире мини‑ПК с NPU мощностью 80 TOPS, построенный на Snapdragon X2 Elite. Чип содержит 18‑ядерный Qualcomm Oryon CPU, интегрированный Adreno X2 GPU и Hexagon NPU с производительностью 80 TOPS. Устройство поддерживает до 32 ГБ LPDDR5x 9600 МГц. Цена и дата выхода официально не объявлены.
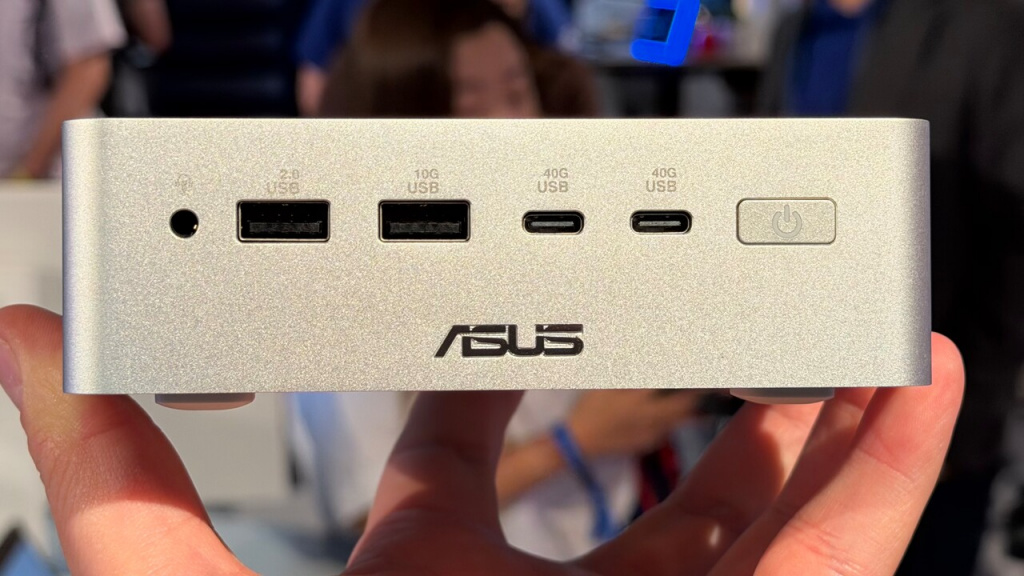
ASUS Ascent QN10 на базе Snapdragon X2 Elite. Источник: .
Выводы
Универсального победителя здесь нет, и выбор сводится к простому вопросу: что для вас важнее — максимальная ИИ-производительность и возможности CUDA или универсальность и более бюджетный прайс. Если вы ИИ-энтузиаст, который только и делает, что работает с нейронками — DGX Spark ваш инструмент. Если же вам нужна одна машина для всего — и для нейросетей, и для монтажа видео, и для CAD — Ryzen AI Halo будет сбалансированнее. А если вы совсем отважный, то можете попробовать обзавестись альтернативными вариантами на базе Intel и Qualcomm. В любом случае, рынок персональных ИИ-ПК очень молод и все еще не сформировался окончательно, и не исключено, что скоро совершенно новый игрок выйдет в этот сегмент со своим решением, которое растопчет и AMD, и Nvidia. А пока пусть красные и зеленые продолжают свою здоровую конкуренцию, внося новые инновации в индустрию потребительского ИИ-инференса.
