Как ускорить ИИ-инференс — лучшие методы оптимизации скорости локального развертывания LLM
Введение
Представьте — вы наконец-то собрали мощный ИИ-ПК или купили сервер с парой видеокарт, скачали свежую модель с Hugging Face, запустили ее и… получили 3 токена в секунду. Ответ на простой вопрос печатается так медленно, что за это время можно успеть сходить за кофе, а о комфортной работе с ИИ-агентами речи вообще не идет. Первая мысль, которая приходит в голову, — "видеокарта слабая, надо брать новую". Но спешить с покупкой не стоит, ведь в 9 случаях из 10 проблема кроется не в железе, а в том, как именно вы его используете. Неподходящий формат весов, движок инференса "по умолчанию", раздутый KV-кэш, отсутствие батчинга — все это может срезать скорость генерации в разы даже на топовом ИИ-ускорителе. Хорошая новость в том, что за последние пару лет ИИ-сообщество и крупные вендоры придумали целый арсенал методов оптимизации, многие из которых не требуют ни копейки вложений и настраиваются буквально парой флагов в командной строке. В этой статье специалисты компании ServerFlow расскажут вам, что на самом деле тормозит инференс LLM, как выбрать подходящую модель и формат квантизации и какой движок инференса подойдет под ваши задачи.
Что на самом деле тормозит инференс
Прежде чем разбираться в методах ускорения, важно понять, что именно мы ускоряем. В нашей прошлой статье мы уже подробно рассказывали о том, что именно пропускная способность памяти влияет на генерацию токенов, поэтому здесь лишь кратко освежим главное. Инференс LLM состоит из двух фаз:
- Prefill — модель читает промпт пользователя, обрабатывая все его токены параллельно. Здесь все упирается в вычислительную мощность GPU.
- Decode — модель генерирует ответ токен за токеном, и для каждого нового токена заново читает из памяти свои веса и накопленный KV-cache. Здесь все упирается в пропускную способность памяти. Это актуально для классических моделей-трансформеров.
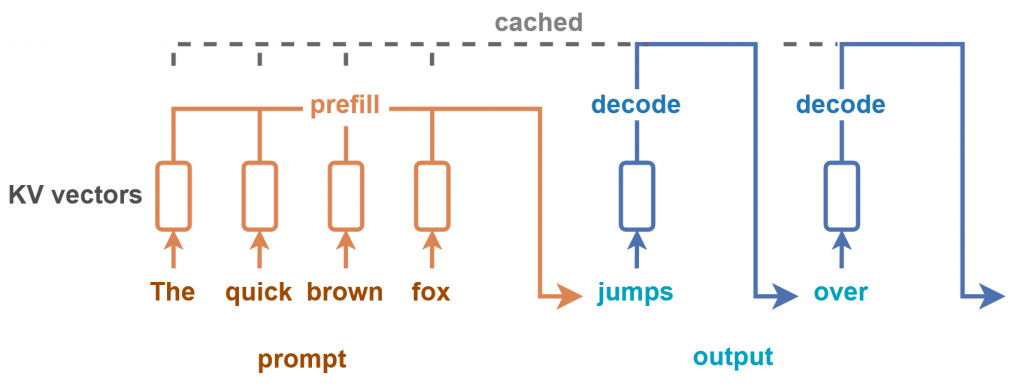
Разница фаз prefill и decode. Источник: .
Именно поэтому почти все методы оптимизации, о которых пойдет речь ниже, крутятся вокруг одной идеи: читать из памяти как можно меньше байт на каждый сгенерированный токен и не тратить впустую вычислительные ресурсы, которые простаивают в фазе decode.
Кроме того, важно понимать, какую скорость мы вообще измеряем. В инференсе есть несколько ключевых метрик:
- TTFT (Time To First Token) — время от отправки запроса до появления первого токена ответа. Зависит в основном от скорости prefill и длины промпта. Именно TTFT определяет, насколько "отзывчивой" ощущается модель.
- Ток/с на пользователя — скорость генерации в фазе decode для одного запроса. Это та самая цифра, которую все сравнивают в бенчмарках.
- Throughput (пропускная способность системы) — суммарное количество токенов в секунду, которое сервер выдает всем пользователям одновременно.
- TPOT / ITL — задержка между соседними токенами. По сути, это та же скорость генерации, только выраженная в миллисекундах.
Метрики "скорость для одного пользователя" и "пропускная способность системы" часто тянут одеяло в разные стороны. Если вы запускаете персональный ИИ на своем устройстве, вам важен максимум токенов в секунду для одного-единственного диалога. А если вы разворачиваете ИИ-сервис для команды из 50 человек, на первый план выходит суммарная пропускная способность, и ради нее вполне можно пожертвовать парой токенов в секунду на каждого отдельного юзера. Поэтому прежде чем что-то оптимизировать, определитесь со сценарием — от этого будет зависеть выбор и движка, и настроек, и даже железа.
Выбор модели: самая дешевая оптимизация
Начнем с самого очевидного. Самый простой способ ускорить инференс — это запускать модель поменьше. Звучит банально, не так ли? Но на практике огромное количество пользователей по привычке тянутся к самой большой модели, которая только влезает в их VRAM, даже если задача этого совершенно не требует.
Логика здесь простая: если модель вдвое меньше, то и читать из памяти на каждом шаге нужно вдвое меньше данных, а значит, скорость декодирования вырастет примерно вдвое. И компактные модели сегодня — это уже совсем не "игрушки для экспериментов". Яркий пример — свежая (на момент выхода статьи) модель Qwen3.8-27B от Alibaba. По собственным бенчмаркам Qwen, она обходит даже закрытую Qwen 3.7-Plus с сотнями миллиардов параметров, которая еще в мае этого года была одной из сильнейших моделей компании. При этом модель запускается локально на системах с 17 ГБ видеопамяти. Гонять базовые типичные задачи (суммаризацию, работу с RAG, извлечение данных из документов, написание кода) модель на сотни миллиардов параметров — это как ездить за хлебом на карьерном самосвале: доехать доедете, но зачем?
Отдельно стоит выделить несколько классов моделей, которые особенно хорошо показывают себя в локальном инференсе.
- Дистиллированные модели. Дистилляция — это процесс, при котором компактную "модель-ученика" обучают воспроизводить ответы большой "модели-учителя". В результате получается нейронка, которая весит в разы меньше оригинала, но сохраняет значительную часть его способностей. Кстати, та же Qwen3.8-27B — как раз дистиллированная модель от старших моделей семейства.
- MoE-модели (Mixture-of-Experts). В MoE-архитектуре модель состоит из множества "экспертов", и на каждый токен активируется лишь небольшая их часть. Например, у Qwen3.6-35B-A3B всего около 35 млрд параметров, но на каждый токен работают лишь ~3 млрд. Для decode это настоящий подарок: из памяти на каждом шаге читается только активная часть весов, и скорость генерации оказывается сопоставимой с маленькими плотными моделями, а объем знаний — как у больших.
- Специализированные модели. Если вам нужен ассистент для программирования, берите модель, обученную именно на коде. Если нужен экстрактор данных из таблиц — ищите компактную модель, дообученную под извлечение структурированной информации. Узкоспециализированная модель нередко обходит универсальную модель в несколько раз крупнее в своей нише и при этом работает в разы быстрее.
Квантизация
Если выбор модели это самая дешевая оптимизация, то квантизация — самая эффективная. Веса нейросети по умолчанию хранятся в 16-битном формате (FP16 или BF16), и каждый параметр занимает 2 байта. Квантизация снижает точность хранения весов до 8, 6, 4 и даже 2–3 бит на параметр. Модель в 4-битном формате весит примерно вчетверо меньше, чем в BF16. А раз decode упирается в объем читаемых из памяти данных, мы получаем почти пропорциональный рост скорости генерации. Бонусом модель занимает меньше VRAM, и на освободившееся место можно положить KV-cache для длинного контекста.

Пример распределение весов модели с помощью квантизации нейросети и точной настройки. Источник: .
Давайте посмотрим на цифры. Возьмем Qwen3.8-27B в разных GGUF-квантизациях и прикинем теоретический потолок скорости декодирования на Nvidia RTX PRO 6000 Blackwell (96 ГБ GDDR7, ~1,8 ТБ/с):
|
Формат |
Размер модели |
Теоретический потолок скорости |
Потеря качества |
|
BF16 |
~54 ГБ |
~33 ток/с |
Эталон |
|
Q8_0 |
~29 ГБ |
~62 ток/с |
Практически незаметна |
|
Q6_K |
~22 ГБ |
~81 ток/с |
Минимальная |
|
Q5_K_M |
~19 ГБ |
~93 ток/с |
Небольшая |
|
Q4_K_M |
~17 ГБ |
~105 ток/с |
Умеренная, "золотая середина" |
|
Q3_K_M |
~13 ГБ |
~138 ток/с |
Заметная |
|
Q2_K |
~10 ГБ |
~179 ток/с |
Сильная |
Вот и получается, что простой переход с BF16 на Q4_K_M дает прирост скорости примерно в 3 раза, причем без каких-либо аппаратных изменений. К тому же модель в Q4_K_M помещается уже не только в профессиональную карту, но и в потребительскую RTX 4090 или RTX 5090. Разумеется, реальные цифры будут ниже теоретических, но общий тренд сохраняется.
Важно: чем меньше модель, тем хуже она переносит агрессивную квантизацию. Модели на 7-8B в Q2_K превращаются в бестолковых чат-ботов. У моделей класса 27B запас прочности побольше, но и для них Q2 — это крайняя мера, а не рабочий вариант. Поэтому оценивайте вероятность потери качества при выборе квантов.
Отдельно стоит упомянуть квантизацию KV-кэша. Веса модели — не единственное, что читается из памяти при каждом шаге decode: по мере роста контекста KV-cache может занимать гигабайты и съедать заметную часть пропускной способности. Большинство современных движков позволяют хранить его в 8-битном формате вместо 16-битного. В llama.cpp, например, для этого есть флаги, активируемые одной командой. Это вдвое сокращает объем кэша практически без потерь качества. Более агрессивное 4-битное сжатие кэша уже может заметно навредить модели на длинных контекстах, поэтому с ним стоит быть осторожнее.
Выбор движка инференса
С моделью и форматом более-менее разобрались, осталось понять, на чем ее запускать. И тут начинается самое интересное, ведь одна и та же модель на одном и том же железе может работать с совершенно разной скоростью в зависимости от движка инференса. Даже сами разработчики Qwen в документации к Qwen3.8 честно предупреждают, что эффективность инференса и пропускная способность сильно различаются от фреймворка к фреймворку. Каждый движок заточен под свой сценарий, и универсального "самого быстрого" решения просто не существует.
- llama.cpp — легендарный движок, с которого для многих начался локальный инференс. Написан на C/C++, работает практически на любом железе. Главная фишка — гибкая выгрузка слоев между VRAM и RAM, что позволяет запускать модели, которые не помещаются в видеопамять целиком.
- Ollama — удобная обертка над llama.cpp, в которой модель скачивается и запускается буквально одной командой. Идеальна для быстрого старта и экспериментов, но за простоту приходится платить меньшей гибкостью настроек и, как правило, чуть более низкой скоростью.
- LM Studio — десктопное приложение с графическим интерфейсом, которое также использует llama.cpp, а на Mac дополнительно умеет работать с MLX. Отличный вариант для тех, кто не хочет возиться с командной строкой.
- vLLM — стандарт индустрии для продакшен-инференса на GPU. Именно здесь впервые появились почти все передовые методы оптимизаций и поддержка практически всех популярных форматов квантизации. Если вы разворачиваете сервис для нескольких пользователей, vLLM — одна из первых кандидатур.
- SGLang — прямой конкурент vLLM, который особенно хорош в сценариях с большим количеством повторяющихся префиксов благодаря фирменной технологии RadixAttention.
- TensorRT-LLM — фирменный движок Nvidia, который компилирует модель в оптимизированный граф под конкретную архитектуру GPU. Обычно выжимает максимум производительности из железа зеленой компании, но требует больше времени на настройку и работает только на Nvidia.
- MLX — фреймворк Apple для машинного обучения на Apple Silicon, который умеет эффективно работать с унифицированной памятью чипов серии M. На Mac MLX, как правило, работает быстрее llama.cpp.
Оптимизация внимания и памяти
Модель выбрана, квантизация подобрана, движок установлен. Но до максимальной скорости еще далеко, ведь остается одна из главных "прожорливых" сущностей инференса — механизм внимания и связанный с ним KV-cache.
Чтобы понять масштаб проблемы, давайте посчитаем. Объем KV-кэша на один токен вычисляется по формуле:
KV-cache на токен = 2 x число слоев с вниманием x число KV-голов x размерность головы x байт на значение
В качестве примера возьмем Qwen3.8-27B с гибридной архитектурой. Из 64 слоев модели классическое Gated-внимание стоит лишь в каждом 4 слое: раскладка слоев выглядит как 16 повторов блока из 3 слоев Gated DeltaNet и 1 слоя Gated Attention. Слои Gated DeltaNet используют линейное внимание с состоянием фиксированного размера, которое не растет вместе с контекстом. Так что KV-cache набирают только 16 слоев, и у каждого из них 4 KV-головы размерностью 256. Считаем для формата BF16:
2 x 16 x 4 x 256 x 2 байта = 65 536 байт = 64 КБ на токен
При контексте в 32 000 токенов это около 2 ГБ, при 128 000 токенов — около 8 ГБ, а на родном максимуме в 262 144 токена кэш разрастается примерно до 16 ГБ. Это почти столько же, сколько весит сама модель в Q4_K_M! И весь этот объем нужно читать из памяти на каждом шаге decode. Теперь понятно, почему на длинных диалогах и в агентных сценариях скорость генерации заметно проседает.
Поэтому при выборе модели для работы с длинным контекстом обращайте внимание на архитектуру внимания. Гибридные схемы с линейным вниманием, GQA, MQA или MLA (Multi-head Latent Attention из моделей DeepSeek) заметно экономят память.
Теперь разберемся, какие технологии помогают укротить механизм внимания.
- FlashAttention — алгоритм, который вычисляет внимание небольшими блоками прямо в быстрой внутрикристальной памяти GPU (SRAM), не выгружая огромную промежуточную матрицу внимания в медленную VRAM. В результате внимание считается быстрее и с меньшим расходом памяти, а выигрыш особенно заметен на длинных промптах в фазе prefill.

Схема работы технологии FlashAttention.
- PagedAttention — технология, придуманная авторами vLLM и позаимствованная, по сути, у операционных систем. Раньше движки резервировали под KV-cache каждого запроса кусок памяти на максимально возможную длину контекста, даже если пользователь в итоге написал "привет" и получил ответ из десяти слов. В результате до 60–80% памяти под кэш простаивало впустую из-за фрагментации и избыточного резервирования. PagedAttention нарезает KV-cache на небольшие страницы (блоки) и выделяет их по мере необходимости, как виртуальная память в ОС. Благодаря этому в тот же объем VRAM помещается в разы больше одновременных запросов, что напрямую увеличивает пропускную способность системы.

Схемы работы алгоритма PagedAttention.
- Prefix caching — повторное использование KV-кэша для одинаковых начал промптов. Если все ваши запросы начинаются с одного и того же системного промпта на 2000 токенов, нет никакого смысла каждый раз заново прогонять его через prefill. Движок один раз вычисляет кэш для этого префикса и затем подставляет его во все последующие запросы. В результате TTFT сокращается в разы.
Батчинг и параллельная обработка запросов
А вот мы и добрались до метода, который не ускоряет генерацию для одного пользователя, но способен в разы увеличить суммарную производительность ИИ-сервиса. Речь идет о батчинге — одновременной обработке нескольких запросов.
Вспомним, что в фазе decode GPU большую часть времени простаивает в ожидании данных из памяти: веса прочитаны, пара матричных умножений выполнена, и вычислительные блоки снова ждут. Так почему бы не использовать один и тот же проход по весам сразу для нескольких запросов? Именно в этом суть батчинга. Прочитав веса один раз, GPU вычисляет следующий токен сразу для 8, 16, 64 пользователей. Суммарное количество токенов в секунду растет почти линейно, пока GPU не упрется в свою вычислительную мощность или объем памяти под KV-cache.
Но и сам батчинг бывает разным.
- Static batching (статический батчинг) — классический подход, при котором система ждет, пока наберется нужное количество запросов, и обрабатывает их одним пакетом до тех пор, пока не будет сгенерирован самый длинный ответ. Проблема очевидна: если один пользователь попросил написать эссе на 2000 токенов, а остальные семь — ответить "да" или "нет", эти семь будут висеть в батче и занимать ресурсы, пока эссе не допишется. Новые запросы при этом ждут в очереди.
- Continuous batching (непрерывный или in-flight батчинг) — современный подход, при котором состав батча пересматривается на каждом шаге генерации. Завершенные запросы сразу покидают батч, а новые подключаются к нему на лету, не дожидаясь окончания чужих ответов. GPU всегда загружен полезной работой, а задержки для пользователей заметно сокращаются.
- Chunked prefill (порционный prefill) — дополнение к continuous batching, которое решает еще одну неприятную проблему. Представьте, что в систему, которая спокойно генерирует ответы для 20 пользователей, прилетает запрос с промптом на 50 000 токенов (например, пользователь скормил модели толстый PDF). Его prefill занимает GPU на ощутимое время, и все остальные 20 пользователей видят, как генерация у них внезапно "замирает". Chunked prefill нарезает длинный промпт на порции и обрабатывает их вперемешку с шагами decode для остальных запросов. Генерация у всех продолжается плавно, без заиканий.
Спекулятивное декодирование
Что делать, если нужно ускорить генерацию для одного пользователя, а квантизация уже выжата досуха? На помощь приходит спекулятивное декодирование. Небольшая черновая модель угадывает несколько следующих токенов, а основная модель проверяет их все за один проход. Если черновик угадал 4 токена из 5, большая модель выдала 5 токенов за один шаг, причем без потери качества.
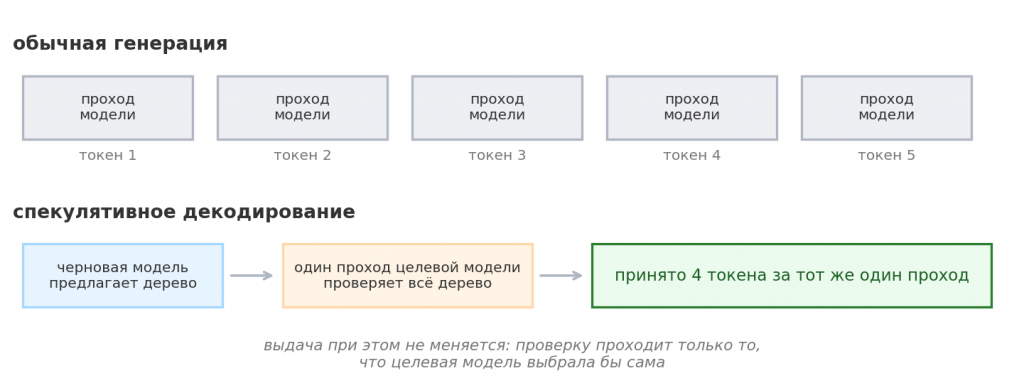
Сравнение обычного цикла генерации с ускоренным циклом генерации с помощью спекулятивного декодирования. Источник: .
- Draft-модель — маленькая модель того же семейства (например, флаг -md в llama.cpp).
- Medusa и EAGLE — легковесные рекурсивные черновые модули, работающие со скрытыми состояниями основной модели.
- DFlash — наиболее передовой метод спекулятивного декодирования на сегодняшний день. Вместо обычной рекурсивной черновой модели используется диффузионная нейростеть, что ускоряет инференс вплоть до 4 раз. Это буквально чит-код, генерирующий дополнительные токены за бесплатно.
- MTP — модуль предсказания нескольких токенов, встроенный в модель еще при обучении. Qwen3.8-27B обучалась именно с многошаговым MTP, и в режиме --spec-type draft-mtp в llama-server на DGX Spark она обошла стандартный GGUF в LM Studio примерно на 72%.
- N-gram / Prompt Lookup — кандидаты берутся прямо из промпта. Отлично работает при редактировании кода и в RAG.
Выводы
Не стоит отчаиваться, если ваша локальная нейронка выдает 2,5 ток/с. Зная передовые методы оптимизации инференса, вы сможете не просто добавить пару токенов к и так плачевному результату, а разогнать скорости до небывалых высот, которые ранее, казалось бы, были доступны только обладателям предтопового железа. Однако помните, что оживить совсем уж древнее железо не поможет даже некромант, и если вашему ускорителю не посильна какая-то конкретная нейронка, стоит обратить внимание на другое, более компактное по весам и параметрам решение, ведь далеко не всегда размер LLM напрямую связан с ее производительностью. А если вы не хотите заморачиваться с настройкой железа и софта для развертывания ИИ-модели, просто обращайтесь в ServerFlow — наши специалисты не только подберут для вас идеально подходящее под ваши требования и задачи оборудование, но и проведут вас за руку от покупки системы до ее запуска в продакшен.
