Как пропускная способность памяти влияет на генерацию токенов
Введение
Многие начинающие ИИ-энтузиасты считают, что скорость инференса напрямую зависит от мощности GPU, то есть от заветного параметра “FLOPS” в разных режимах вычислений. Безусловно, вычислительная производительность видеокарты тоже очень важная характеристика, особенно в процессе обучения нейросетей. Однако при инференсе LLM существует другой, куда более важный аппаратный параметр, на который юзеры часто не обращают внимания, из-за чего впоследствии разочаровываются в скорости работы ИИ. Речь идет о пропускной способности памяти GPU. В этой статье специалисты компании SeverFlow расскажут вам, на что и как влияет скорость памяти в инференсе, как подсчитать количество токенов в секунду, какое оборудование демонстрирует лучшую производительность инференса и какие факторы влияют на скорость локального вывода.
Фазы инференса — Prefill и Decode
Прежде чем вникать в суть влияния пропускной способности памяти, важно понять, что инференс — это процесс, состоящий из двух этапов: Prefill и Decode. И на каждом из этих этапов нейросеть требует от GPU разных ресурсов. Давайте разберемся, что скрывается за этими техническими понятиями.
Prefill
Prefill — это фаза, при которой нейросеть получает входной текст и впервые его обрабатывает, то есть читает пользовательский промпт. Если пользователь подал промпт на 10 000 токенов, модель должна прогнать через себя все эти токены, построить внутренние представления и подготовить KV-cache для последующей генерации, и сделать все это параллельно. Ключевое слово здесь “параллельно”, и именно для таких параллельных задач современные GPU хорошо умеют выполнять матричные вычисления, в том числе и операции с плавающей запятой (FLOPS). То есть в фазе Prefill от GPU и его ядер требуется именно максимальная вычислительная мощность и количество FLOPS, и чем эти значения выше, тем быстрее видеокарта обработает запрос и перейдет к следующей фазе ИИ-вычислений.
Decode
Decode — это следующая фаза после Prefill, когда нейросеть уже начинает генерировать ответ на запрос юзера. Причем, генерация происходит токен за токеном (условно, буква за буквой), так как каждый следующий токен предугадывается моделью на основе содержания предыдущего токена. Модель физически не может взять и за раз сгенерировать огромную матрицу из 1000 токенов. И, что самое важное, для генерации каждого токена модель не только должна вычислить следующий токен, но и прогнать все веса нейросети через память ИИ-ускорителя — гигабайты и даже сотни гигабайтов данных (в зависимости от объема LLM и размера batch) всего за один проход. Именно в фазе Decode количество FLOPS уходит на второй план, и первостепенной характеристикой становится пропускная способность памяти.
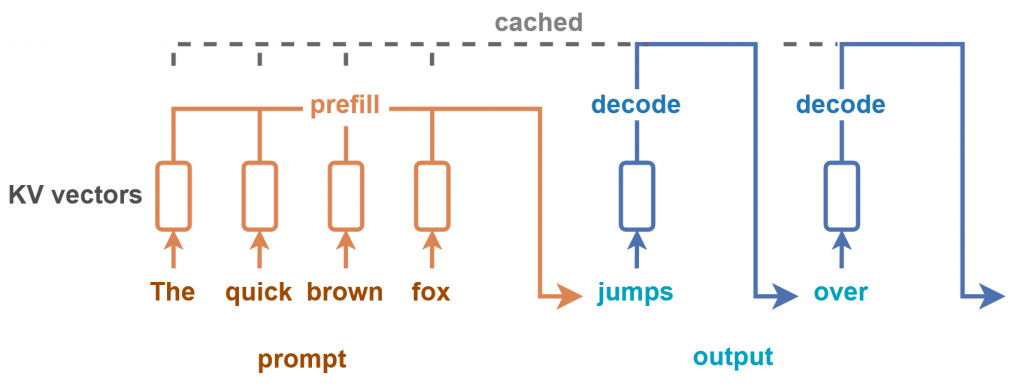
Разница фаз prefill и decode. Источник: .
Важно: batch size — это количество запросов, которые нейросеть обрабатывает одновременно за один проход. Упрощенно, batch=1 — это один пользователь, batch=8 — восемь параллельных запросов. Большинство потребительского инференса — это как раз batch=1, и для железа это худший сценарий. На каждый токен GPU вынужден заново прочитать все веса модели из HBM/GDDR/LPDDR, выполнить небольшой объем вычислений, получить один токен и снова идти в память. Вычислительные блоки в это время простаивают, а скорость генерации упирается в пропускную способность памяти. При большом batch (32, 64, 128) одни и те же прочитанные веса используются сразу для десятков запросов, и суммарное число токенов в секунду растет в разы. Именно поэтому облачные сервисы выжимают из тех же GPU на порядок больше токенов, чем один человек, запускающий модель локально для себя.
Оценка скорости декодирования
С теорией мы вас познакомили, но остается ключевой вопрос — так как же рассчитать теоретическую скорость декодирования в вашей системе? Для этого есть простая, но вполне эффективная формула.
Ток/с = Пропускная способность памяти (ГБ/с) / Размер модели (ГБ)
Допустим, мы запускаем Qwen3.8-27B в квантизации NVFP4, которая весит около 23,4 ГБ, на видеокарте NVIDIA RTX PRO 4500 Blackwell с 32 ГБ памяти GDDR7 и пропускной способностью 896 ГБ/с. Давайте посчитаем, сколько получится токенов в секунду (для упрощения посчитаем с batch=1):
896 ГБ/с / 23,4 ГБ = 38 ток/с
То есть теоретический потолок — около 38 токенов в секунду при batch=1 (однопользовательский инференс). Если взять карту с 4 ТБ/с, то:
4000 ГБ/с / 23,4 ГБ = 171 ток/с
Вот и получается практически линейная зависимость: увеличение пропускной способности вдвое дает увеличение скорости декодирования примерно вдвое, если остальные условия не меняются. Для Qwen3.8-27B NVFP4 эту зависимость можно свести в таблицу:
|
Пропускная способность памяти |
Скорость декодирования |
|
1 ТБ/с |
~43 ток/с |
|
2 ТБ/с |
~85 ток/с |
|
3 ТБ/с |
~128 ток/с |
|
4 ТБ/с |
~171 ток/с |
|
8 ТБ/с |
~342 ток/с |
Важно понимать, что пропускная способность зависит не столько от объема VRAM, сколько от типа памяти (HBM/GDDR/LPDDR), частоты работы микросхем памяти и разрядности шины. Да, без достаточного объема VRAM модель просто не поместится в GPU, но для максимальной скорости инференса ускорители важно выбирать именно по пропускной способности памяти.

Чем больше скорость памяти, тем выше количество генерируемых токенов в ИИ-инференсе. Именно поэтому для достижения наибольшего количества токенов в секунду важно наличие ИИ-ускорителя с HBM-памятью на борту.
MoE-модели
Формула “пропускная способность / размер модели” отлично работает для плотных моделей. Но для Mixture-of-Experts (MoE) моделей она требует уточнения. В MoE-архитектуре на каждом шаге генерации используются не все веса, а только их активная часть. Например, модель может иметь 125 млрд параметров всего, но активировать только 6 млрд на токен.
Для таких моделей более точная оценка:
tokens/s = Bandwidth / Active Model Size
Например, если активная часть модели весит 13,5 ГБ в 4-битном квантовании, то на DGX Spark с 273 ГБ/с теоретический потолок будет уже:
273 / 13,5 = 20 ток/с.
Это значительно лучше, чем 2,5 ток/с для плотной модели на 110 ГБ. Именно поэтому MoE-архитектуры могут быть особенно привлекательны на устройствах с ограниченной пропускной способностью памяти: они позволяют иметь большой общий объем знаний, но читать на каждом шаге только небольшую активную часть весов.
Другие факторы, влияющие на производительность
На самом деле, пропускная способность — критичный, но не единственный фактор, влияющий на скорость инференса. И даже те цифры, которые мы приводили выше, в реальности почти всегда будут ниже, на что есть несколько причин:
- kernel overhead — накладные расходы на запуск каждой вычислительной операции, которые срезают ресурсы GPU;
- KV-cache — по мере роста контекста диалога добавляется собственный трафик чтения и записи, скорость которого тоже напрямую зависит от пропускной способности памяти. Чем длиннее контекст и чем больше batch, тем больше памяти нужно под KV-cache.
- GPU-коммуникация — если модель не помещается на одну карту и распределена между несколькими GPU через NVLink или PCIe, добавляются задержки на синхронизацию, урезающие скорость передачи данных и, следовательно, скорость генерации токенов;
- Плохая утилизация пропускной способности — производитель GPU всегда указывает пиковую теоретическую цифру скорости памяти, но в реальных нагрузках обычно достижимо до 85% от заявленной скорости.
Поэтому все расчеты скорости декодирования всегда имеют приблизительный характер. Тем не менее, для оценки скорости больших LLM без квантизаций при инференсе на одной видеокарте, приведенная нами формула работает вполне неплохо.
Аппаратные примеры
Рассмотрим несколько примеров расчетов пропускной способности на реальном железе.
Nvidia B300
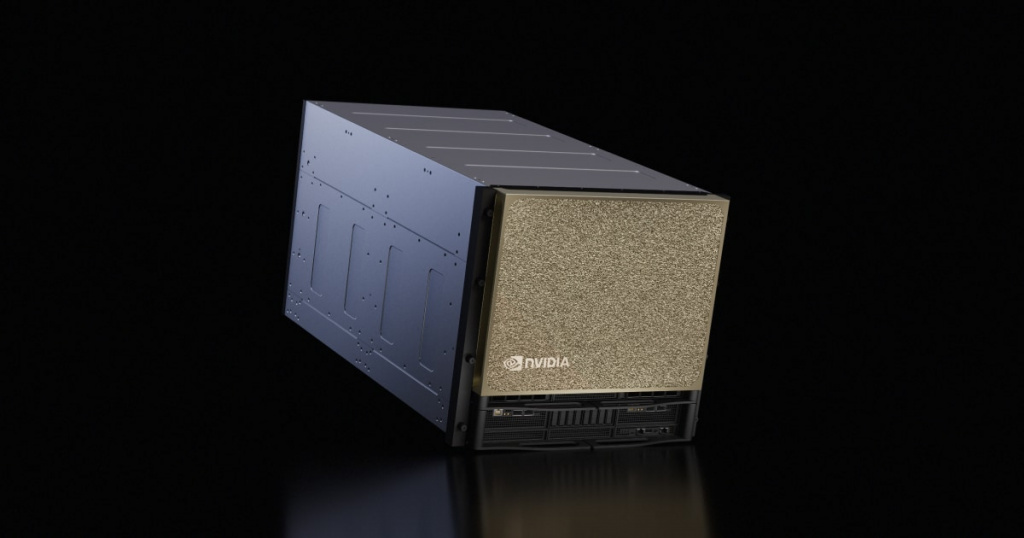
Вычислительный SXM-блок Nvidia B300. Источник: .
B300 — это флагманский ИИ-ускоритель Nvidia поколения Blackwell Ultra, построенный на двух вычислительных кристаллах с общим объемом памяти 288 ГБ HBM3e и пропускной способностью до 8 ТБ/с. Такой внушительный объем VRAM достигается за счет 12-слойных стеков HBM3e на восьми контроллерах — архитектурно карта собрана так, чтобы вмещать огромные ИИ-модели и прокачивать данные с максимально доступной на сегодня скоростью. При этом карта заметно прибавила в энергопотреблении по сравнению с предшественниками в лице B200 — типичный борт потребляет порядка 1400 Вт, и это прямая плата за увеличенную емкость и скорость памяти. Что немаловажно, модель весом 111 ГБ займет лишь чуть больше трети от доступных 288 ГБ памяти карты, оставляя огромный запас под KV-cache даже при очень длинном контексте или при параллельной обработке сразу нескольких диалогов.
Расчет для модели Qwen3.8-Next-Flash UD-Q4_K_XL (111 ГБ):
Ток/с = 8000 ГБ/с / 111 ГБ = 72 Ток/с (теоретический потолок при batch=1)
Это внушительная цифра для модели такого размера. Именно комбинация избыточной относительно размера модели емкости памяти и высочайшей пропускной способности делает B300 машиной, на которой decode практически никогда не станет узким местом: даже с поправкой на overhead, KV-cache-трафик и неидеальную утилизацию заявленной пропускной способности, реальная скорость с высокой вероятностью останется в районе 50-60 токенов в секунду, что можно считать очень комфортным результатом.
AMD Instinct MI350P
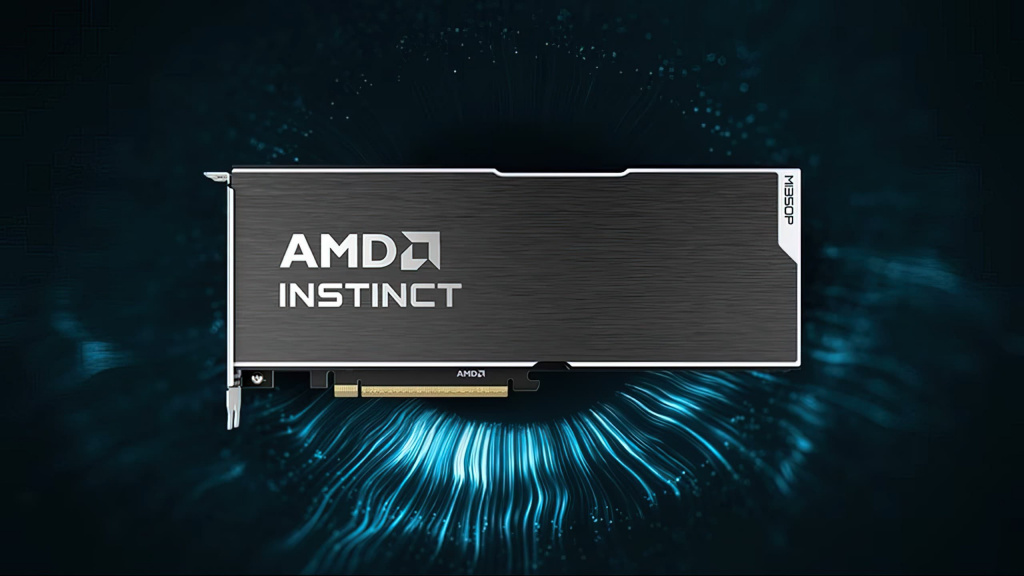
ИИ-ускоритель AMD Instinct MI350P. Источник: .
MI350P — это PCIe-ускоритель из семейства AMD Instinct на архитектуре CDNA 4 и, по сути половинка от флагманского MI350X: один ввод-вывод-кристалл вместо двух, вдвое меньше вычислительных блоков и вдвое меньше памяти, то есть 144 ГБ HBM3e на 4096-битной шине и пиковая пропускная способность до 4 ТБ/с. Карта заточена под интеграцию в традиционную вычислительную инфраструктуру без перехода на дорогую жидкостную инфраструктуру, которая требуется топовым OAM-модулям AMD, — отсюда и типичный теплопакет в 600 Вт (с возможностью урезать его до 450 Вт). По объему памяти модель весом 111 ГБ займет уже заметно большую долю доступных 144 ГБ, оставляя не такой щедрый запас под KV-cache, как в случае с B300, — с длинным контекстом или несколькими параллельными сессиями здесь придется считать бюджет памяти внимательнее.
Расчет для модели Qwen3.8-Next-Flash UD-Q4_K_XL (111 ГБ):
Ток/с = 4000 ГБ/с / 111 ГБ = 36 Ток/с (теоретический потолок при batch=1)
Ровно половина от результата B300, что абсолютно логично, ведь и пропускная способность у MI350P ровно вдвое ниже. В остальном же MI350P — крепкий вариант для инференс-нагрузок среднего размера: цифра в 36 токенов в секунду с поправкой на overhead и реальную утилизацию (обычно на 15-20% ниже пиковой) на практике, скорее всего, обернется чем-то в районе 28032 токенов в секунду — вполне рабочая скорость для многих продакшн-сценариев, хотя и без того запаса прочности, который дает B300.
Nvidia DGX Spark
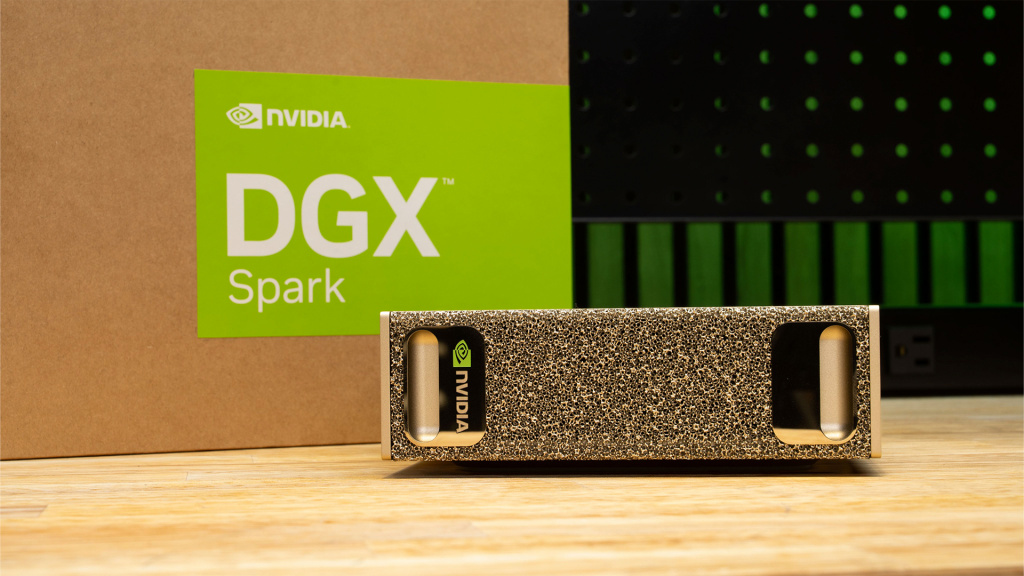
Компактный ИИ-ПК Nvidia DGX Spark. Источник: .
DGX Spark стоит особняком в этом сравнении, потому что это не дискретный ускоритель с выделенной HBM-памятью, а компактная десктопная система с унифицированной памятью объемом 128 ГБ, общей для CPU и GPU. Пропускная способность этой памяти составляет порядка 273 ГБ/с — значительно ниже, чем у B300 и MI350P. Зато сама идея Spark в другом: это доступное по цене и по форм-фактору устройство, на котором можно локально разместить модель, которая попросту не влезла бы в память большинства потребительских видеокарт.
Расчет для модели Qwen3.8-Next-Flash UD-Q4_K_XL (111 ГБ):
Ток/с = 273 ГБ/с / 111 ГБ = 2,5 Ток/с
Это на порядок меньше, чем у двух предыдущих ускорителей, несмотря на то что модель весом 111 ГБ вполне физически помещается в 128 ГБ памяти Spark. Более того, реальный запас для KV-cache здесь окажется довольно скромным: из 128 ГБ памяти нужно вычесть не только 111 ГБ весов, но и часть объема под рантайм, буферы CUDA и служебные нужды системы, так что на контекст останется не так уж много места. Для экспериментов, разработки, тестирования крупных моделей на дому без доступа к серверному железу такая скорость может быть вполне приемлема, но ожидать от Spark производительности уровня дата-центровых ускорителей не стоит. Теперь становится понятно, почему на DGX Spark, несмотря на его внушительный объем памяти, обычно запускают только компактные LLM.
Как ускорить инференс
Небольшой показатель пропускной способности — еще не приговор, ведь существует ряд методов оптимизации, которые помогут увеличить количество токенов в секунду без каких-либо аппаратных изменений в вашей системе.
- Спекулятивное декодирование. Спекулятивное декодирование использует небольшую и быструю черновую модель для генерации нескольких токенов-кандидатов. Затем основная большая модель проверяет эти кандидаты за один проход. Если кандидаты принимаются, большая модель фактически генерирует несколько токенов за один шаг, обходя последовательную зависимость. Особенно эффективно себя показывает спекулятивное декодирование DFlash, в котором в качестве черновой модели используется диффузионная нейросеть.
- Сокращение KV-кэша — методы оптимизации механизма внимания, например, grouped-query attention (GQA) или multi-query attention (MQA), заметно сокращают объем KV-cache по сравнению с классическим multi-head attention (MHA) и, соответственно, снижают расход пропускной способности памяти.
- Разделение фаз prefill и decode. Фазы prefill и decode можно вполне успешно выполнять на разных GPU. Для prefill подходят мощные GPU с большим количеством FLOPS, а для decode — GPU с высокой пропускной способностью памяти. Это позволяет подобрать оптимальное оборудование для каждой фазы и не тратить ресурсы впустую.
- Continuous Batching — метод динамического формирования батча. Вместо того чтобы ждать заполнения батча, система добавляет новые запросы по мере их поступления и удаляет завершенные. Это значительно повышает совокупную пропускную способность при высокой нагрузке.
- Квантование и оптимизация ядер. Квантование весов — самый прямой способ повлиять на количество токенов в секунду. Уменьшая размер весов, вы линейно уменьшаете объем LLM и получаете почти пропорциональный рост скорости декодирования, Современные методы квантования (FP4, FP8, GGUF) позволяют снизить размер модели в 2-4 раза с приемлемой потерей качества. Специализированные ядра под FP4 и FP8 дополнительно повышают эффективность.
Выводы
Инференс больших LLM — это не одна однородная операция, а две принципиально разные задачи. Во время фазы Prefill, когда нейросеть обрабатывает промпт, от GPU требуется хорошо распараллеливать задачи за счет высокого показателя FLOPS, а во время фазы Decode, когда модель генерирует ответ, в ход идет именно пропускная способность памяти, и именно этот параметр отвечает за то, сколько токенов в секунду вы получите в инференсе. Только понимание этих нюансов позволит вам выбрать подходящее под ваши задачи железо, сделать реалистичную оценку производительности и при необходимости применить оптимизационные инструменты. А если вы не хотите погружаться в эти тонкости, просто обратитесь к специалистам компании ServerFlow — наша команда не просто выберет оборудование, идеально подходящее под ваши задачи, но и проведет вас за руку от покупки железа до его запуска в продакшен.
