Как объединить Nvidia DGX Spark в кластер
Введение
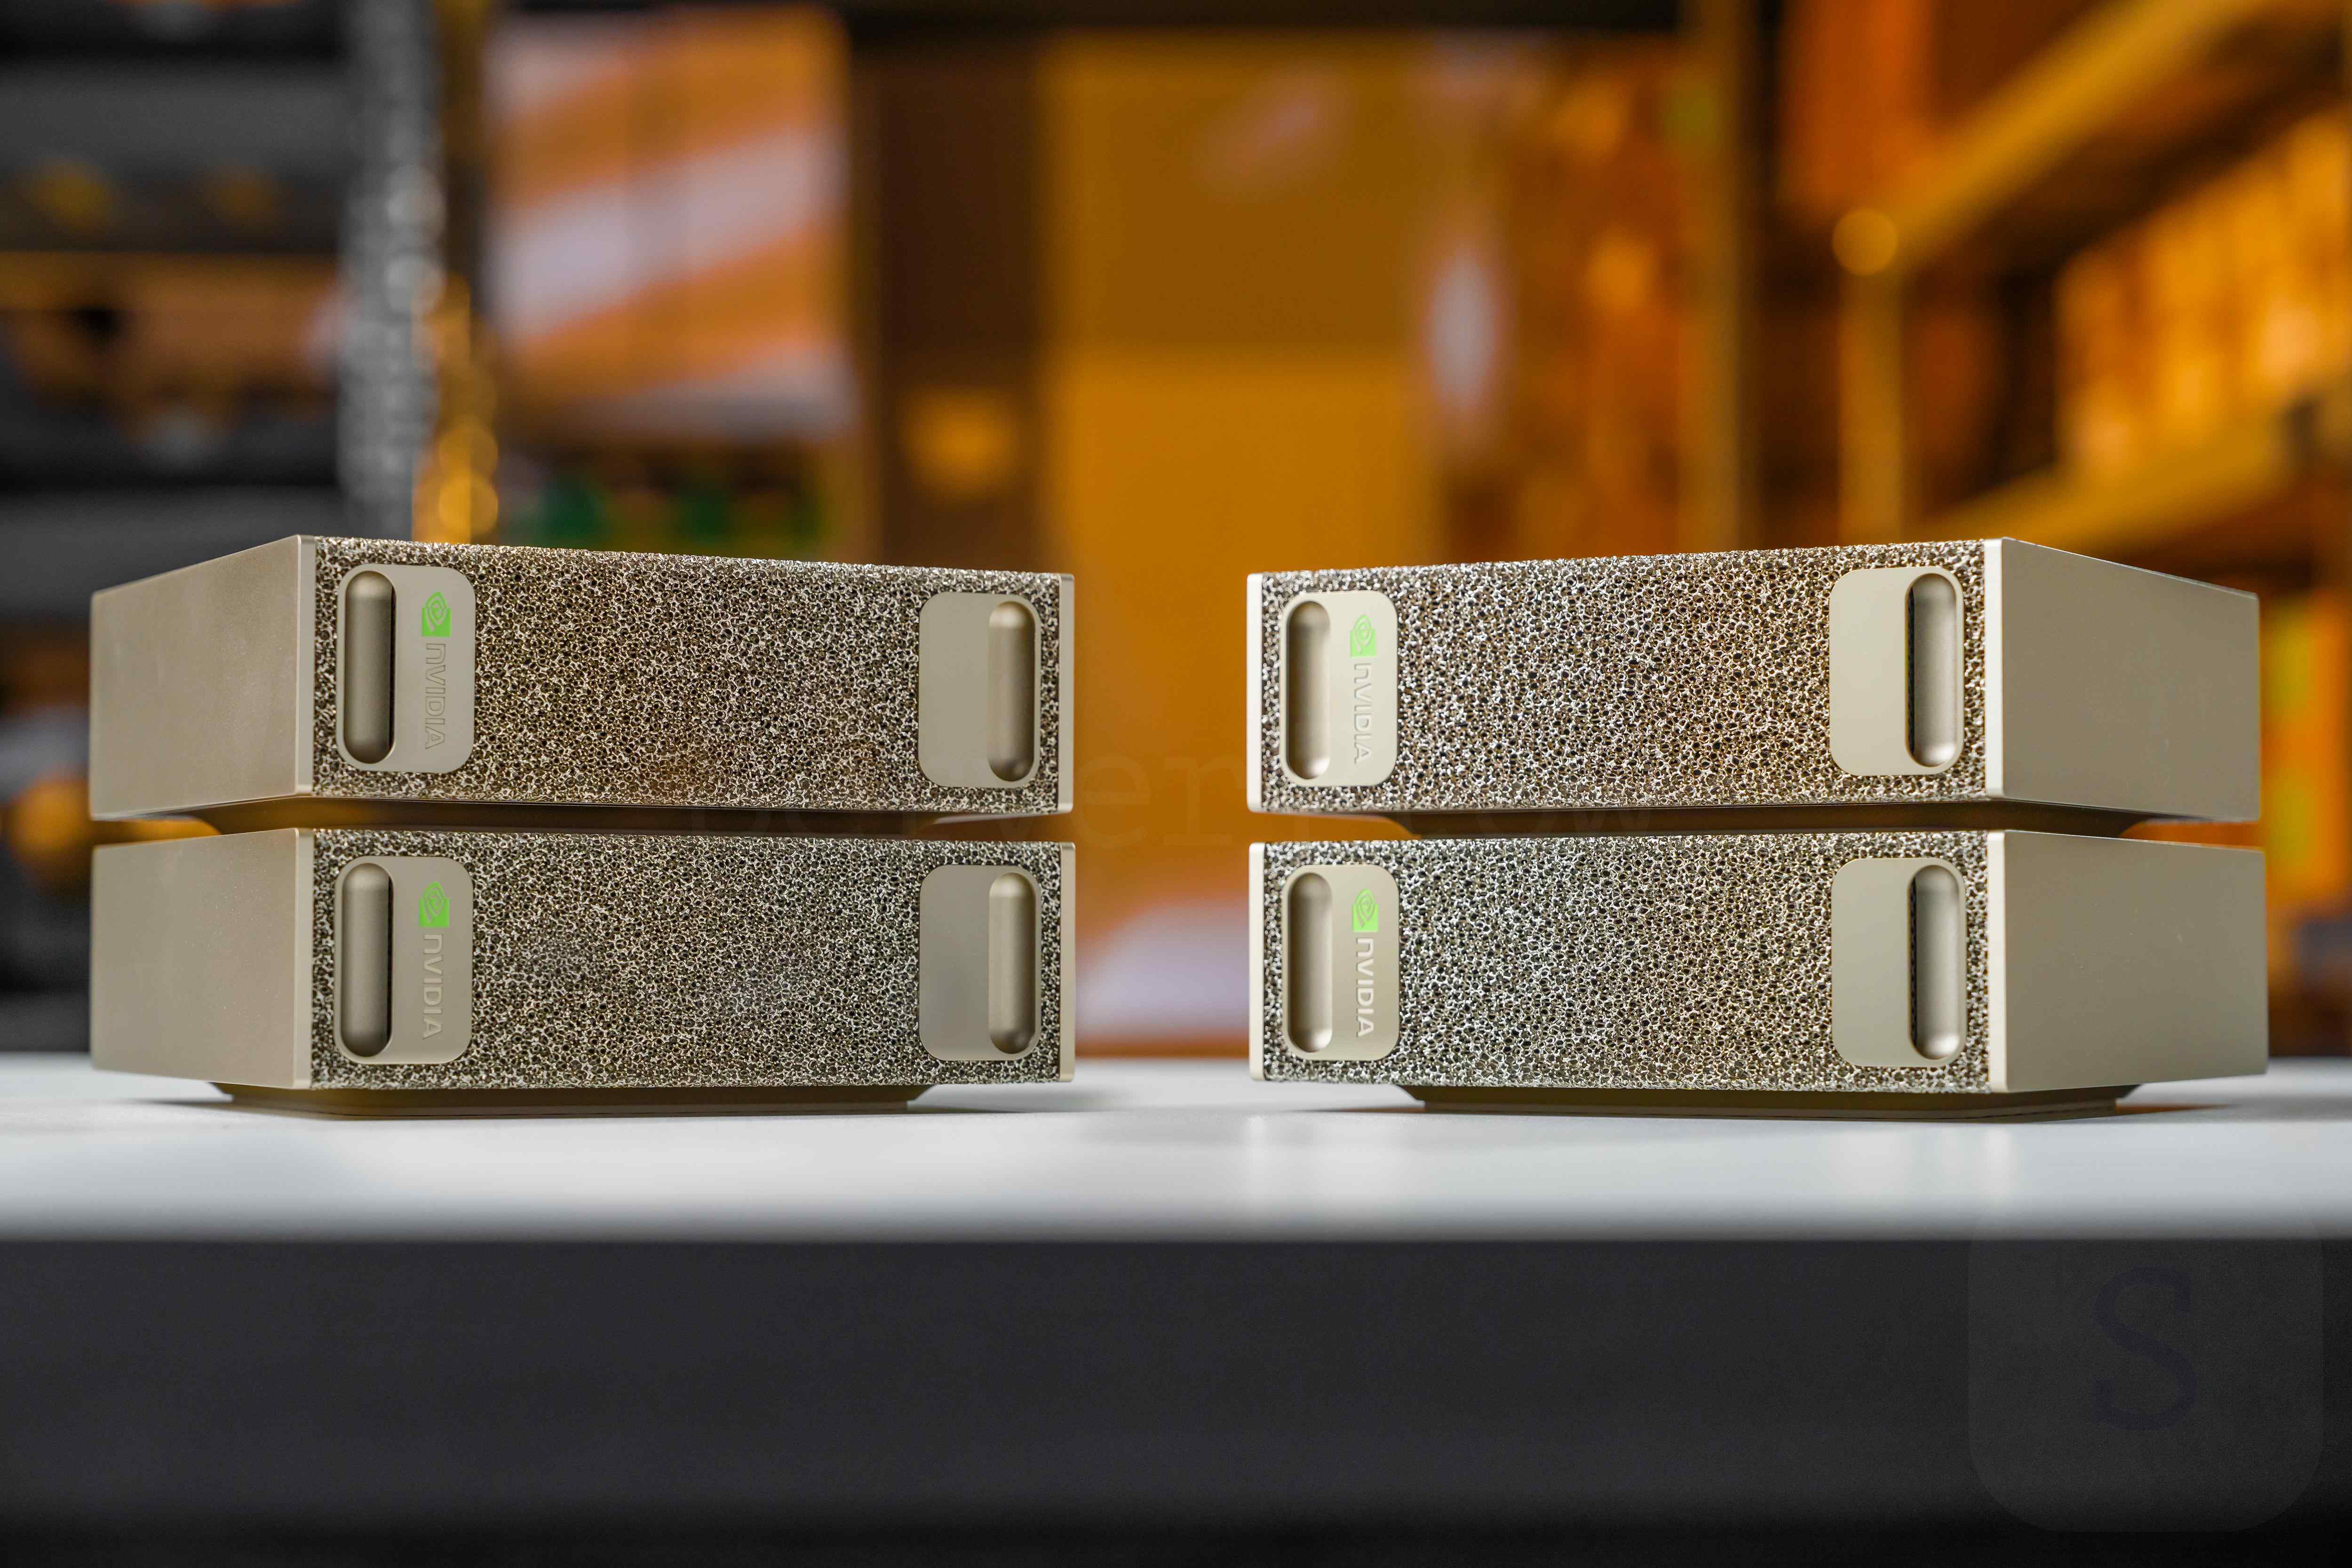
Nvidia DGX Spark всего за год превратился из игрушки для ИИ-энтузиастов в настоящий феномен: на форумах и в соцсетях все чаще мелькают всевозможные кластеры из двух, четырех, а то и восьми спарков, соединенных толстыми кабелями напрямую или через коммутатор. Это неудивительно — ИИ-модели давно вышли за пределы пула в 128 ГБ даже при квантизации NVFP4. Да и сама Nvidia подлила масла в огонь, выпустив версию на 64 ГБ, которая без кластеризации вообще непригодна для серьезного ИИ-инференса. Само собой, после такого медиа-бомбинга у вас тоже могла возникнуть мысль собрать собственный Spark-кластер, но вместе с ней появлялись и вопросы: что это вообще за порт на задней панели, какой кабель в него втыкать, нужен ли коммутатор и сколько производительности вы в итоге получите. В этой статье специалисты компании ServerFlow ответят на все эти вопросы и объяснят, как правильно соединить два, четыре и восемь DGX Spark, какие кабели и коммутаторы для этого подойдут, где можно сэкономить и чем за эту экономию придется заплатить.
Зачем вообще объединять DGX Spark
С ходу начнем с главного вопроса: зачем покупать несколько спарков, если можно взять один? Ответ — память. Один DGX Spark дает 128 ГБ унифицированной памяти, и из них часть сразу уходит на операционную систему (3-4 ГБ), а остаток уходит в рантайм. А хорошая модель сегодня весит уже куда больше 128 ГБ даже в 4-битной квантизации, не говоря уже о запасе под KV-кэш для длинного контекста. С октября 2026 года ситуация стала еще острее: из-за подорожания памяти Nvidia выпустила DGX Spark на 64 ГБ за $4999, а 128-гигабайтная версия подорожала почти до $8000. Сама Nvidia прямо продвигает 64-гигабайтную модель как систему, которую стоит покупать парами.
Кластер решает эту проблему: два спарка дают 256 ГБ памяти, четыре — 512 ГБ, восемь — целый ТБ. А поскольку каждый спарк приносит в кластер и собственную память с пропускной способностью 273 ГБ/с, вместе с объемом растет и суммарная скорость, а значит, и скорость генерации токенов. Важно: если смешать в одном кластере спарки на 128 и на 64 ГБ, на каждом узле будет доступно лишь 64 ГБ, так что расширять уже купленную 128-гигабайтную систему стоит такими же моделями.
Все это возможно благодаря одной детали, которая и отличает DGX Spark от потребительских RTX Spark. В нашей статье о различиях DGX Spark и RTX Spark мы уже рассказывали, что в RTX Spark Nvidia убрала серверную сетевую карту ConnectX-7, оставив обычный порт 10 Гбит/с. Поэтому все, о чем пойдет речь дальше, касается только DGX Spark и его партнерских версий от Dell, ASUS, Gigabyte, MSI и других производителей. Кстати, отдельная сетевая карта ConnectX-7 стоит около 150 тысяч рублей, так что изрядная часть цены спарка — это как раз его возможности масштабирования.
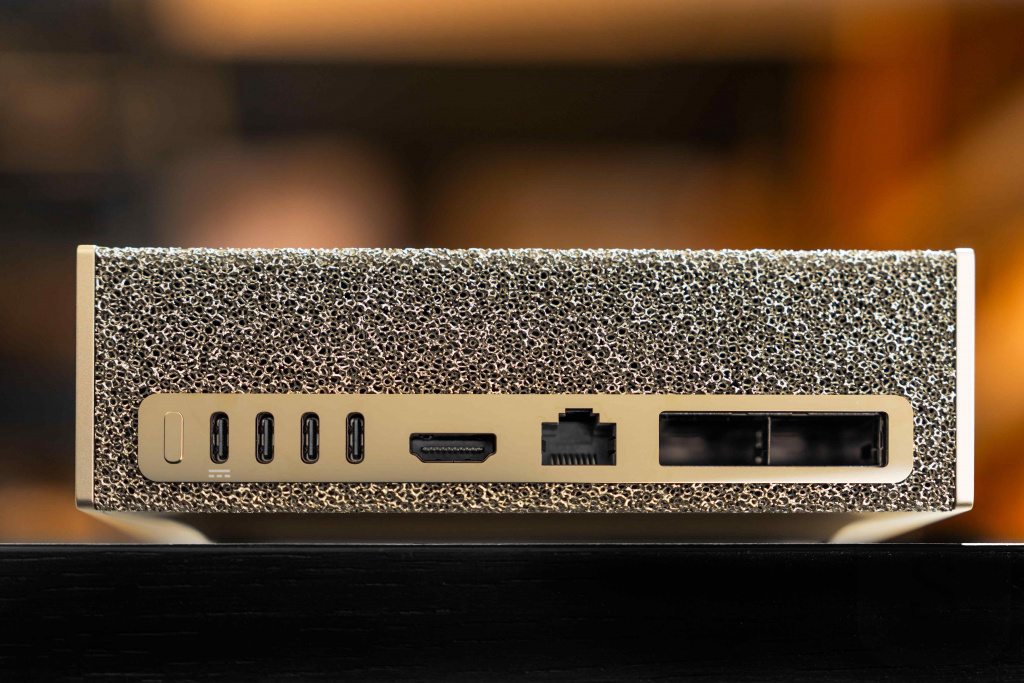
Порты встроенной сетевой карты ConnectX-7 в DGX Spark.
Что за порт стоит в DGX Spark
Прежде чем покупать кабели, разберемся, во что именно их придется втыкать. Nvidia в спецификациях скромно пишет просто "QSFP", но знатоки сразу заметят, что QSFP — это целое семейство разъемов разных поколений. На задней панели спарка стоят два порта QSFP112 — самый свежий вариант, который физически рассчитан на 400 Гбит/с (четыре линии по 100 Гбит/с). Но сетевая карта ConnectX-7 внутри спарка работает на скорости до 200 Гбит/с на порт, так что весь потенциал разъема не используется.
И тут начинается самое интересное. Чип GB10 умеет выделять одному устройству максимум четыре линии PCIe 5.0, а одна такая шина x4 пропускает около 100 Гбит/с (двунаправленно). Чтобы прокачать 200 Гбит/с, Nvidia подключила ConnectX-7 сразу к двум шинам PCIe x4 в режиме multi-host. В результате каждый физический порт в Linux отображается как два сетевых интерфейса — две "половинки" по 100 Гбит/с, каждая на своей шине PCIe.
Из этого следуют два практических вывода:
- Чтобы получить полные 200 Гбит/с, нужно задействовать обе половинки одного порта — настроить оба интерфейса в разных подсетях. Если трафик пойдет только через одну, вы упретесь примерно в 100 Гбит/с.
- Второй кабель скорость не удвоит. Обе шины PCIe вместе дают теоретически около 252 Гбит/с, так что два порта по 200 Гбит/с одновременно на полной скорости работать не смогут. Второй порт пригодится для топологии "кольцо", а не для ускорения связи между двумя спарками.
Хорошая новость в том, что вручную разбираться со всеми интерфейсами не обязательно: утилита Nvidia Sync Cluster Assistant и скрипты из официальных плейбуков Nvidia настраивают сеть автоматически.
Два DGX Spark
С портом разобрались, теперь перейдем к самому простому сценарию — двум спаркам, соединенным напрямую. Здесь не нужен ни коммутатор, ни сложная настройка: берете DAC-кабель QSFP112 — QSFP112 и соединяете один порт первого спарка с портом второго. Длины в полметра для двух устройств, стоящих друг на друге, хватает с запасом — например, подойдет кабель 10Gtek QSFP112 400G на 0,5 м.
Можно ли взять любой кабель с подходящим разъемом? К сожалению, не всегда. Сетевые карты Nvidia, как и большинство серверного сетевого оборудования, проверяют идентификатор, прошитый в чипе на конце кабеля или трансивера, и могут отказаться работать с "неродным" кабелем. Выхода тут два. Первый — купить оригинальный кабель Nvidia, но он обойдется в два-три раза дороже аналогов. Второй — взять кабель у нас: в ServerFlow мы прошиваем кабели идентификатором нужного производителя, так что они сразу работали со спарком как родные.
С программной стороны точка-точка — самая выгодная топология. Между спарками нет ни коммутатора, ни лишних пересылок, поэтому задержки минимальны, а это критично для распределения модели между устройствами, о котором мы поговорим ниже. По данным Nvidia, два напрямую соединенных спарка генерируют токены в 1,84 раза быстрее, чем один, — очень близко к идеальному удвоению.
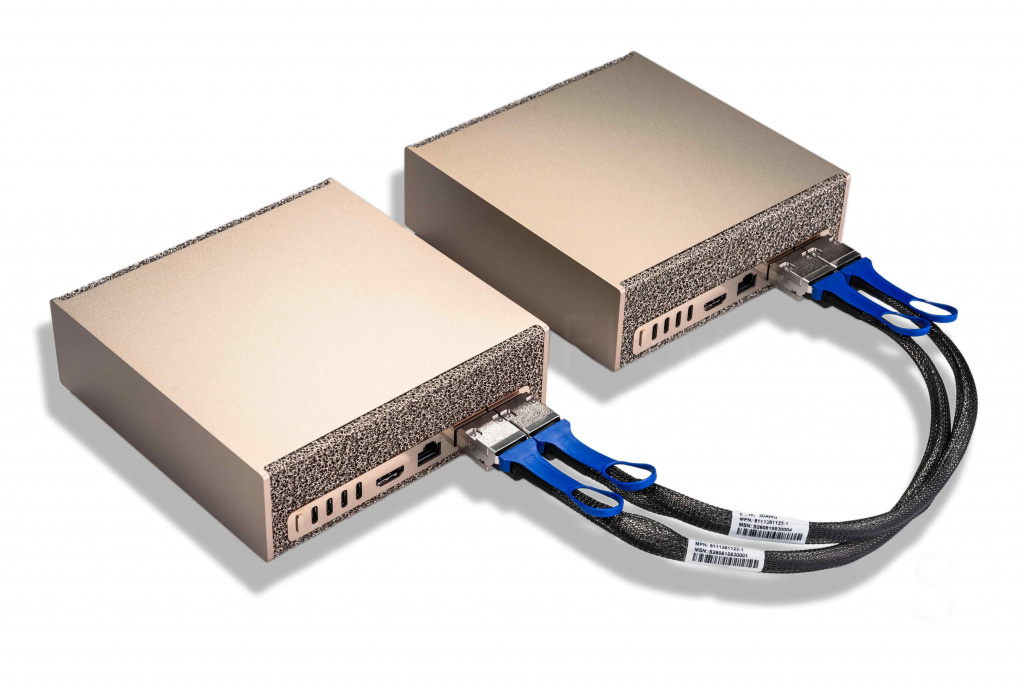
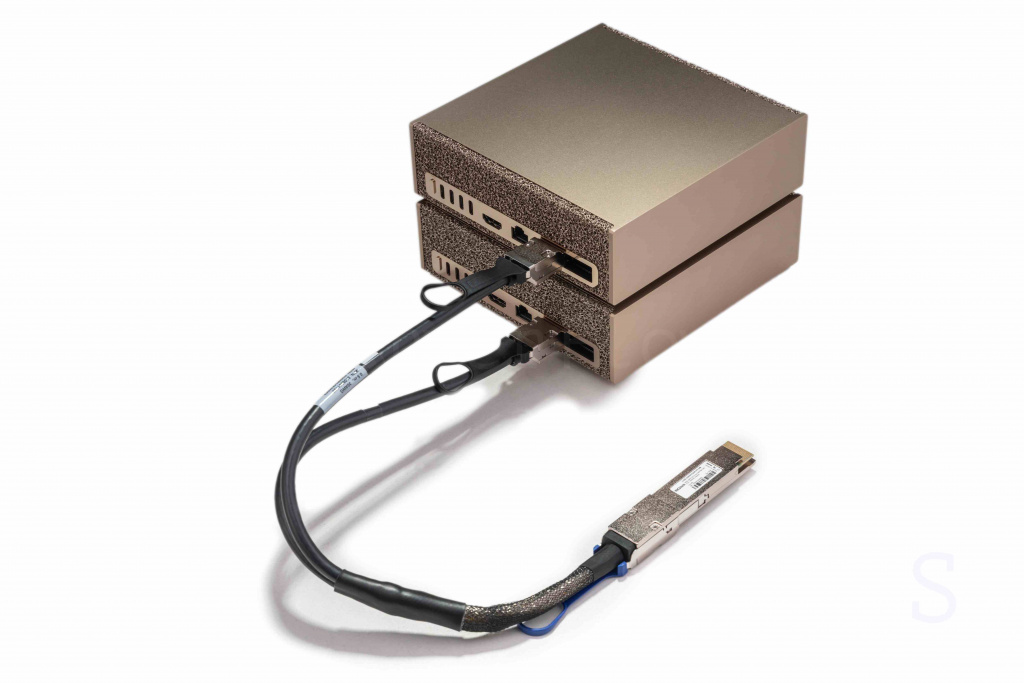
Кластер из двух DGX Spark, объединенных напрямую.
Альтернативне кабели
Но раз QSFP — это целое семейство, напрашивается вопрос: нельзя ли сэкономить? QSFP112 физически совместим с разъемами предыдущих поколений: QSFP56 (200 Гбит/с), QSFP28 (100 Гбит/с) и QSFP+ (40 Гбит/с). Знатоки знают, что если согласовать на сетевой карте пониженную скорость, можно использовать и более простые кабели. Такие кабели у нас тоже есть в наличии, но с нюансами:
- QSFP56, 200 Гбит/с — например, кабель 10Gtek QSFP56 200G на 1 м. Скорость та же, что и у спарка, так что потерь по пропускной способности нет. Но нативный QSFP112 все же надежнее с точки зрения совместимости.
- QSFP28, 100 Гбит/с — например, кабель 10Gtek QSFP28 на 1 м. Пропускная способность падает вдвое: в коллективных операциях NCCL вместо примерно 24 ГБ/с, которые спарки показывают на 200 Гбит/с, можно рассчитывать лишь на 12 ГБ/с.
- QSFP+, 40 Гбит/с — пропускная способность падает в пять раз, около 5 ГБ/с.
Насколько это скажется на инференсе? Опубликованных тестов Spark на 100 и 40 Гбит/с мы не нашли, поэтому можем дать лишь качественную оценку. При генерации токенов для одного пользователя между Spark на каждом слое модели передаются небольшие порции данных, и здесь важнее задержка, чем ширина канала, так что потери будут заметны, но не в разы. А вот загрузка модели, обработка длинных промптов, работа с большим числом параллельных запросов и тем более обучение упираются именно в пропускную способность — тут 100 Гбит/с уже ощутимо притормозят кластер, а 40 Гбит/с превратят его в узкое горлышко.
Поэтому соединяйте Spark нативным кабелем QSFP112 и не мучайтесь. Обходные пути работают, но если вы хотите, чтобы все работало как по маслу без костылей, без QSFP112 не обойтись.
Три и более DGX Spark
С двумя DGX Spark все просто, но что делать, если их три, четыре или восемь? Вариантов два.
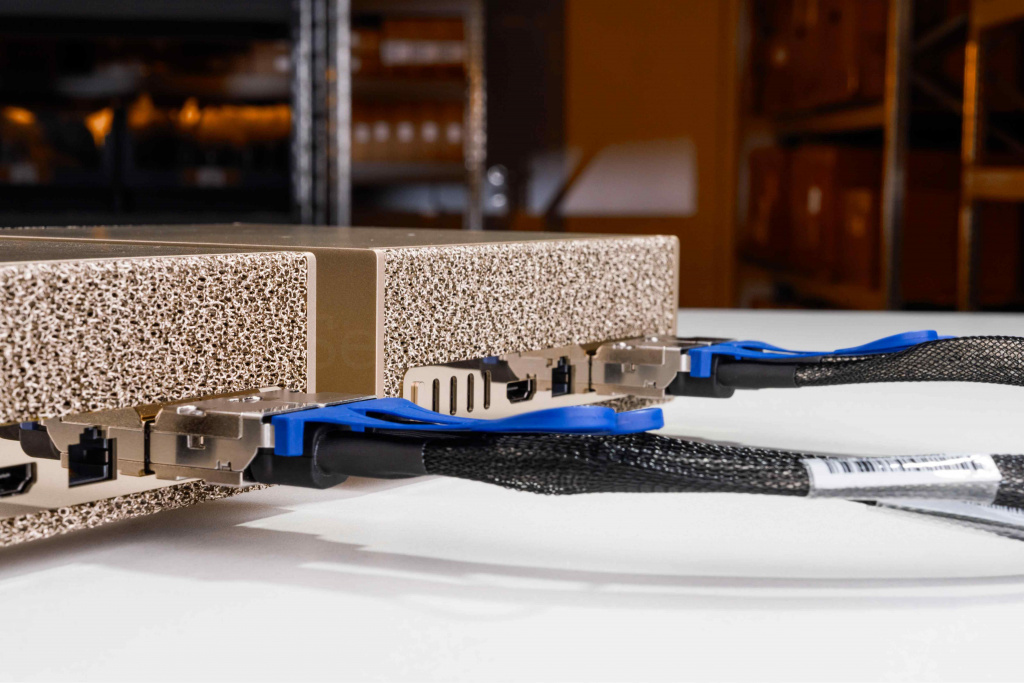
- Кольцо без коммутатора. У каждого Spark два порта, так что их можно соединить напрямую “кольцом”: первый со вторым, второй с третьим и так далее, а последний с первым. Nvidia официально поддерживает такую схему для трех Spark, а в собственных тестах использует кольцо и на четырех, и на восьми узлах. Для запуска одной модели на всех Spark кольцо работает вполне прилично, ведь библиотека NCCL как раз и передает данные по кольцу. Но у этой схемы есть ограничения. Оба порта Spark делят между собой одну и ту же пропускную способность около 200 Гбит/с, так что на каждого соседа приходится меньше. Данные между дальними узлами идут транзитом через промежуточные DGX Spark. А разделить кольцо на независимые группы, скажем, запустить две разные модели на двух парах спарков, уже не получится.
Кольцевое объединение DGX Spark без коммутатора.
- Коммутатор. Это универсальный вариант: каждый Spark подключается к коммутатору одним кабелем, и любой узел может напрямую общаться с любым другим. Именно коммутатор нужен для кластера из восьми Spark, для разделения кластера на группы и для специальных ускоренных алгоритмов обмена данными, о которых мы расскажем ниже. Nvidia в своих инструкциях требует коммутатор с портами не ниже 200 Гбит/с и разрешает использовать порты 400 Гбит/с, разделенные breakout-кабелем на два по 200 Гбит/с.
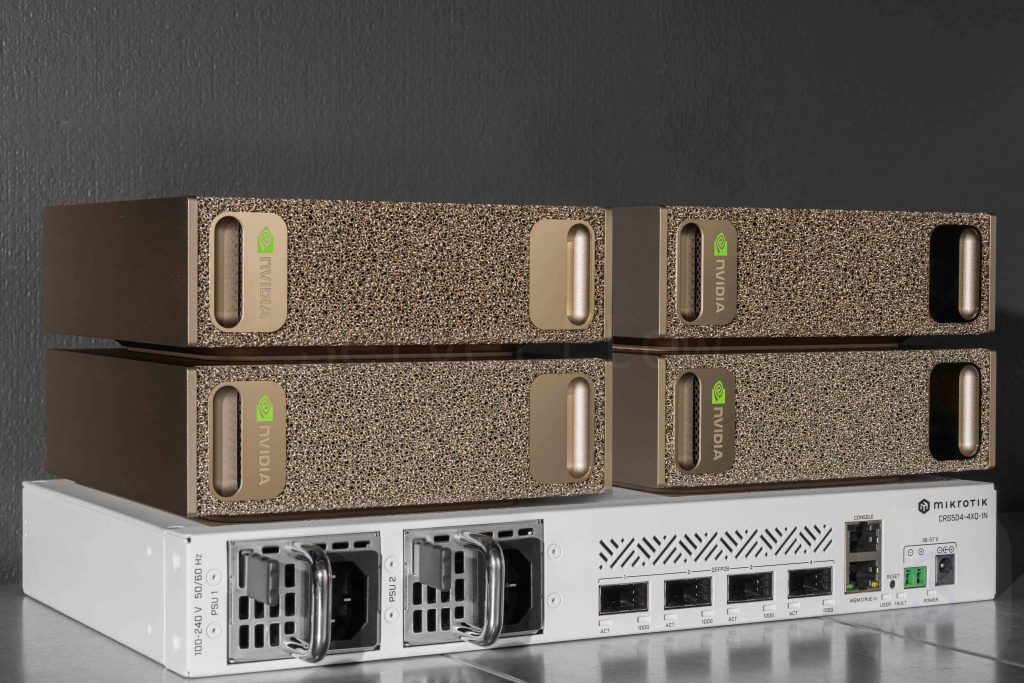
Кластер из четырех DGX Spark, объединенных через коммутатор.
И вот тут есть небольшое “но”. Коммутаторы с портами QSFP112 — это настоящее энтерпрайз-железо для ЦОД: десятки портов, корпус размером с сервер и шум, как у взлетающего самолета. Ставить такую бандуру рядом с парой тихих настольных Spark — то еще удовольствие, да и стоит она совсем не как аксессуар. На GTC Nvidia, правда, показывала компактный коммутатор, но никаких подробностей о нем пока нет. Поэтому для домашней лаборатории или небольшого офиса придется смотреть на решения попроще.
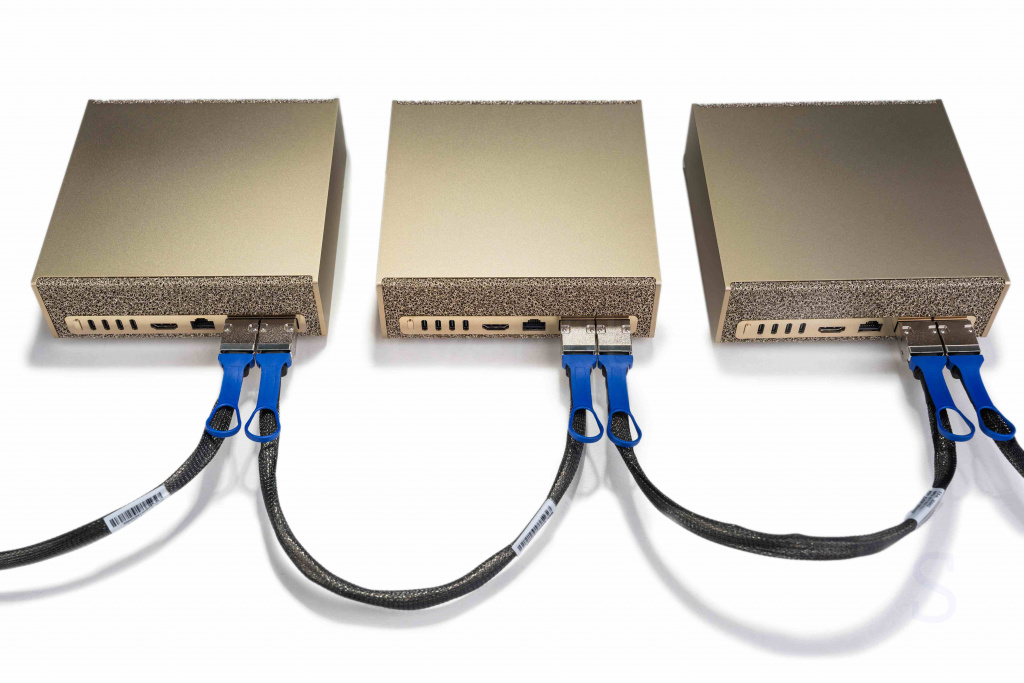
Кластер из трех DGX Spark, объединенных по кольцу.
Коммутаторы MikroTik
Если энтерпрайз-коммутаторы — это перебор, то градус можно слегка понизить с помощью народного оборудования MikroTik. Их коммутаторы не такие технологичные, как сетевое железо Nvidia, зато компактные, относительно тихие и под сценарий небольшого кластера DGX Spark подходят идеально. Мы подобрали два варианта.
MikroTik CRS504-4XQ-IN
MikroTik CRS504-4XQ-IN — компактный коммутатор с четырьмя портами QSFP28 по 100 Гбит/с. Он позволяет объединить до четырех DGX Spark, но каждый будет подключен на скорости 100 Гбит/с вместо 200, а значит, и потери будут ровно те, о которых мы говорили в разделе про кабели попроще. Зато главные плюсы — цена и доступность: коммутатор есть в наличии, а мы подберем к нему кабели, прошьем их и отдадим полностью готовое решение. Для домашней лаборатории это отличный вариант, когда бюджет важнее последних процентов производительности.
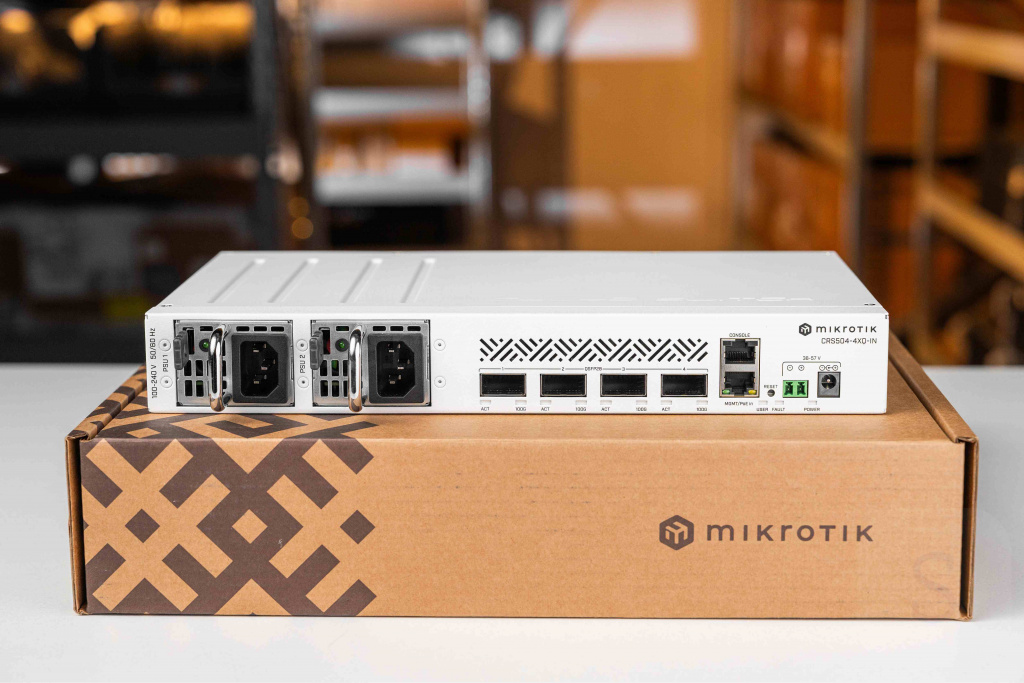
Коммутатор MikroTik CRS504-4XQ-IN для кластеризации DGX Spark.
MikroTik CRS804 DDQ
MikroTik CRS804 DDQ стоит на порядок дороже MikroTik CRS504-4XQ-IN, но и возможностей у него куда больше. Это 1U-коммутатор с четырьмя портами QSFP56-DD по 400 Гбит/с, двумя вентиляторами и энергопотреблением всего до 123 Вт. Каждый порт 400 Гбит/с с помощью breakout-кабеля делится на два по 200 Гбит/с, так что к одному коммутатору можно подключить до восьми DGX Spark на полной скорости. По сути, это идеальный коммутатор для кластера DGX Spark, полностью укладывающийся в требования Nvidia.
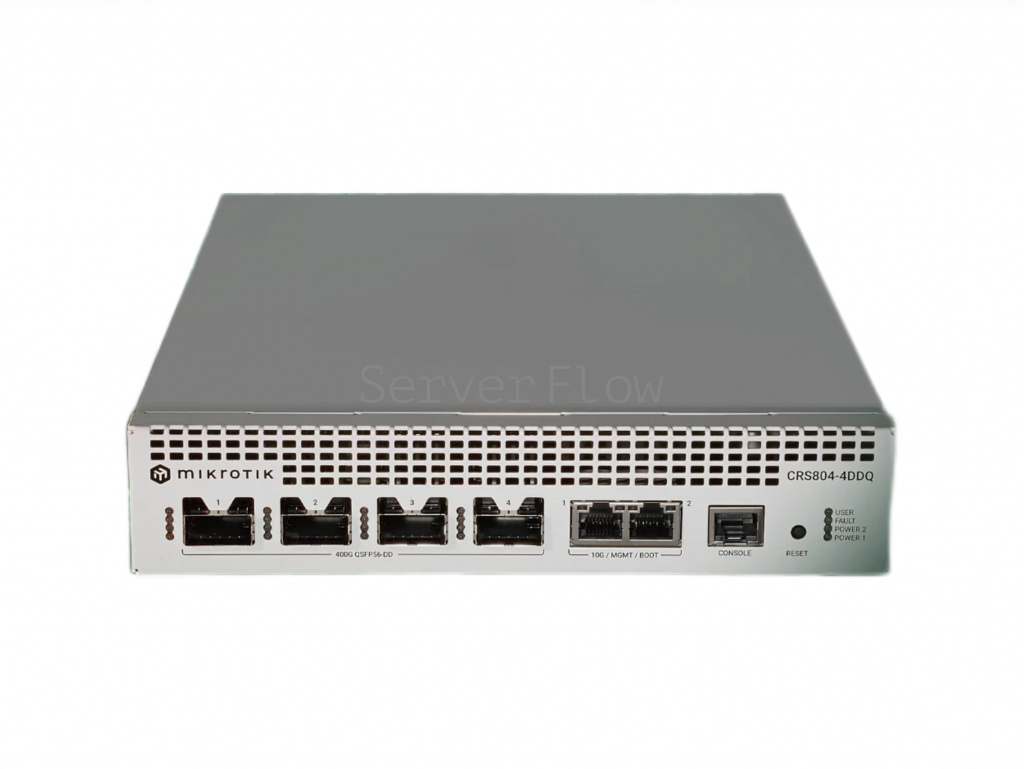
Топовый коммутатор MikroTik CRS804 DDQ для объединения DGX Spark в кластер.
Для такой сборки понадобится breakout-кабель 10Gtek QSFP-DD 400G на 2 x QSFP56 длиной 0,5 м. Почему на концах QSFP56, а не QSFP112? Потому что breakout-кабелей с концами QSFP112 на рынке практически нет, а QSFP56 дает те же 200 Гбит/с, которые нужны DGX Spark. В России такой кабель сейчас доступен только в ServerFlow.
Breakout-кабель 10Gtek QSFP-DD 400G на 2 x QSFP56.
Есть, правда, одна загвоздка: сам CRS804 DDQ в России сейчас не продается, потому что для него пока нет разрешительных документов на ввоз (на момент выхода статьи). Как только документы появятся, мы его привезем — по нашим данным, это может произойти в 2027 году. Будем надеяться, что DGX Spark к тому моменту не устареют.
Как модель делится между DGX Spark
С железом разобрались, но соединить спарки кабелем — только полдела. Дальше инференс-движок должен как-то распределить модель между устройствами, и способов для этого несколько:
- Тензорный параллелизм (TP). Каждый слой модели разрезается на части, и каждый DGX Spark хранит и считает свой кусок. Все устройства работают над каждым токеном одновременно, а после каждого слоя обмениваются результатами через операцию all-reduce. Плюс в том, что суммируется пропускная способность памяти всех DGX Spark, и генерация реально ускоряется. Минус — обмен данными происходит десятки раз на каждый токен, поэтому TP очень чувствителен к задержкам сети.
- Конвейерный (пайплаин) параллелизм (PP). Модель делится по слоям: первый DGX Spark считает первую половину слоев, второй — вторую. Данных передается гораздо меньше, но при запросе от одного пользователя DGX Spark работают по очереди и ждут друг друга, так что скорость генерации почти не растет. Этот способ хорош, чтобы просто уместить большую модель, или когда запросов много.
- Экспертный параллелизм (EP). Для MoE-моделей эксперты распределяются по разным DGX Spark. Здесь много обмена данными "каждый с каждым", так что такой схеме особенно нужен коммутатор.
- Реплики. Если модель помещается на один-два DGX Spark, можно запустить несколько ее копий и распределять между ними запросы. Скорость для одного пользователя не вырастет, зато суммарная производительность кластера увеличится в разы.
Чем это все запускать? Самый популярный вариант — vLLM: у Nvidia есть официальная инструкция по запуску vLLM на кластере спарков, а один из инженеров компании поддерживает открытый проект spark-vllm-docker, который упрощает развертывание. Для многоузлового режима vLLM использует фреймворк Ray, а для обмена данными между DGX Spark — библиотеку NCCL поверх RoCE. Кроме того, распределенный инференс поддерживают SGLang и TensorRT-LLM, а в llama.cpp есть режим RPC — он проще в настройке, но заметно медленнее.
Сколько на самом деле дает кластер
Теперь самый интересный вопрос: насколько быстрее работает кластер? В теории все просто. Скорость генерации токенов упирается в пропускную способность памяти, а у каждого Spark она составляет 273 ГБ/с. Значит, два DGX Spark дают 546 ГБ/с, четыре — около 1,1 ТБ/с, восемь — около 2,2 ТБ/с, и в идеальном мире генерация должна ускоряться ровно в 2, 4 и 8 раз. На практике часть времени уходит на обмен данными по сети, и прирост получается скромнее.
В октябре 2026 года Nvidia официально поддержала кластеры из восьми DGX Spark и опубликовала результаты масштабирования на плотной модели Qwen3.8-27B в формате NVFP4 при одном пользователе:
|
DGX Spark |
Топология |
Генерация, ток/с |
Прирост генерации |
Прирост обработки промпта |
|
1 |
— |
11,9 |
1,00x |
1,00x |
|
2 |
Напрямую |
21,7 |
1,84x |
1,25x |
|
4 |
Кольцо |
32,8 |
2,77x |
1,69x |
|
4 |
Коммутатор |
36,3 |
3,06x |
1,73x |
|
8 |
Кольцо |
40,1 |
3,38x |
1,88x |
|
8 |
Коммутатор |
52,6 |
4,43x |
1,94x |
Вот и получается, что два DGX Spark почти удваивают скорость, а дальше эффективность постепенно падает: на восьми узлах вместо восьмикратного прироста выходит 3,4–4,4 кратный прирост. Обработка промпта масштабируется еще хуже, ведь она упирается в вычислительную мощность, а не в память. Обратите внимание и на разницу между топологиями: с коммутатором кластер работает заметно быстрее. Это заслуга нового алгоритма обмена данными RoCEnante, который Nvidia разработала специально для Spark. Он сокращает задержки при тензорном параллелизме, но работает только тогда, когда все узлы соединены через коммутатор.
Выводы
Кластер из DGX Spark — это вполне рабочий способ запускать локально модели, которые не помещаются в память одного устройства, и с каждым обновлением ПО Nvidia делает его все удобнее. Для двух DGX Spark все предельно просто: один нативный кабель QSFP112, правильно настроенные половинки порта — и вы получаете почти двукратный прирост скорости генерации. Для трех-четырех DGX Spark можно обойтись кольцом без коммутатора, но если вы планируете дорасти до восьми узлов, без коммутатора не обойтись. Помните, что кластер в первую очередь дает память, а не скорость: прирост производительности с каждым новым узлом становится все меньше, так что считать бюджет стоит от размера модели, которую вы хотите запустить. А если вы хотите приобрести несколько DGX Spark для кластера, обращайтесь к специалистам компании ServerFlow. Мы подберем кабели и коммутатор под нужное количество DGX Spark, прошьем все, что нужно прошить, и проведем вас за руку от покупки оборудования до запуска первой модели на кластере.
