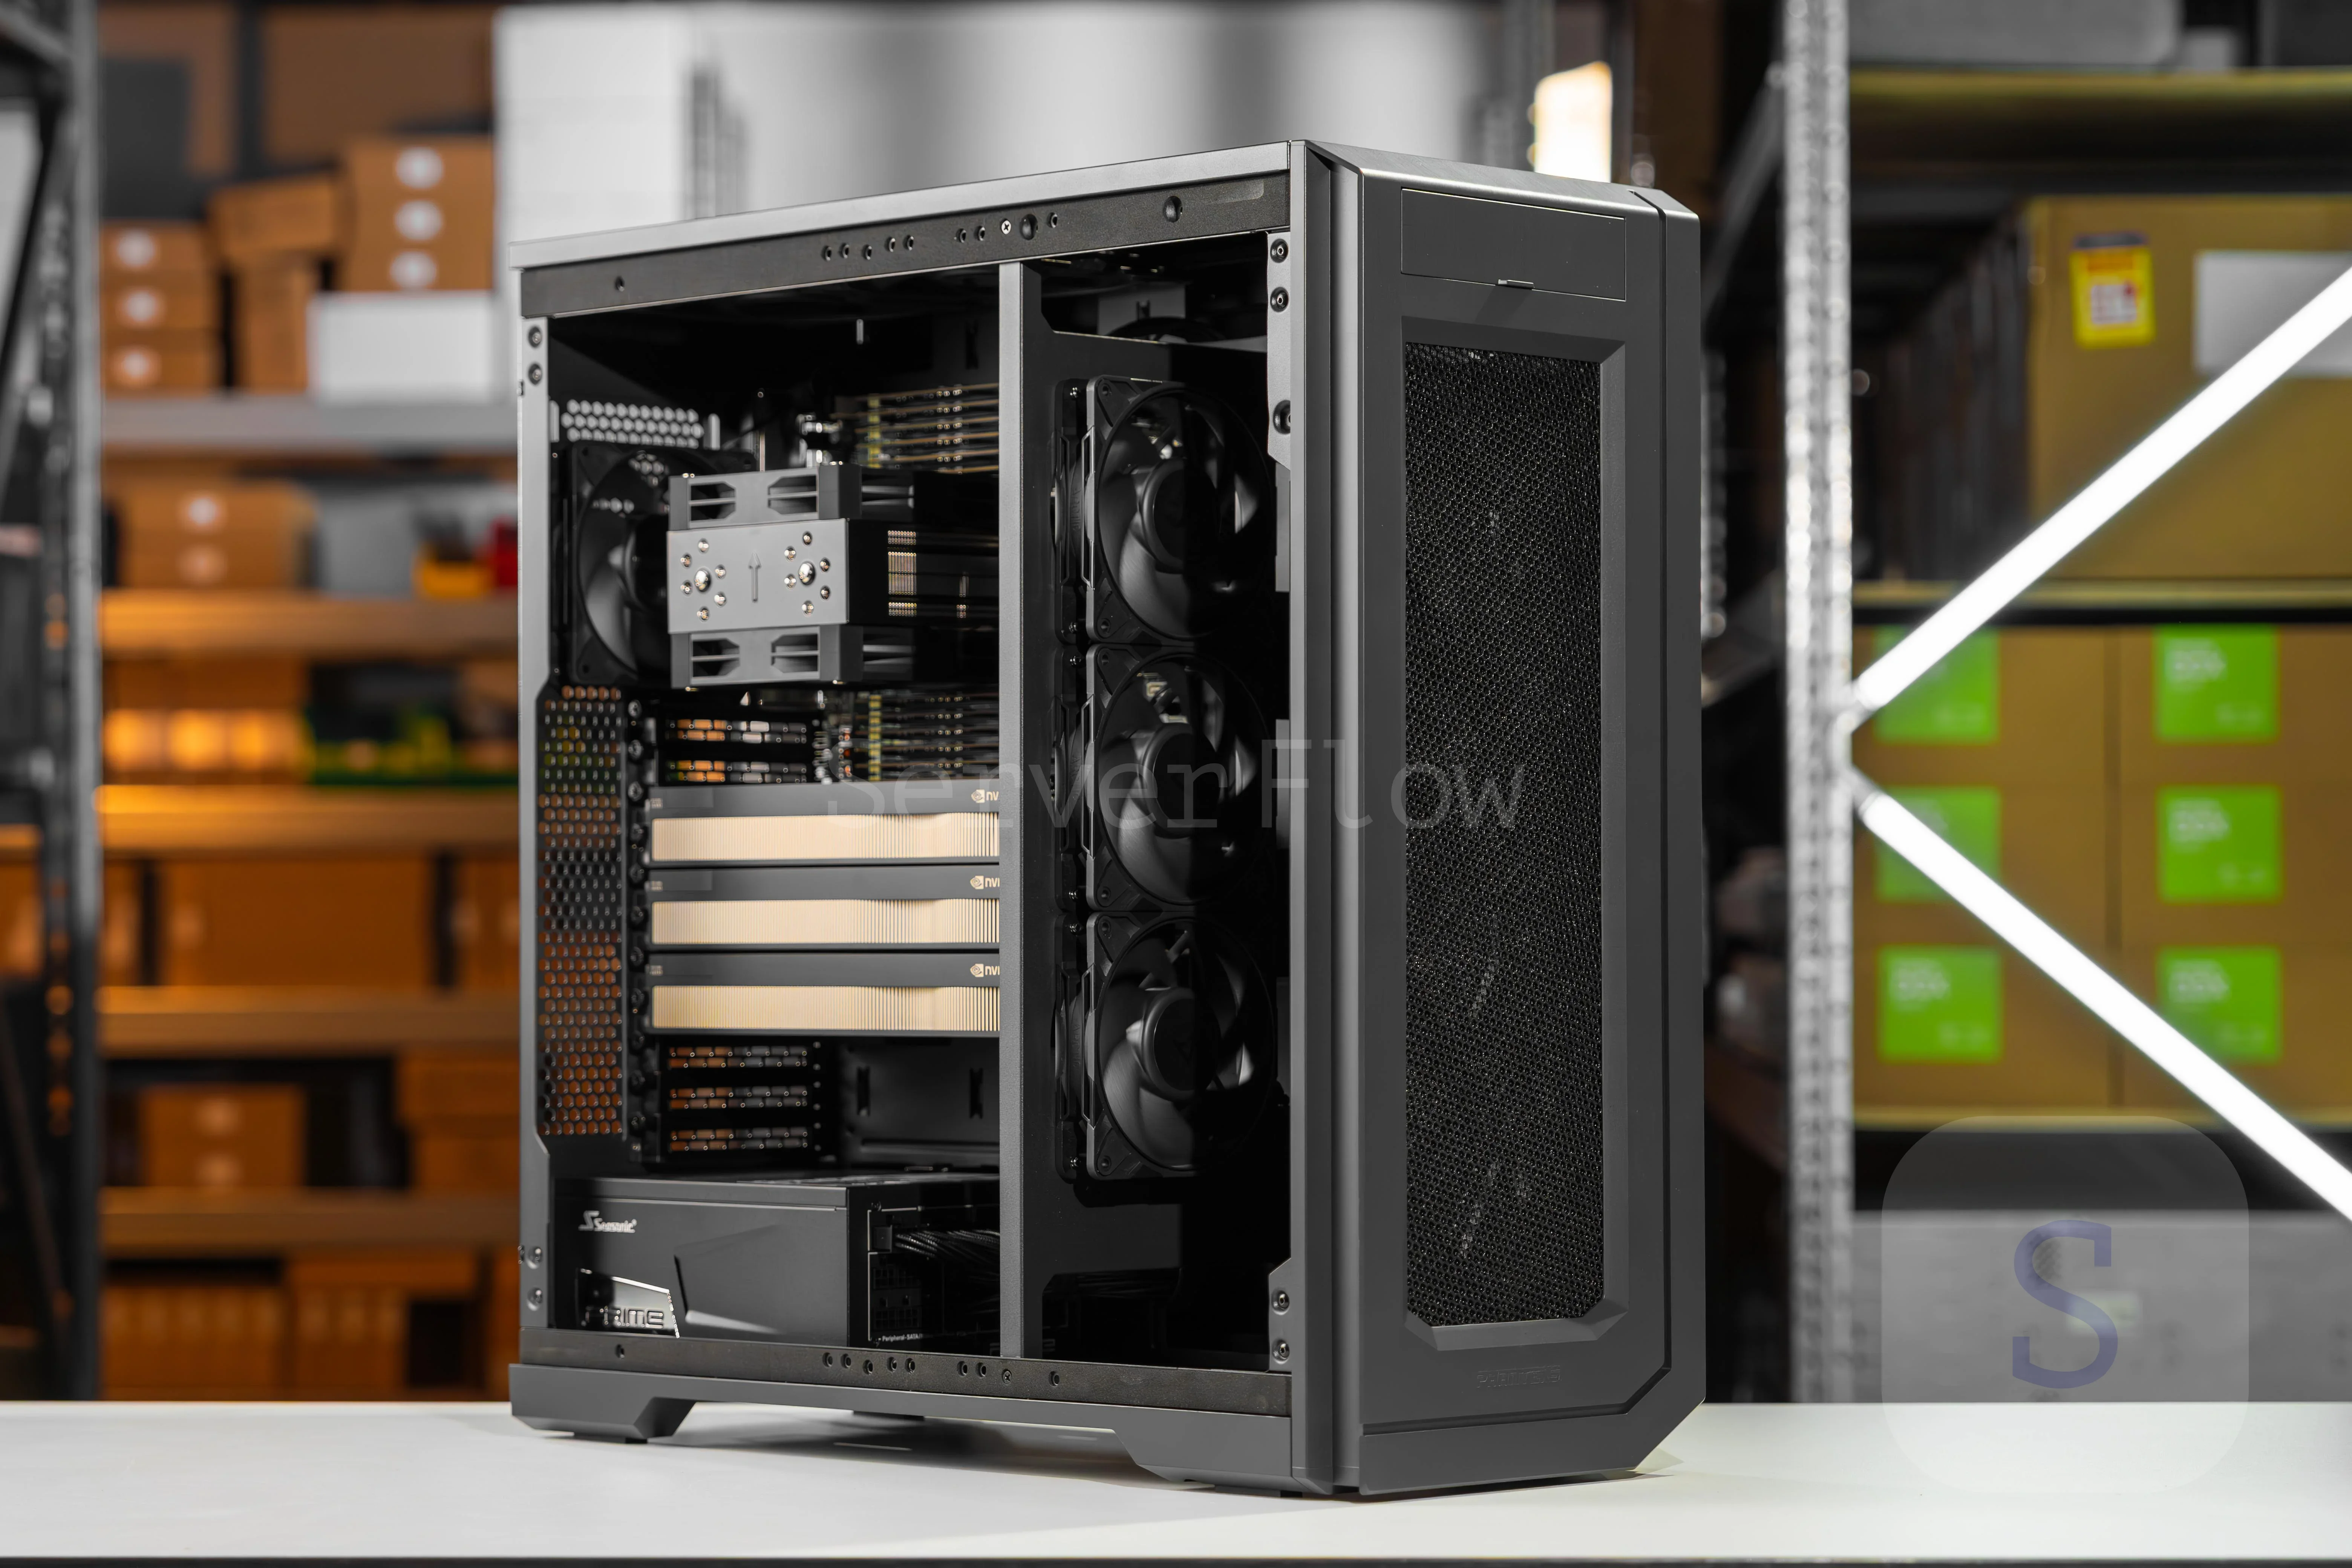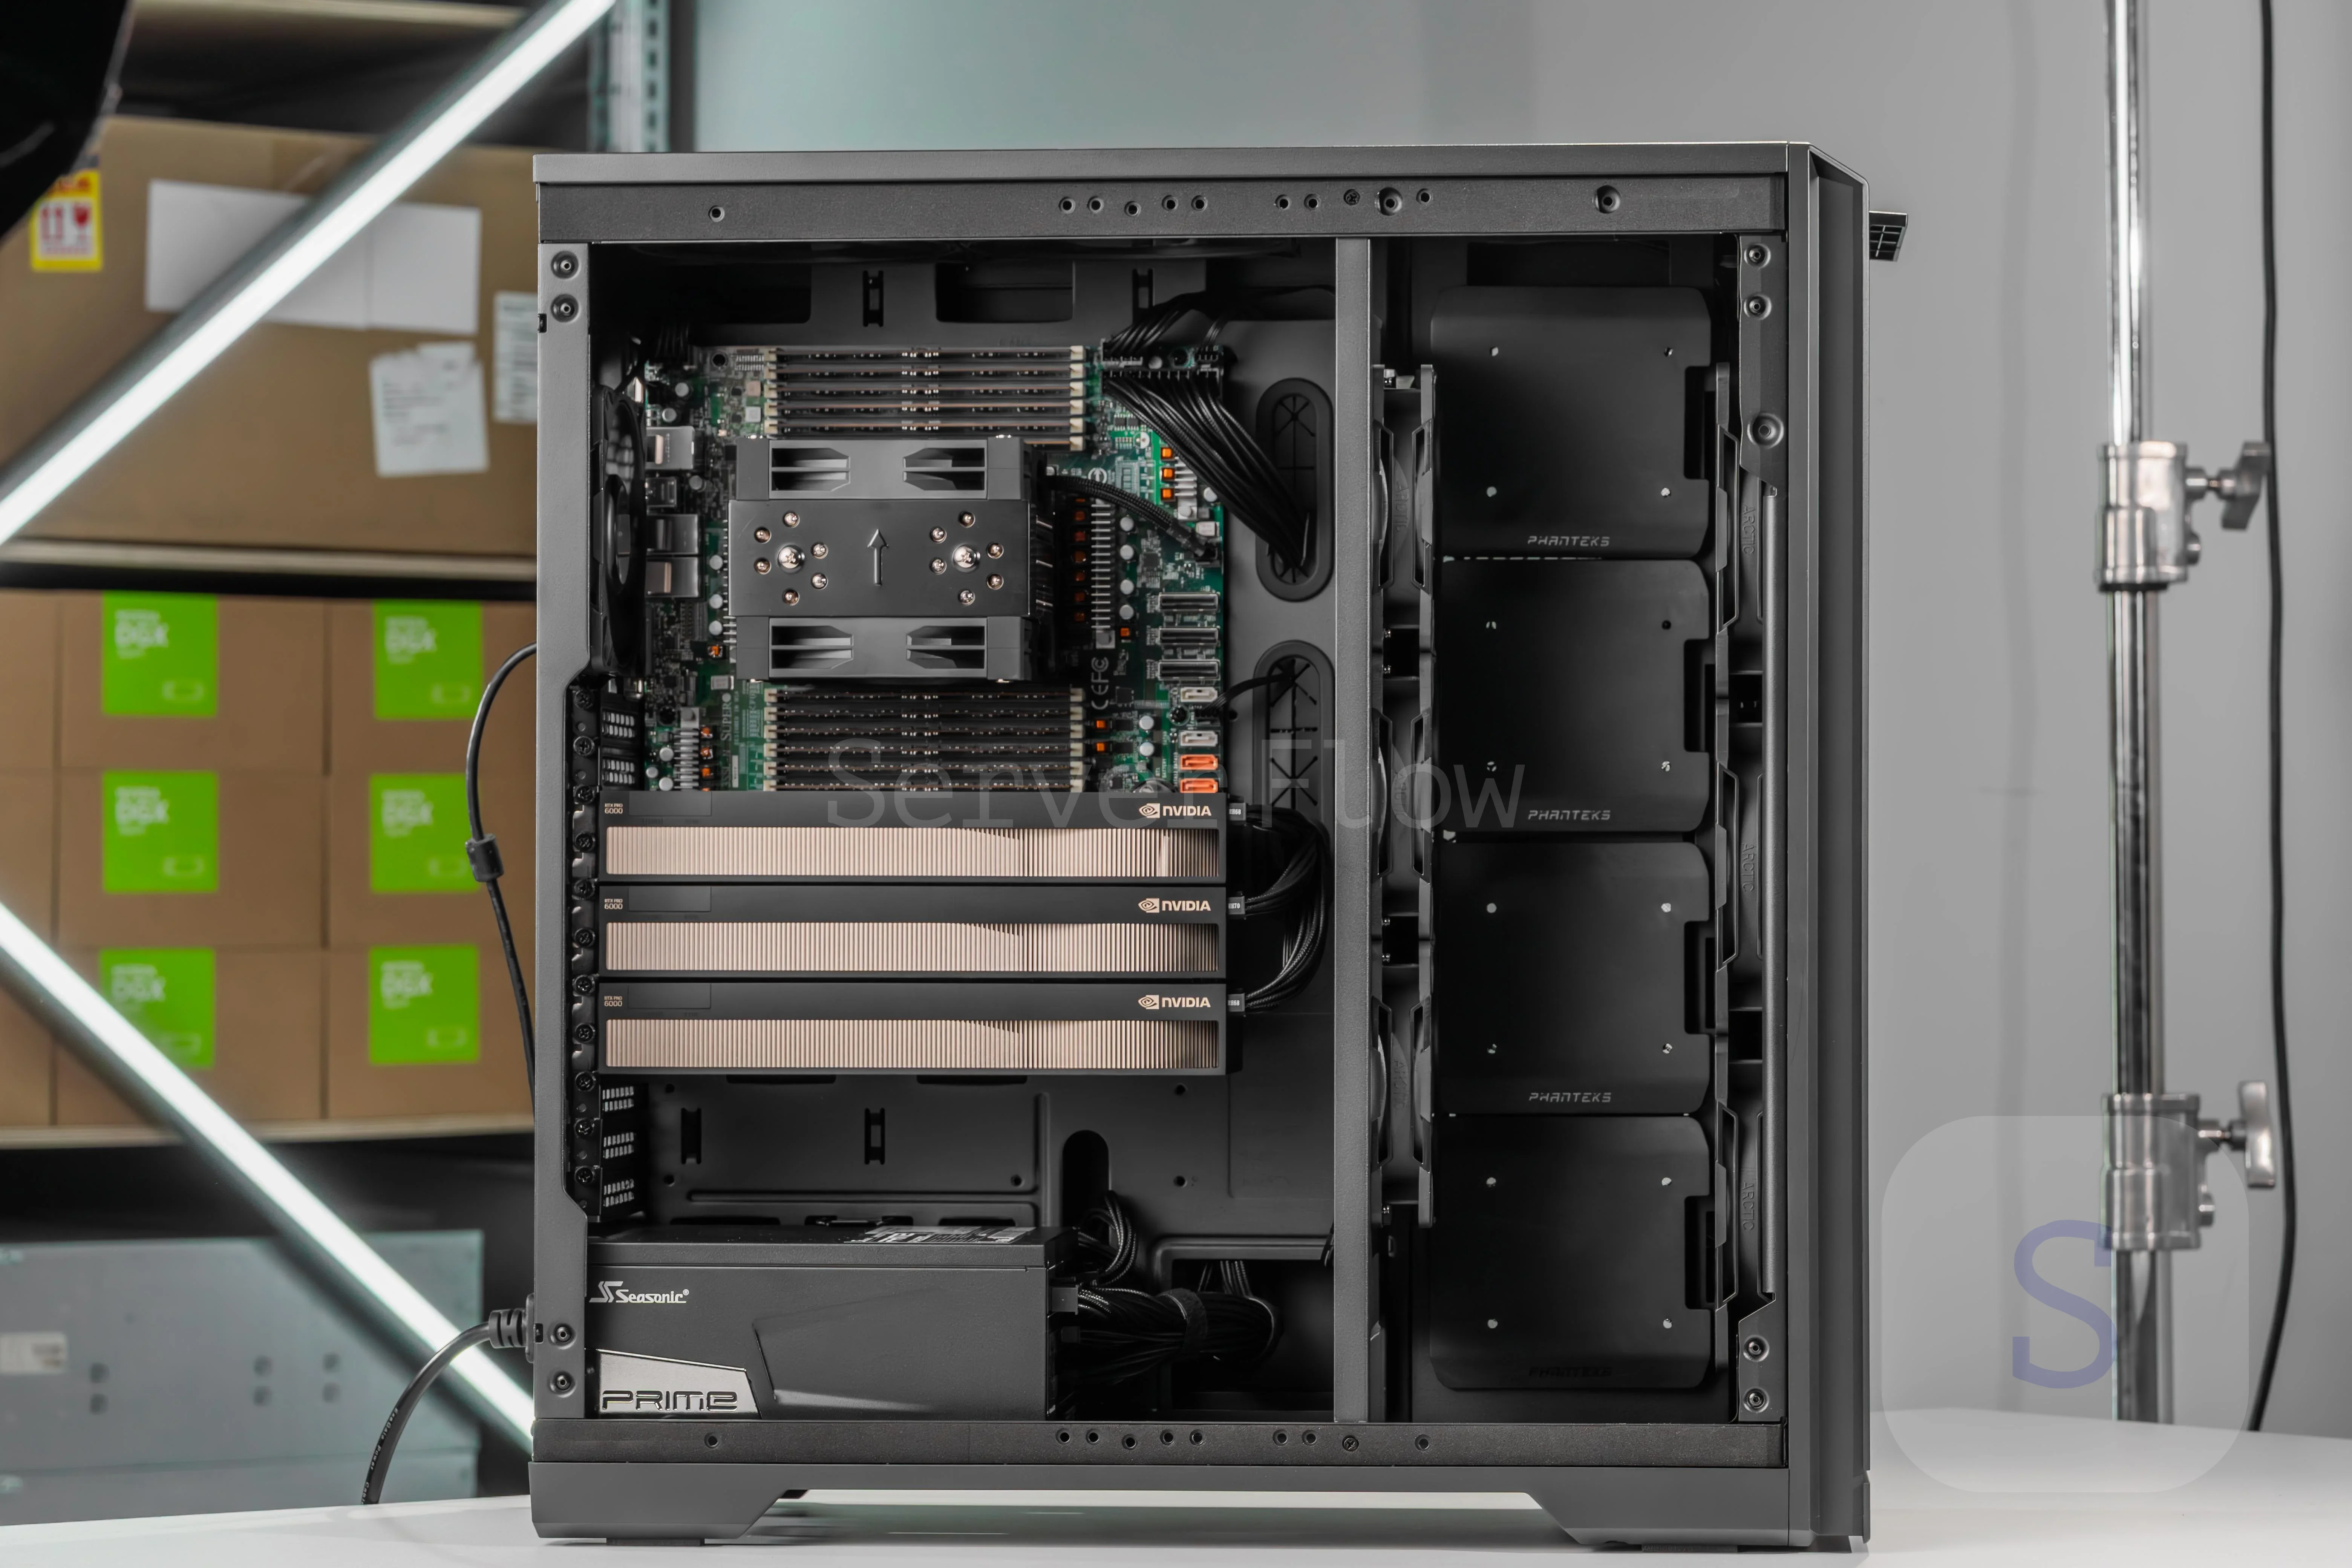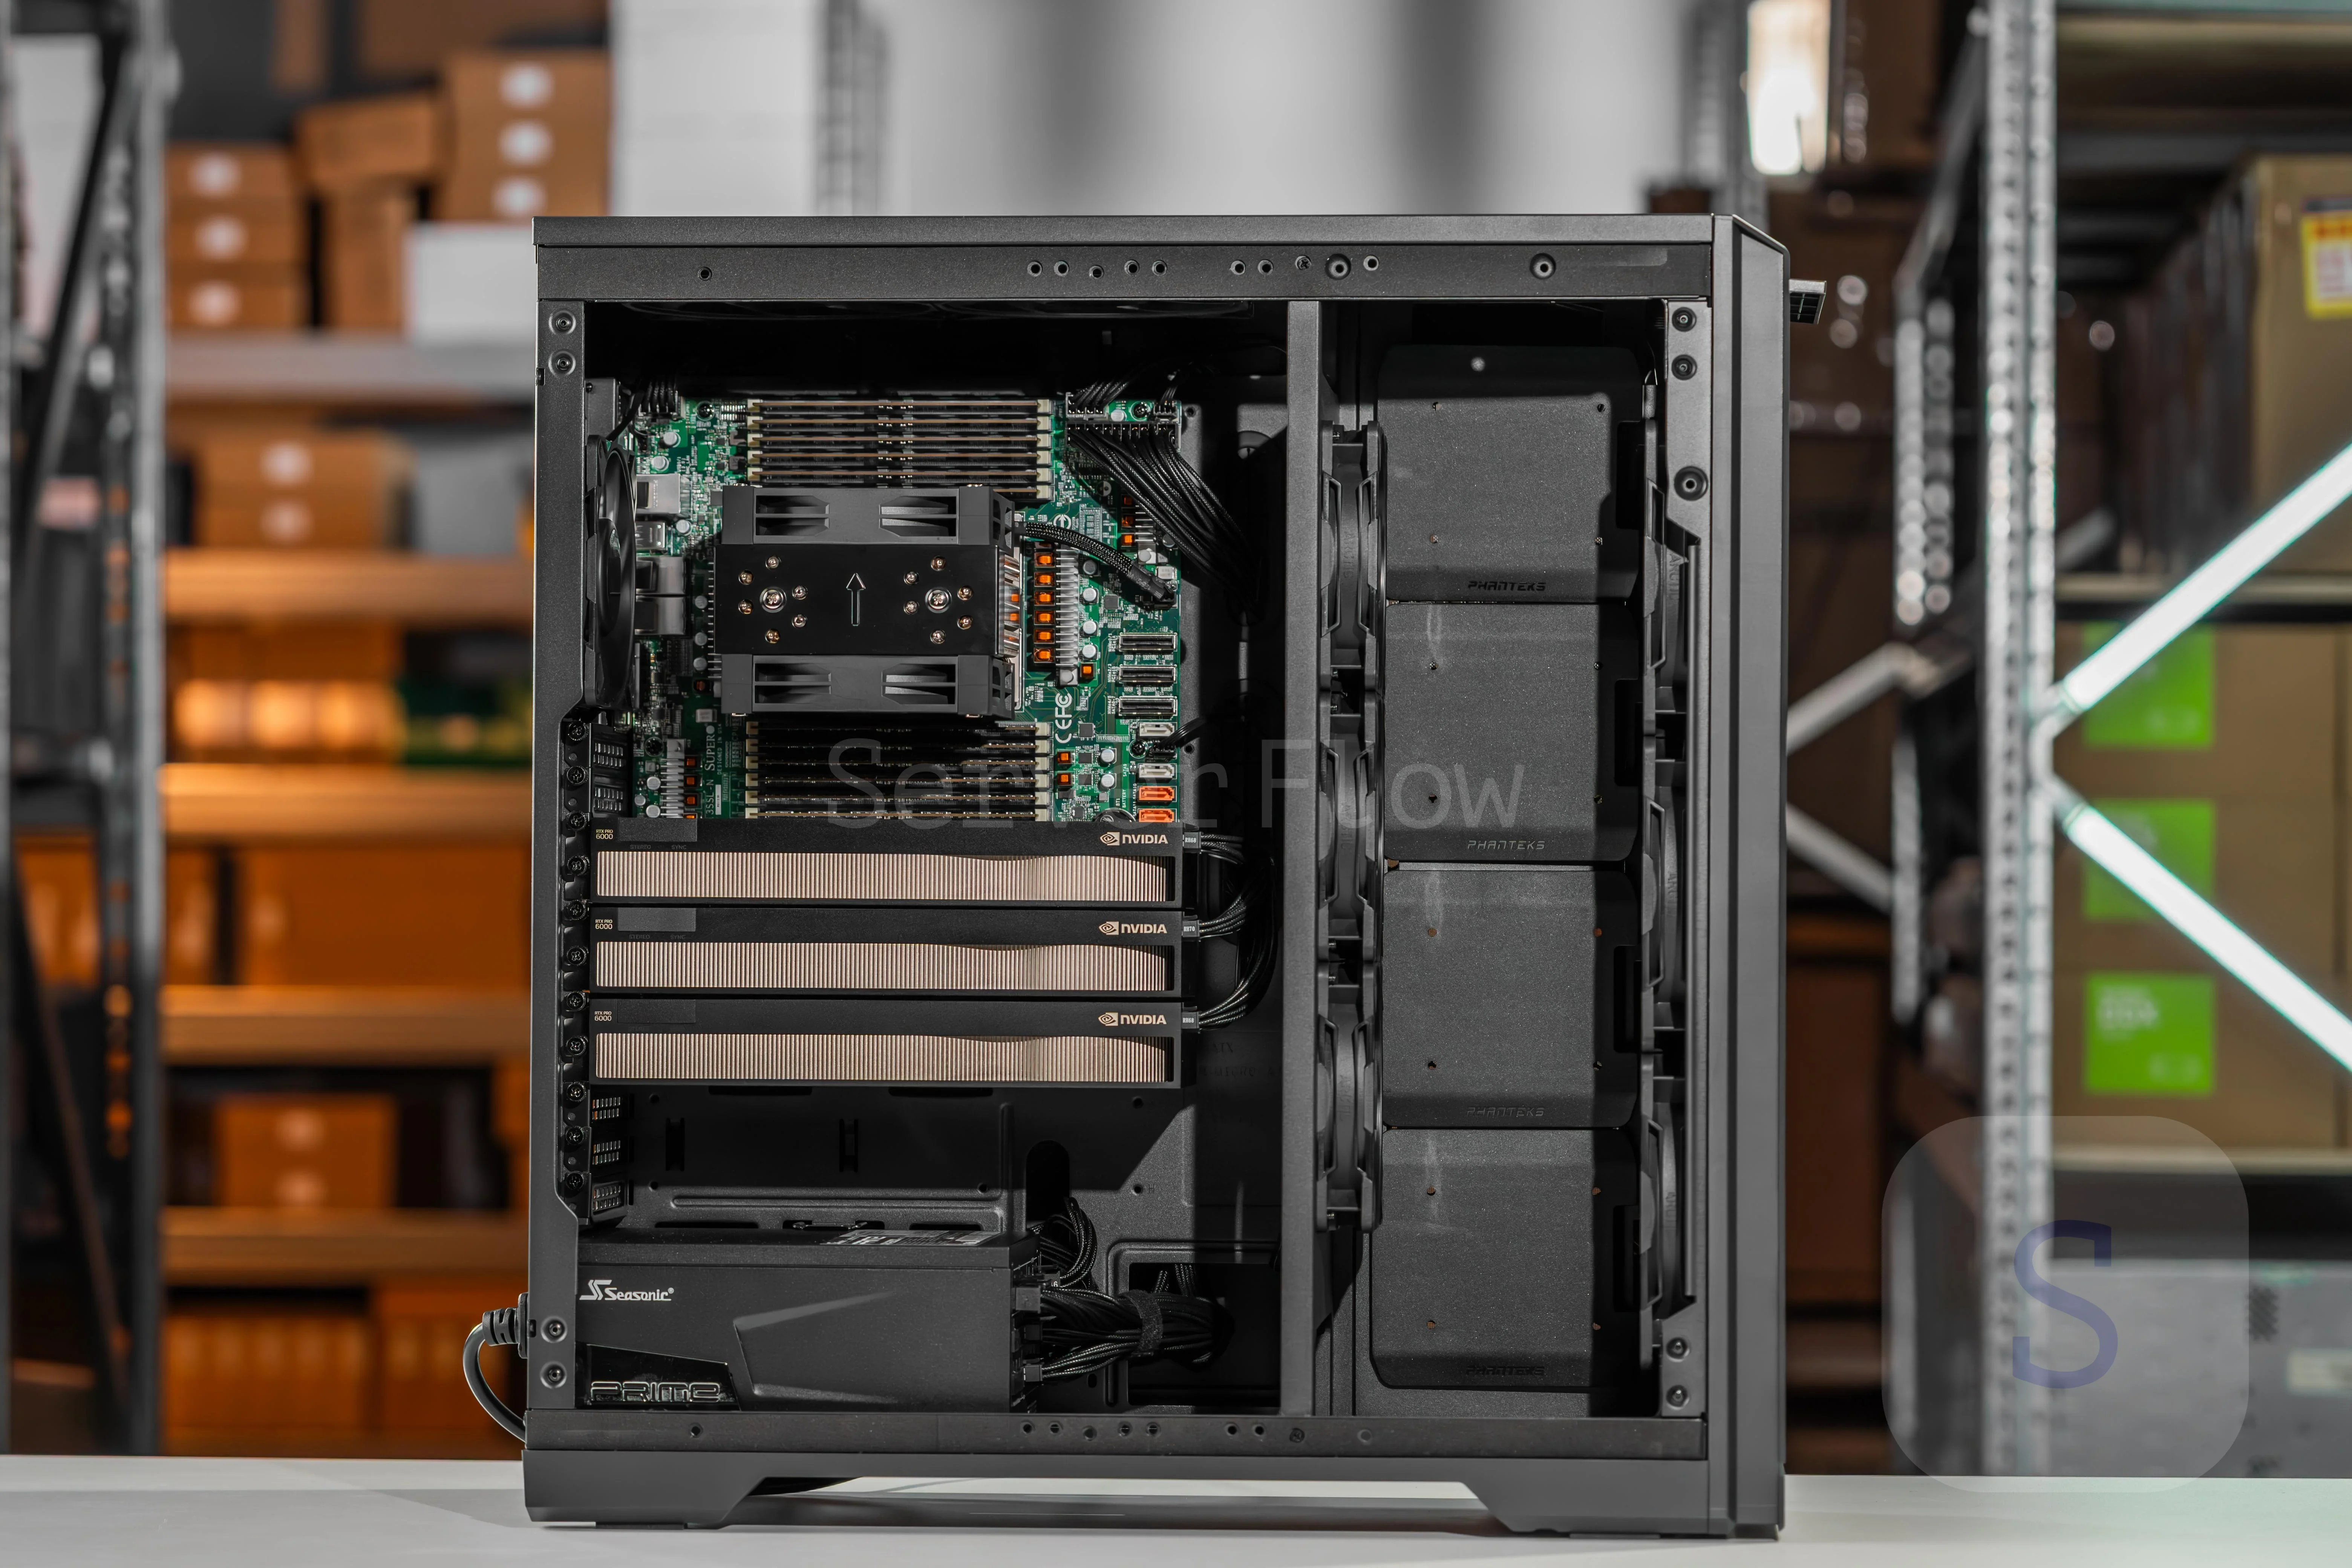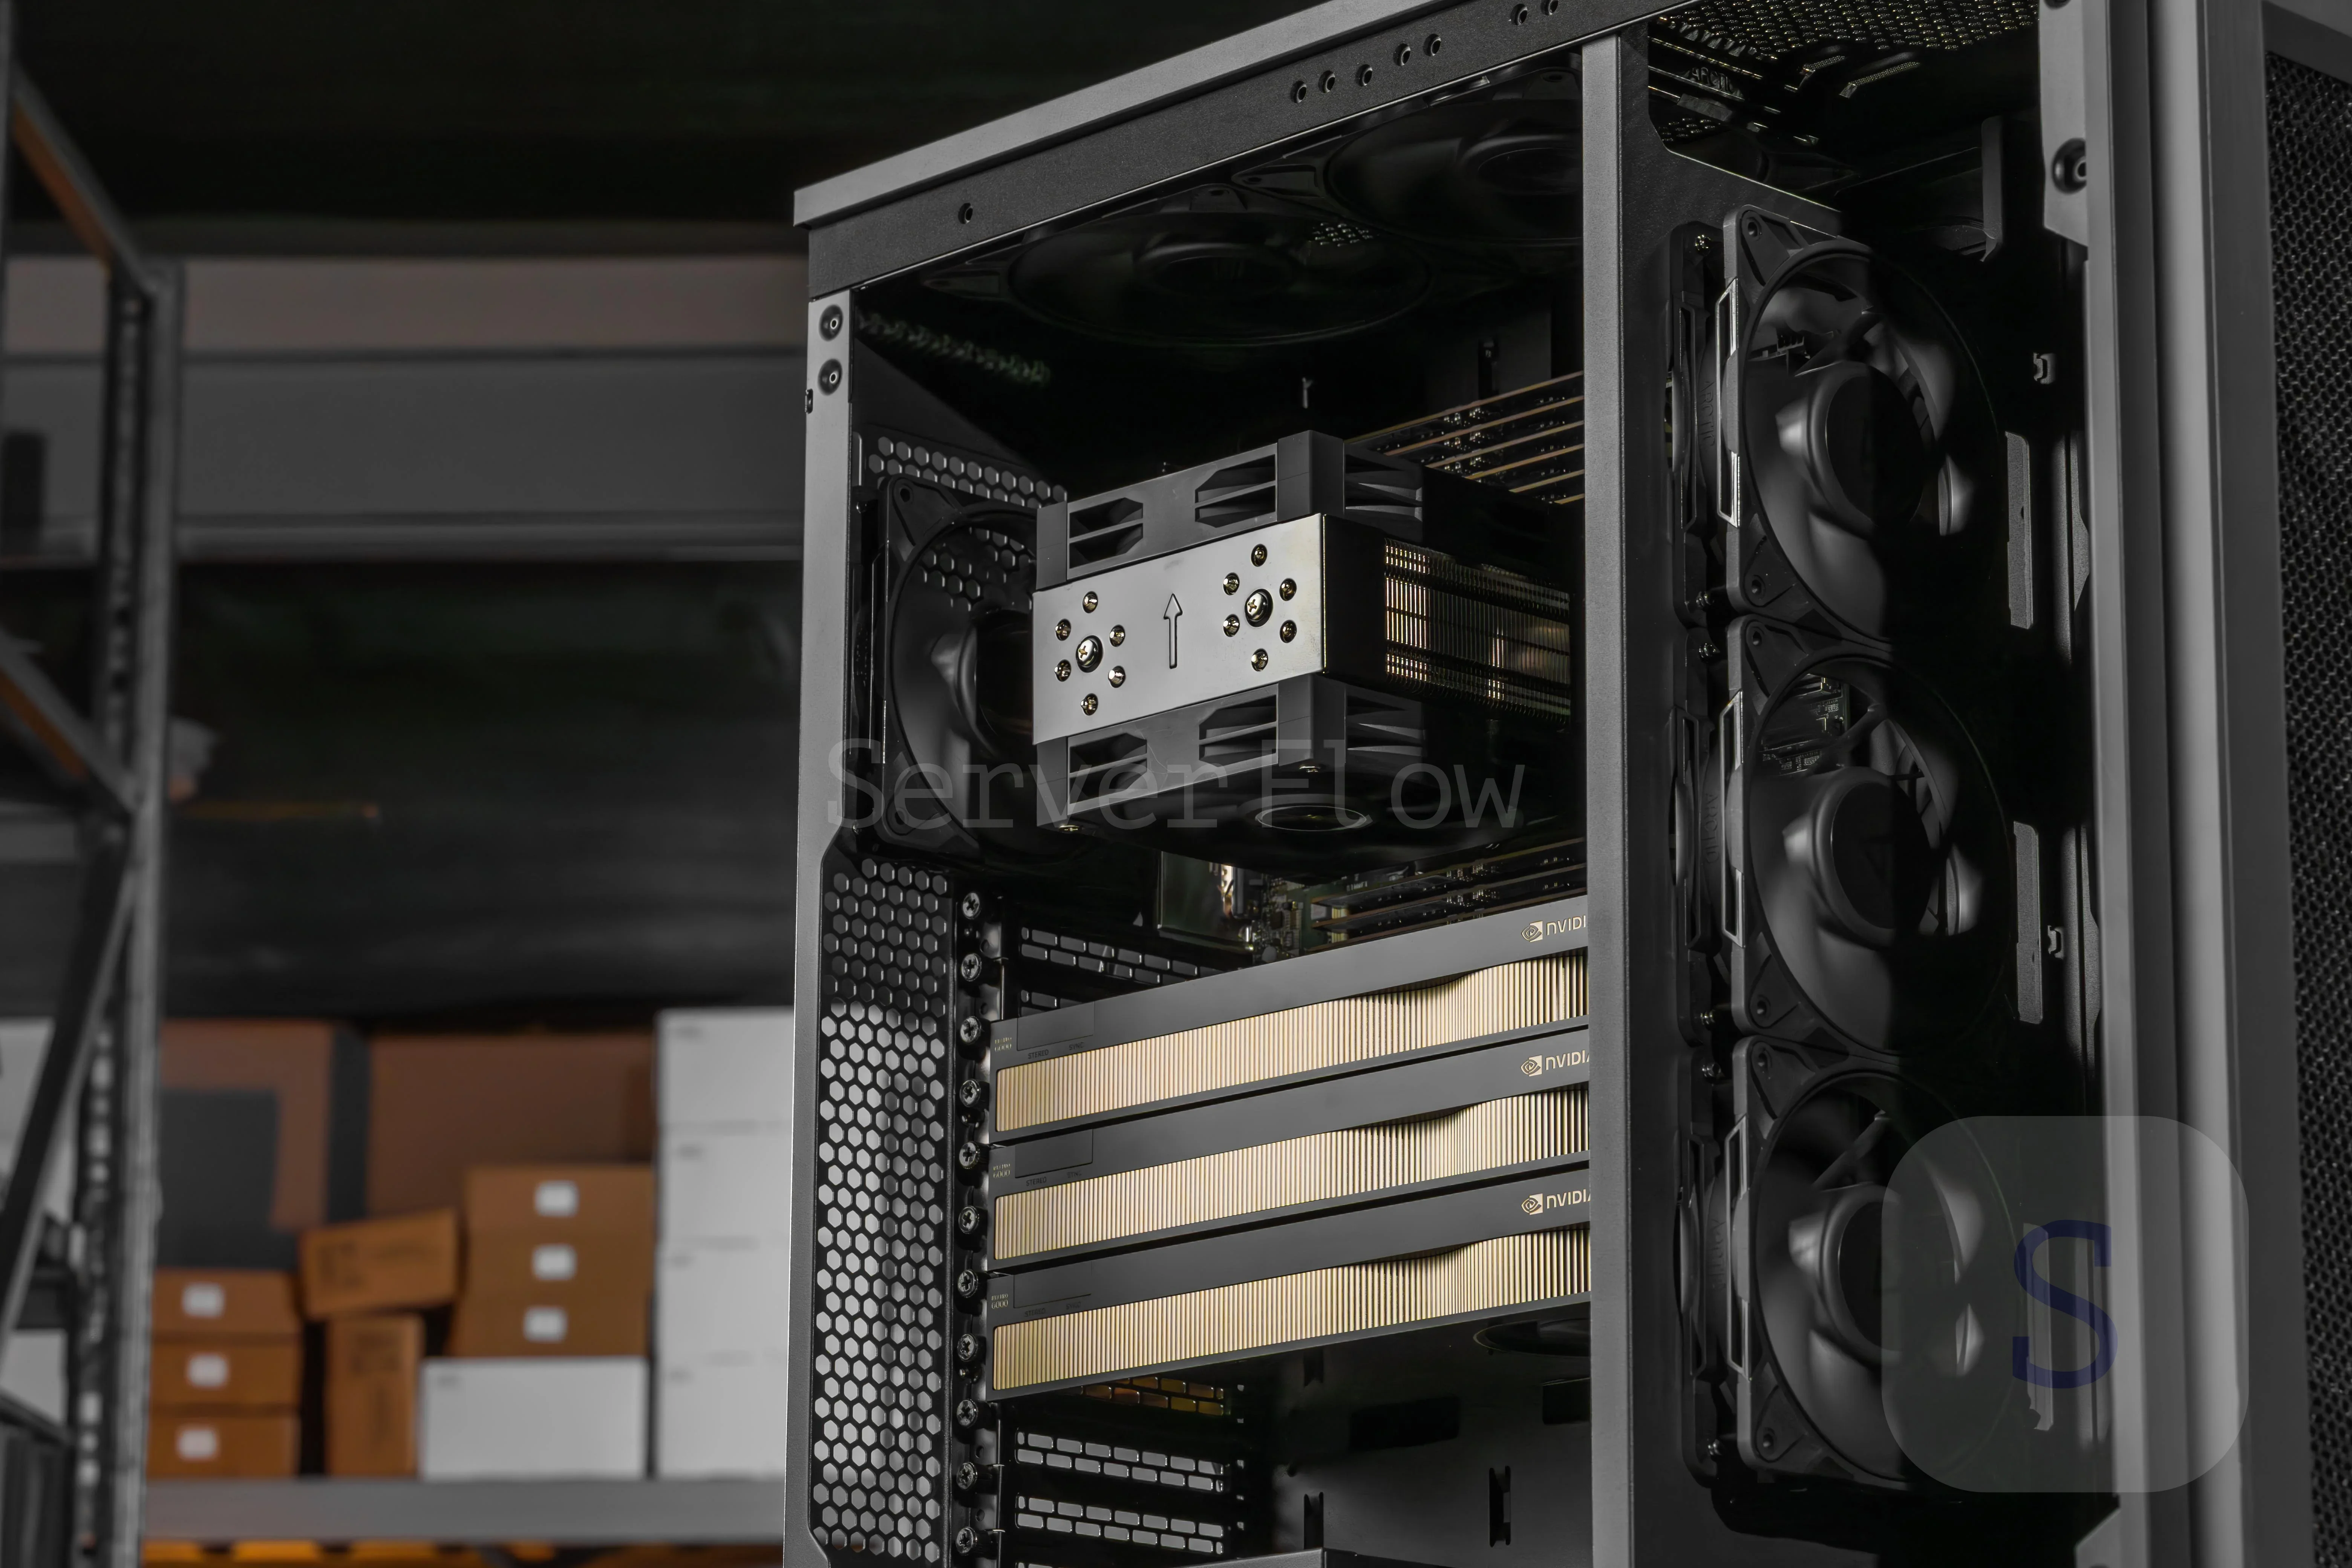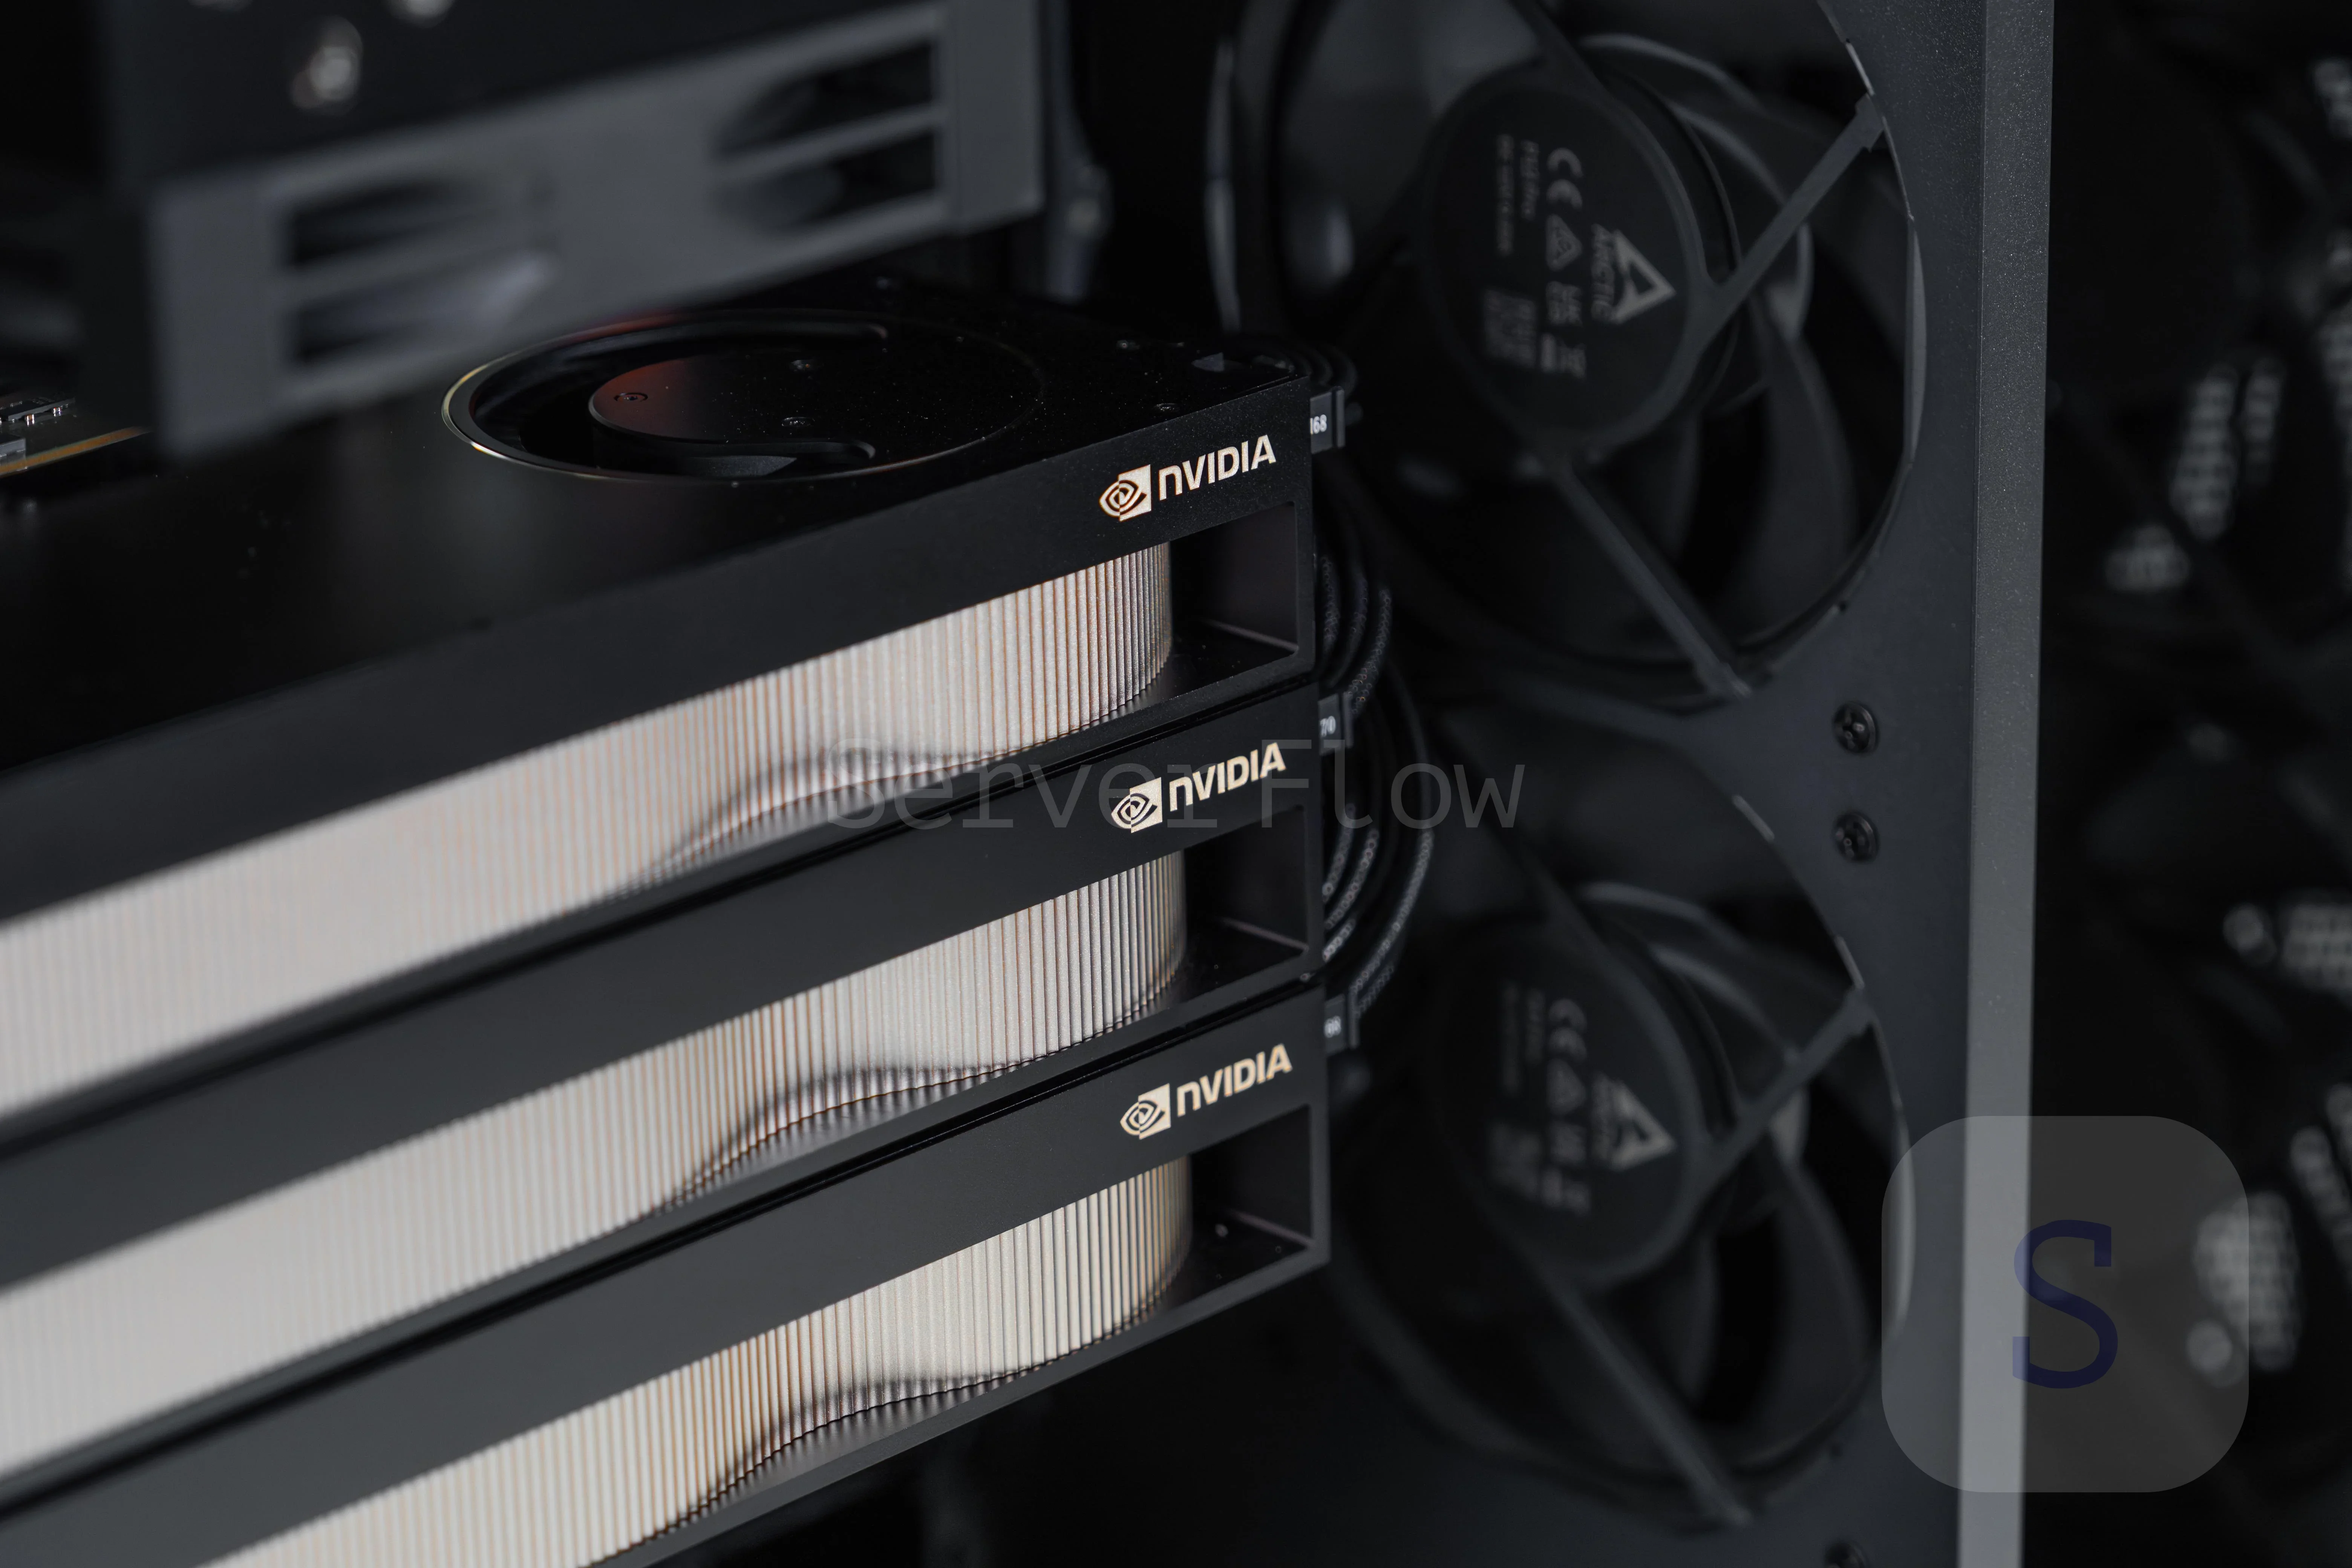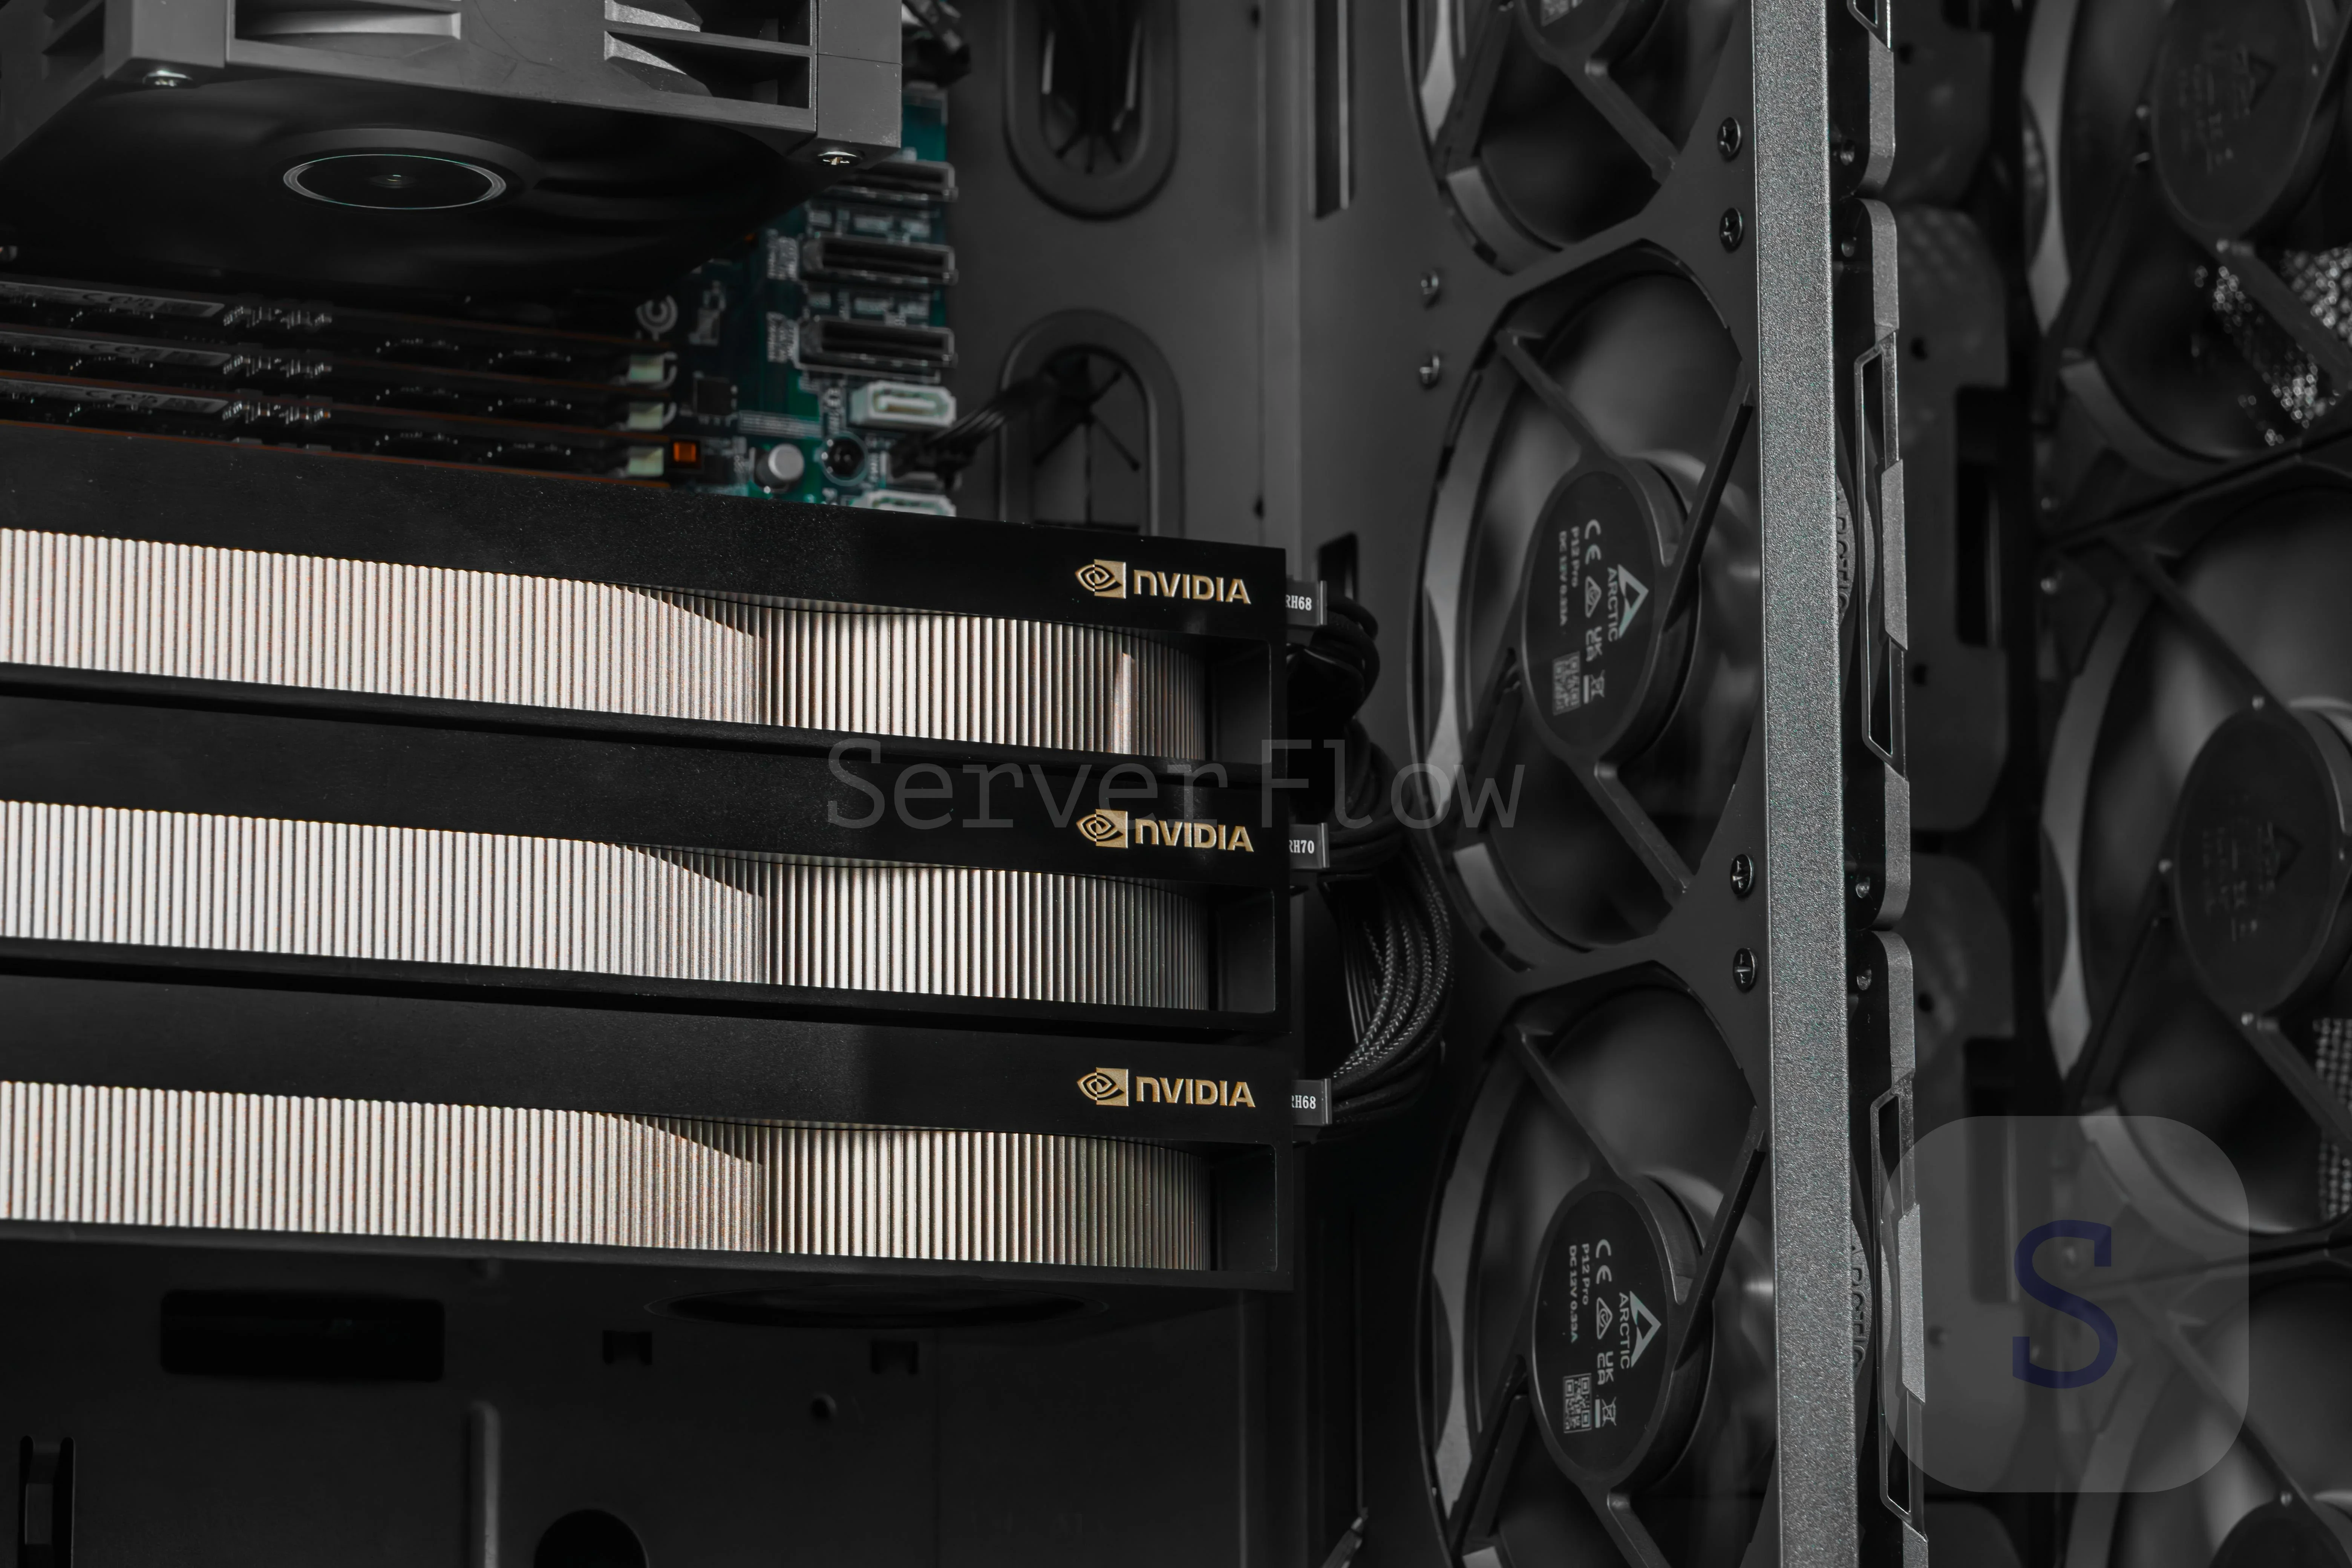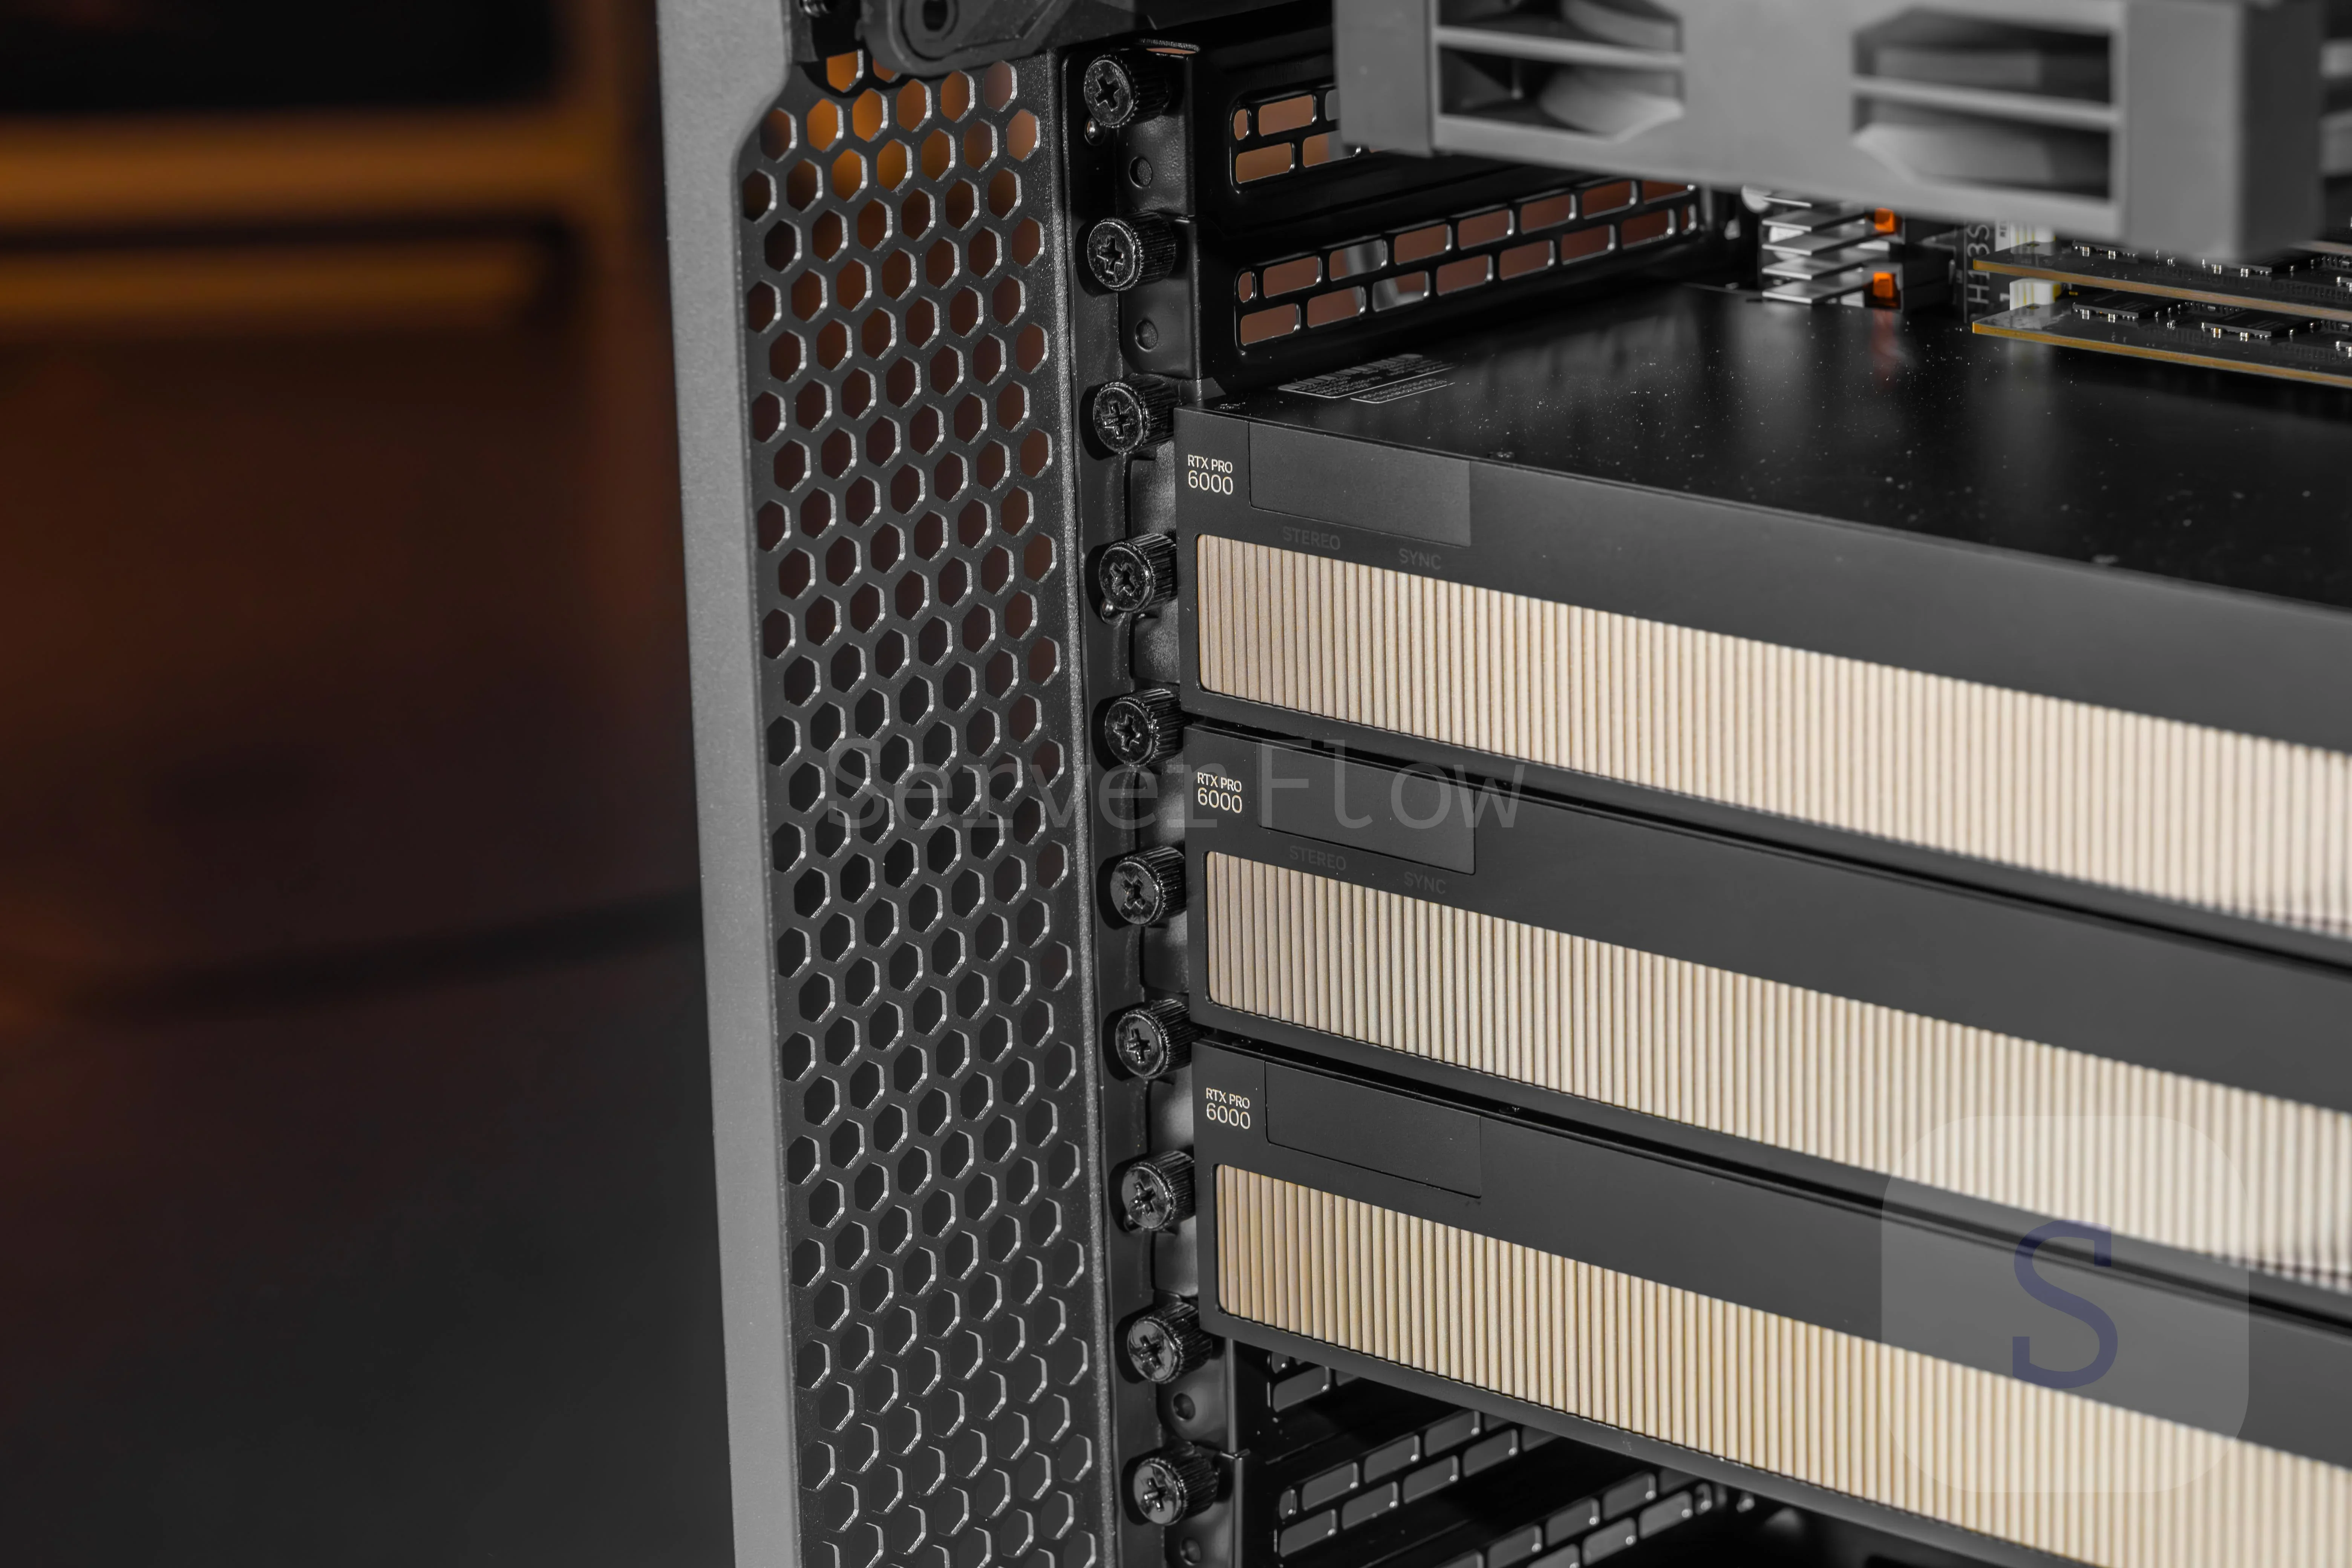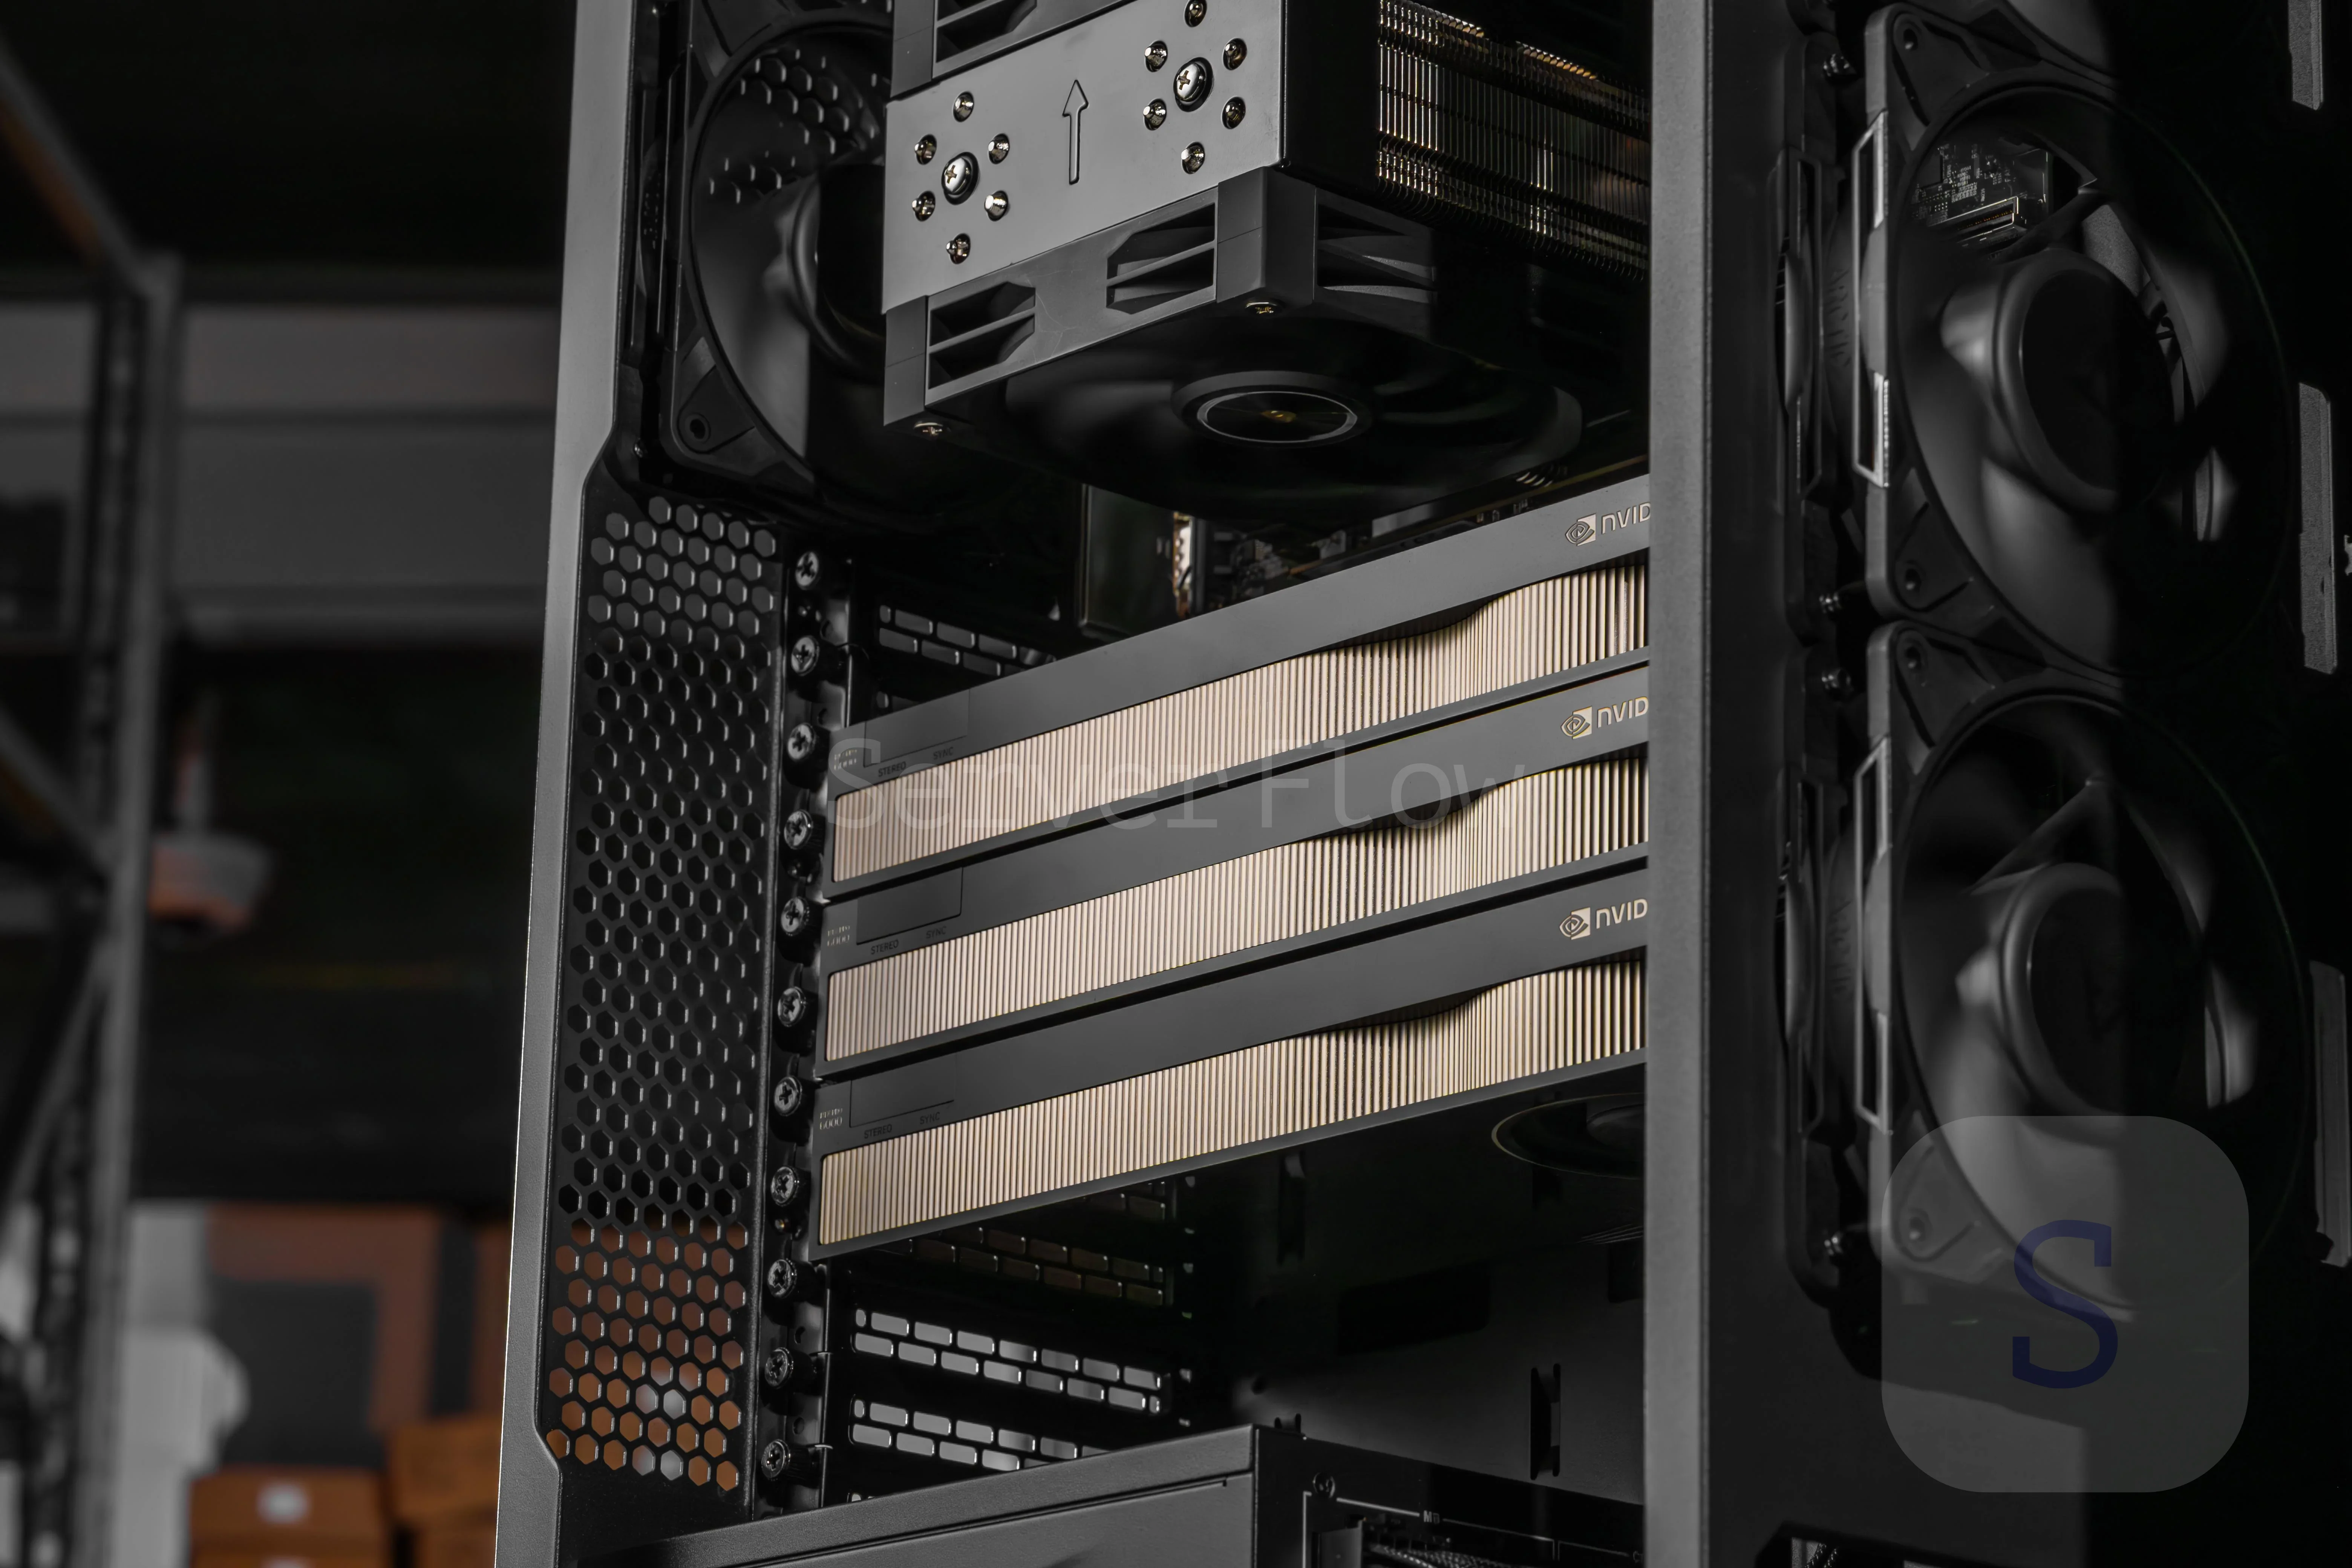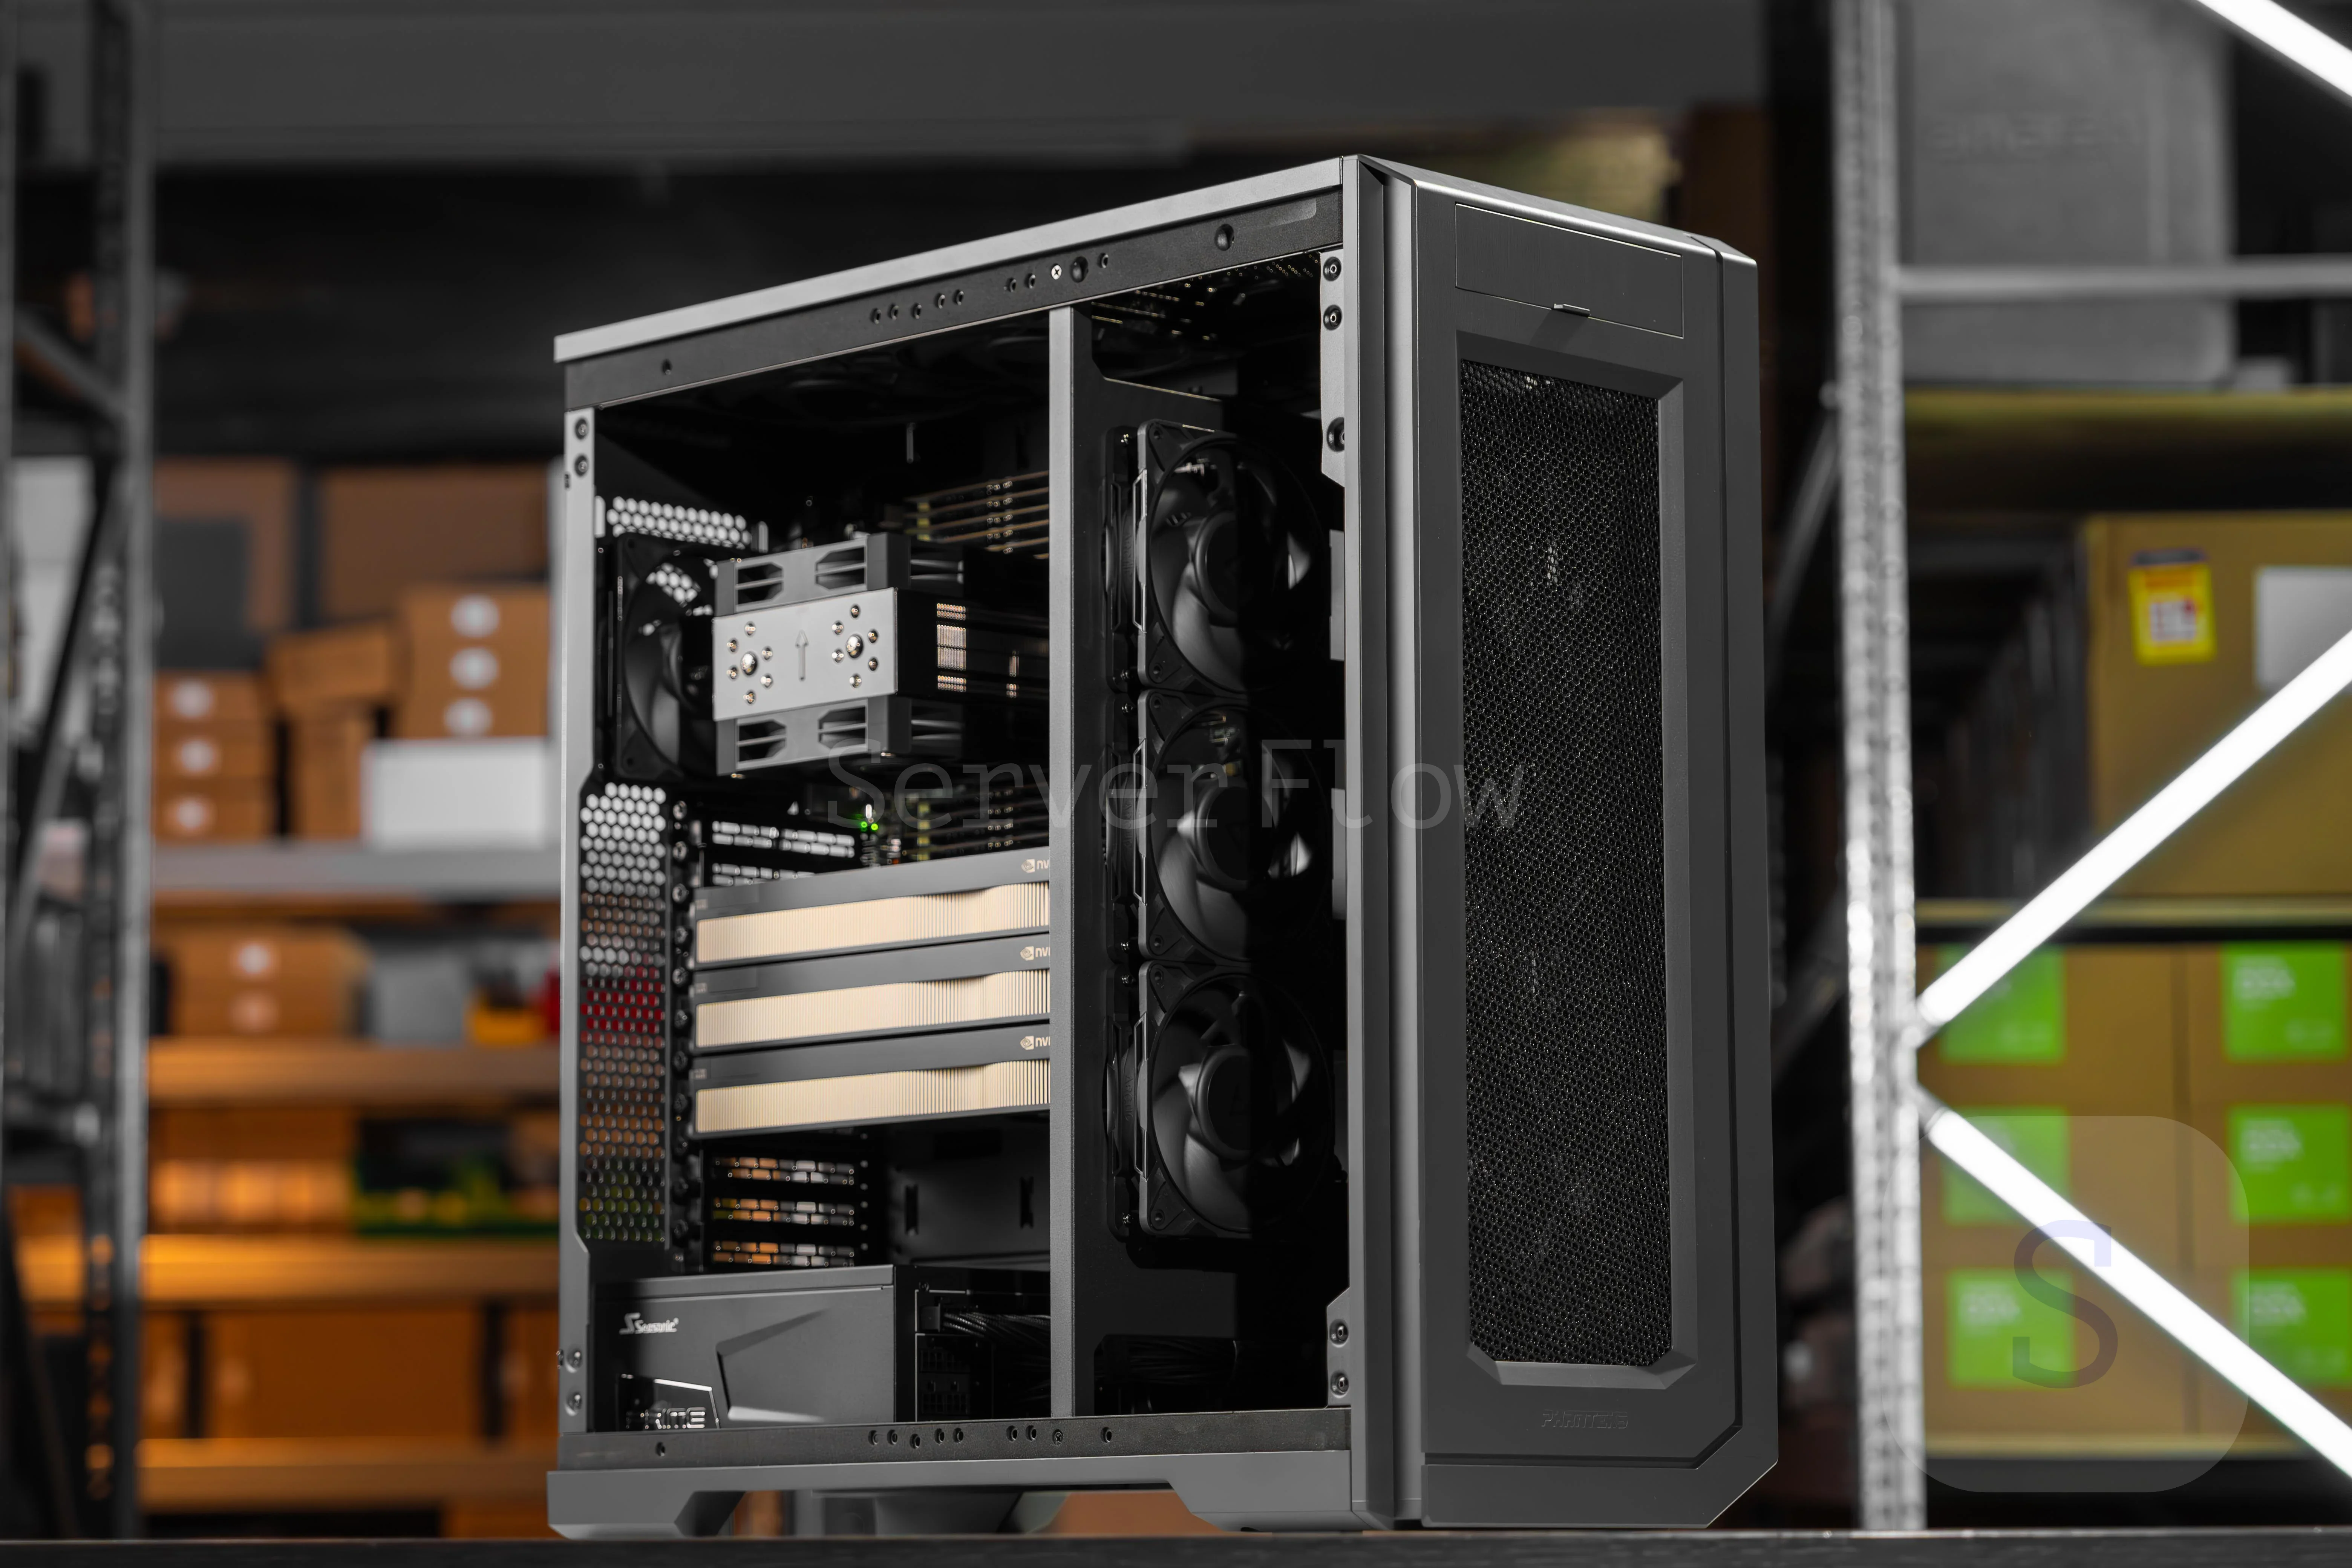
GPU-сервер для локального запуска нейросетей на базе AMD EPYC 9354 и трёх NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB
- Процессор - AMD EPYC 9354, 32 ядра / 64 потока, TDP 280 Вт - 1 шт.
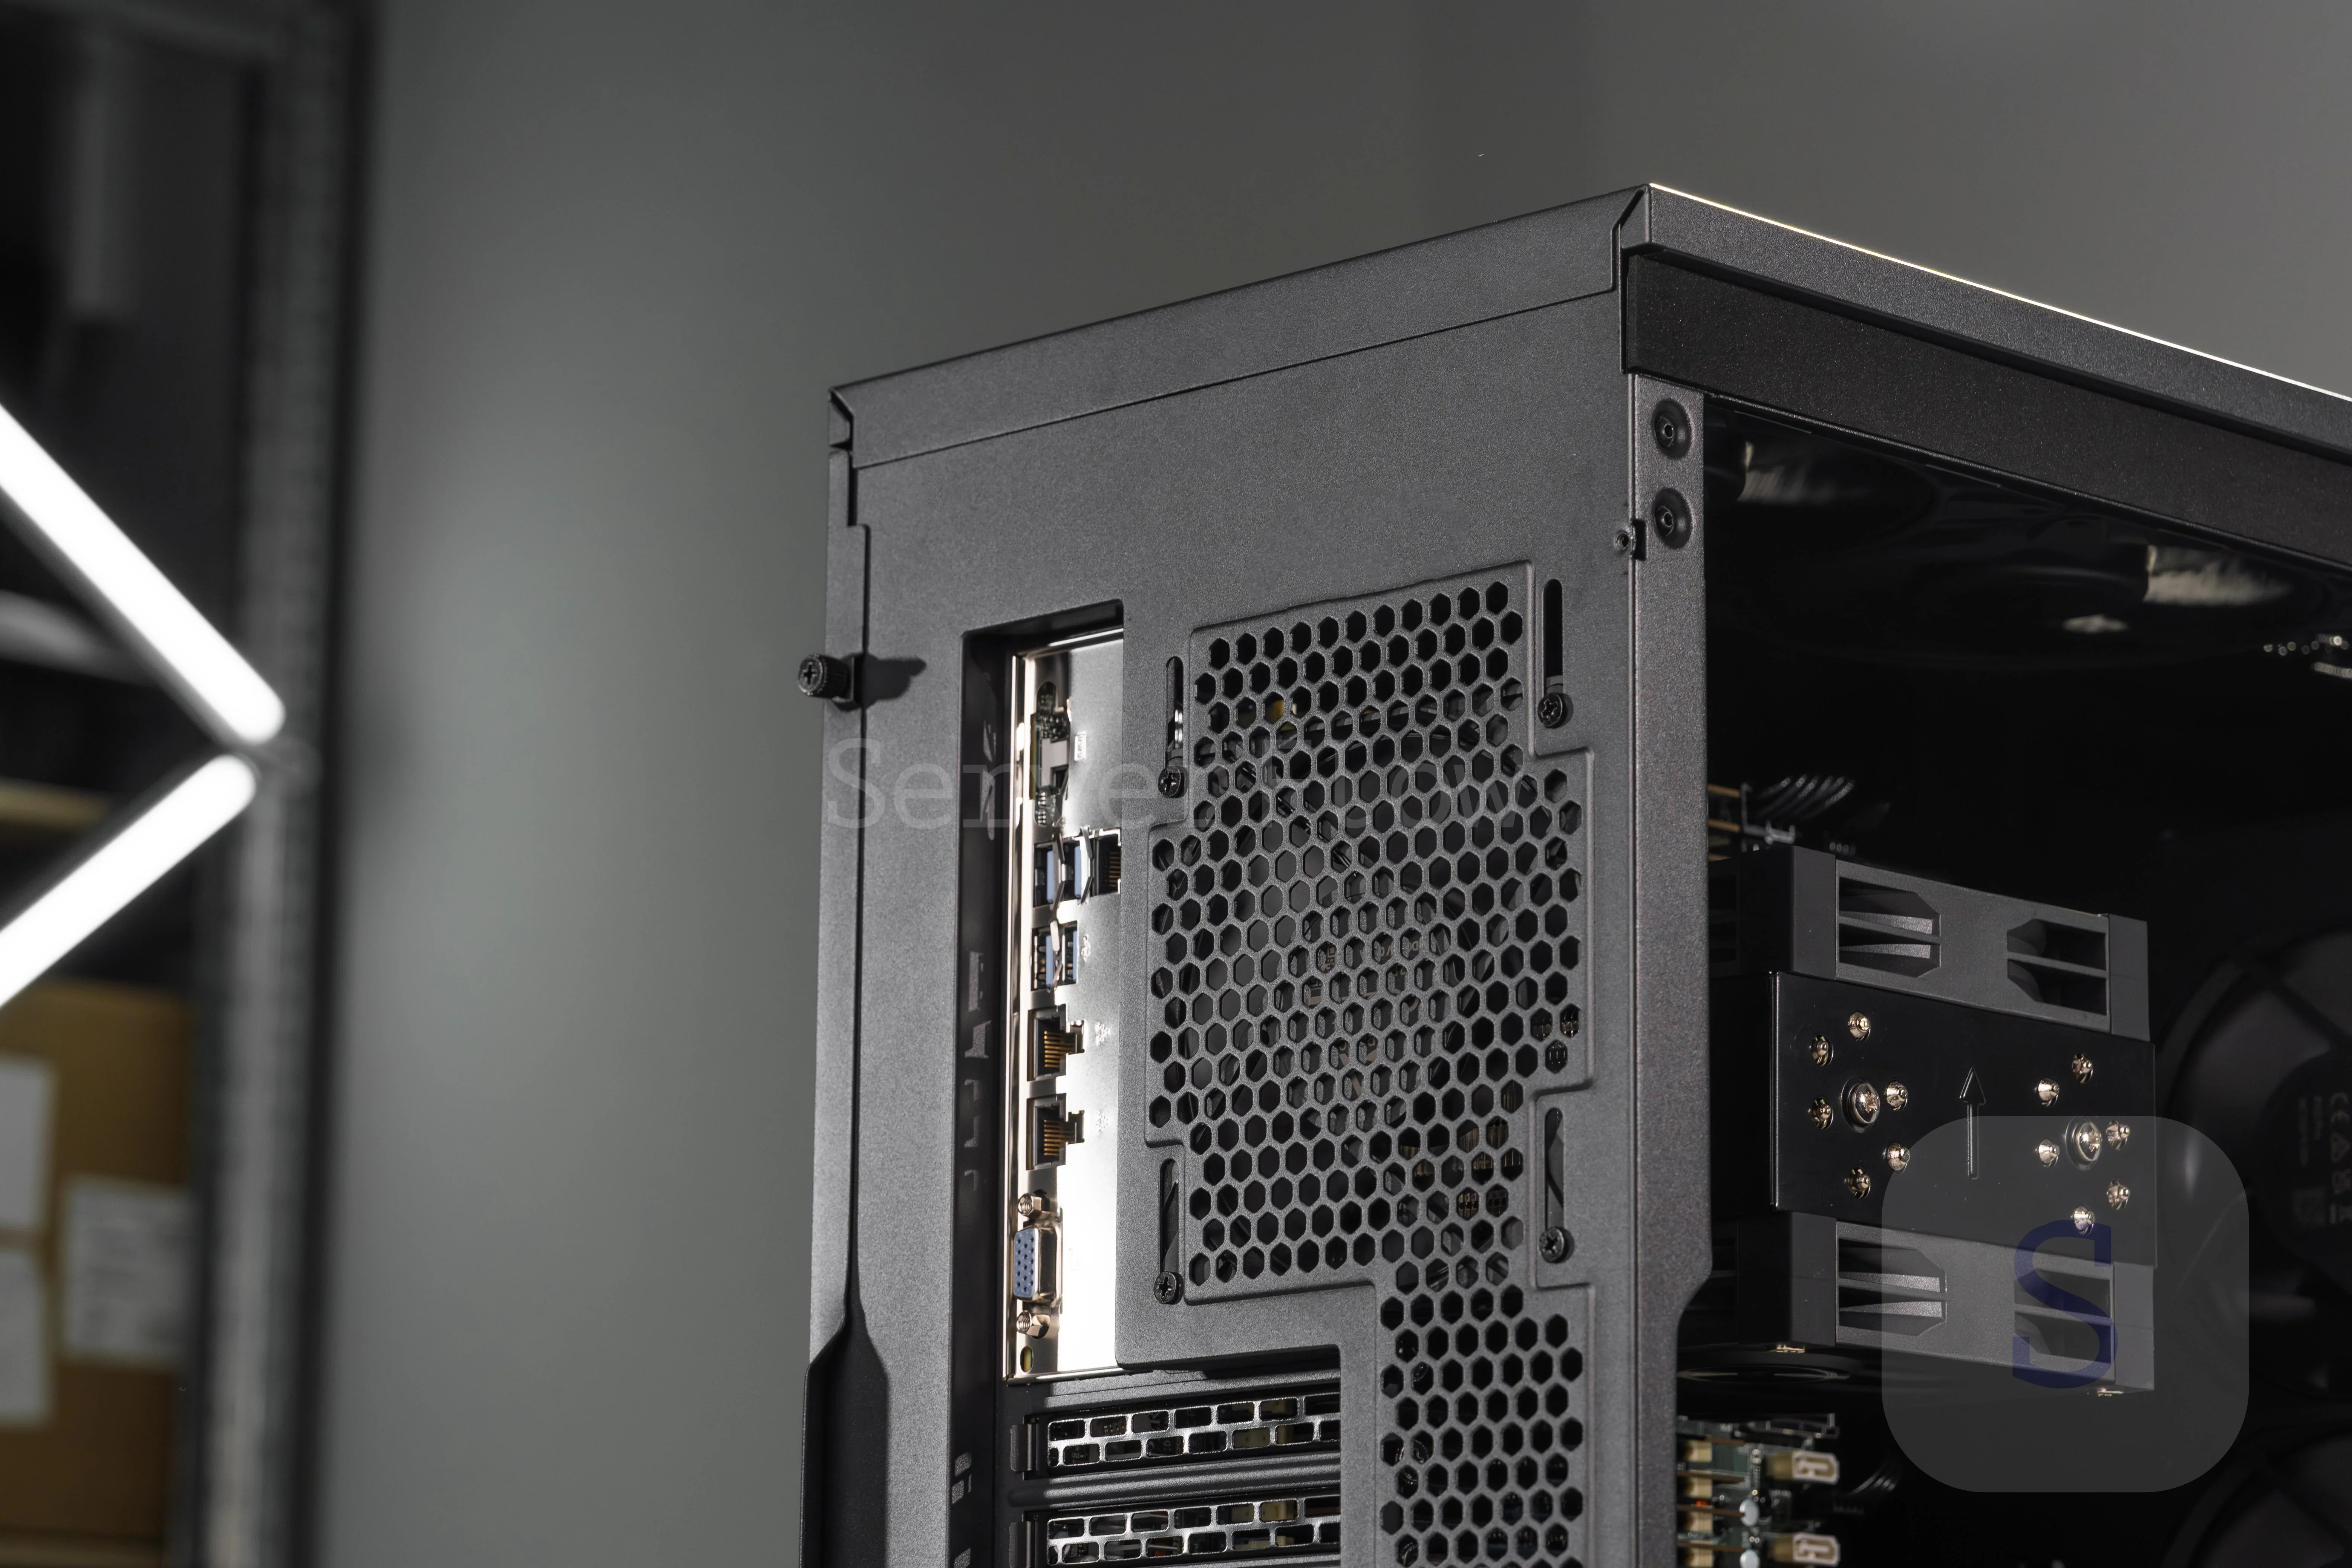
- Материнская плата - Supermicro H13SSL-N Rev. 2.0, Socket SP5 - 1 шт.
- Оперативная память - 16GB DDR5 ECC REG Samsung 4800 MHz 1Rx8 - 12 шт. (общий объём 192 ГБ).
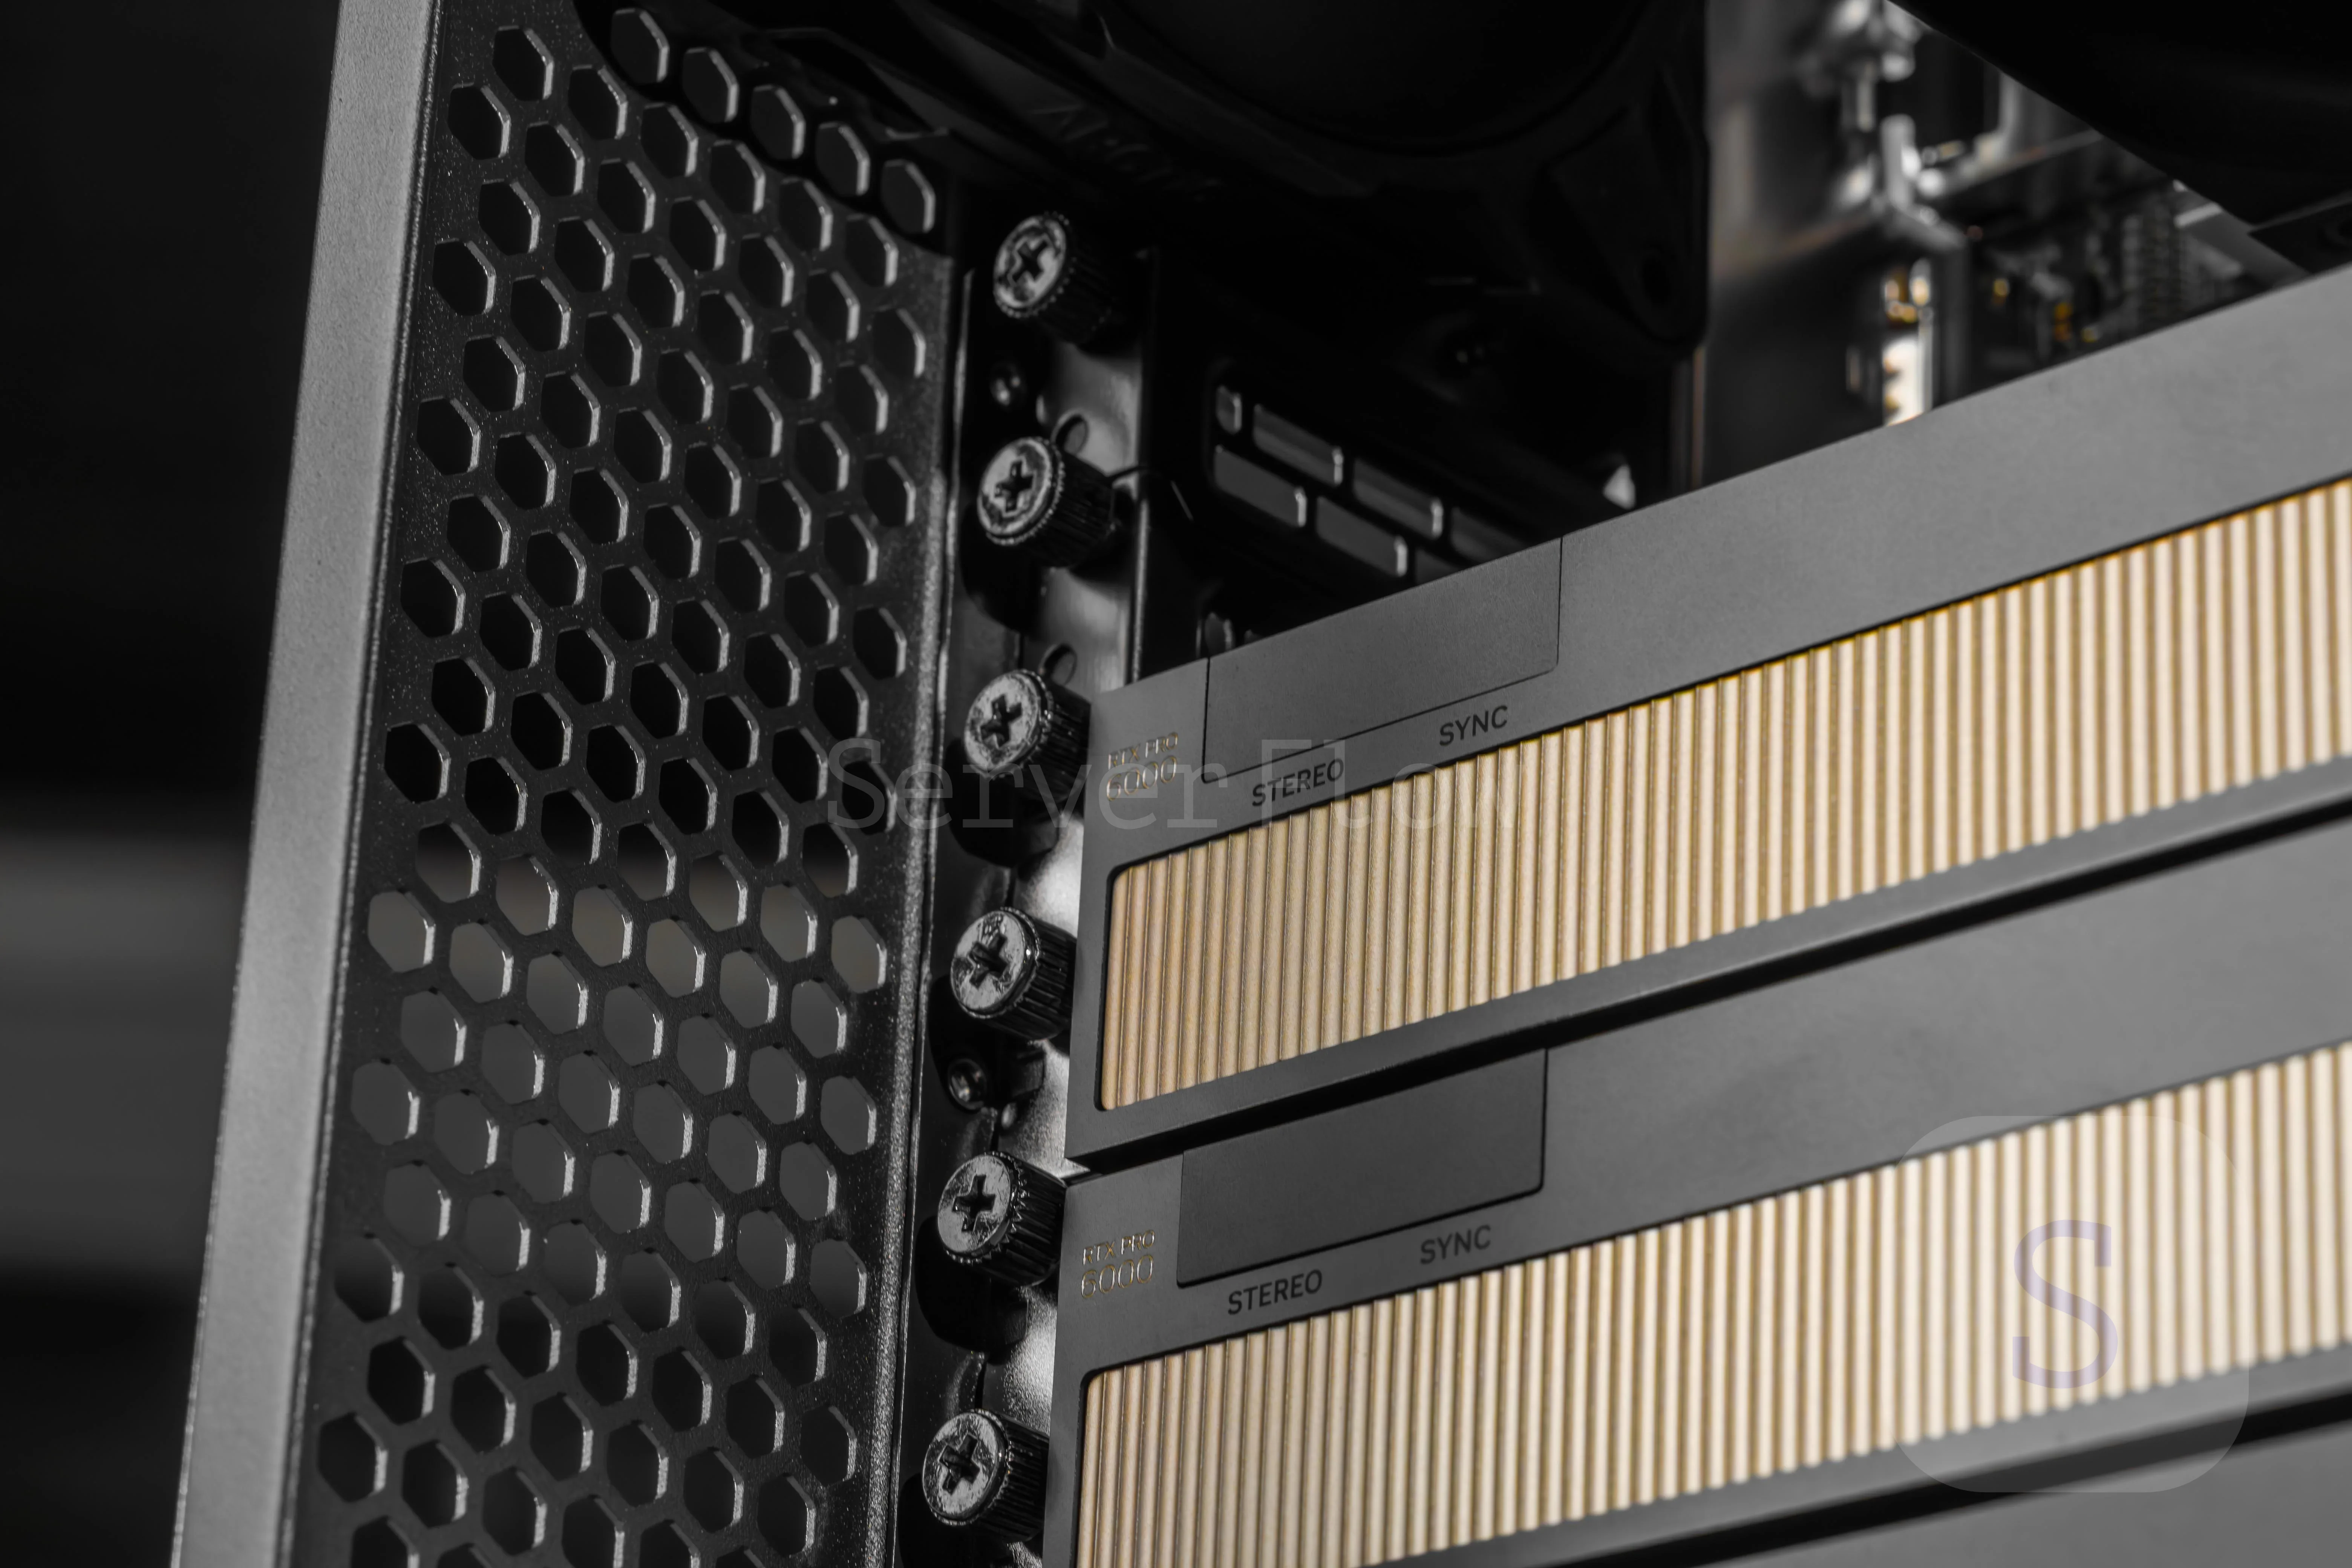
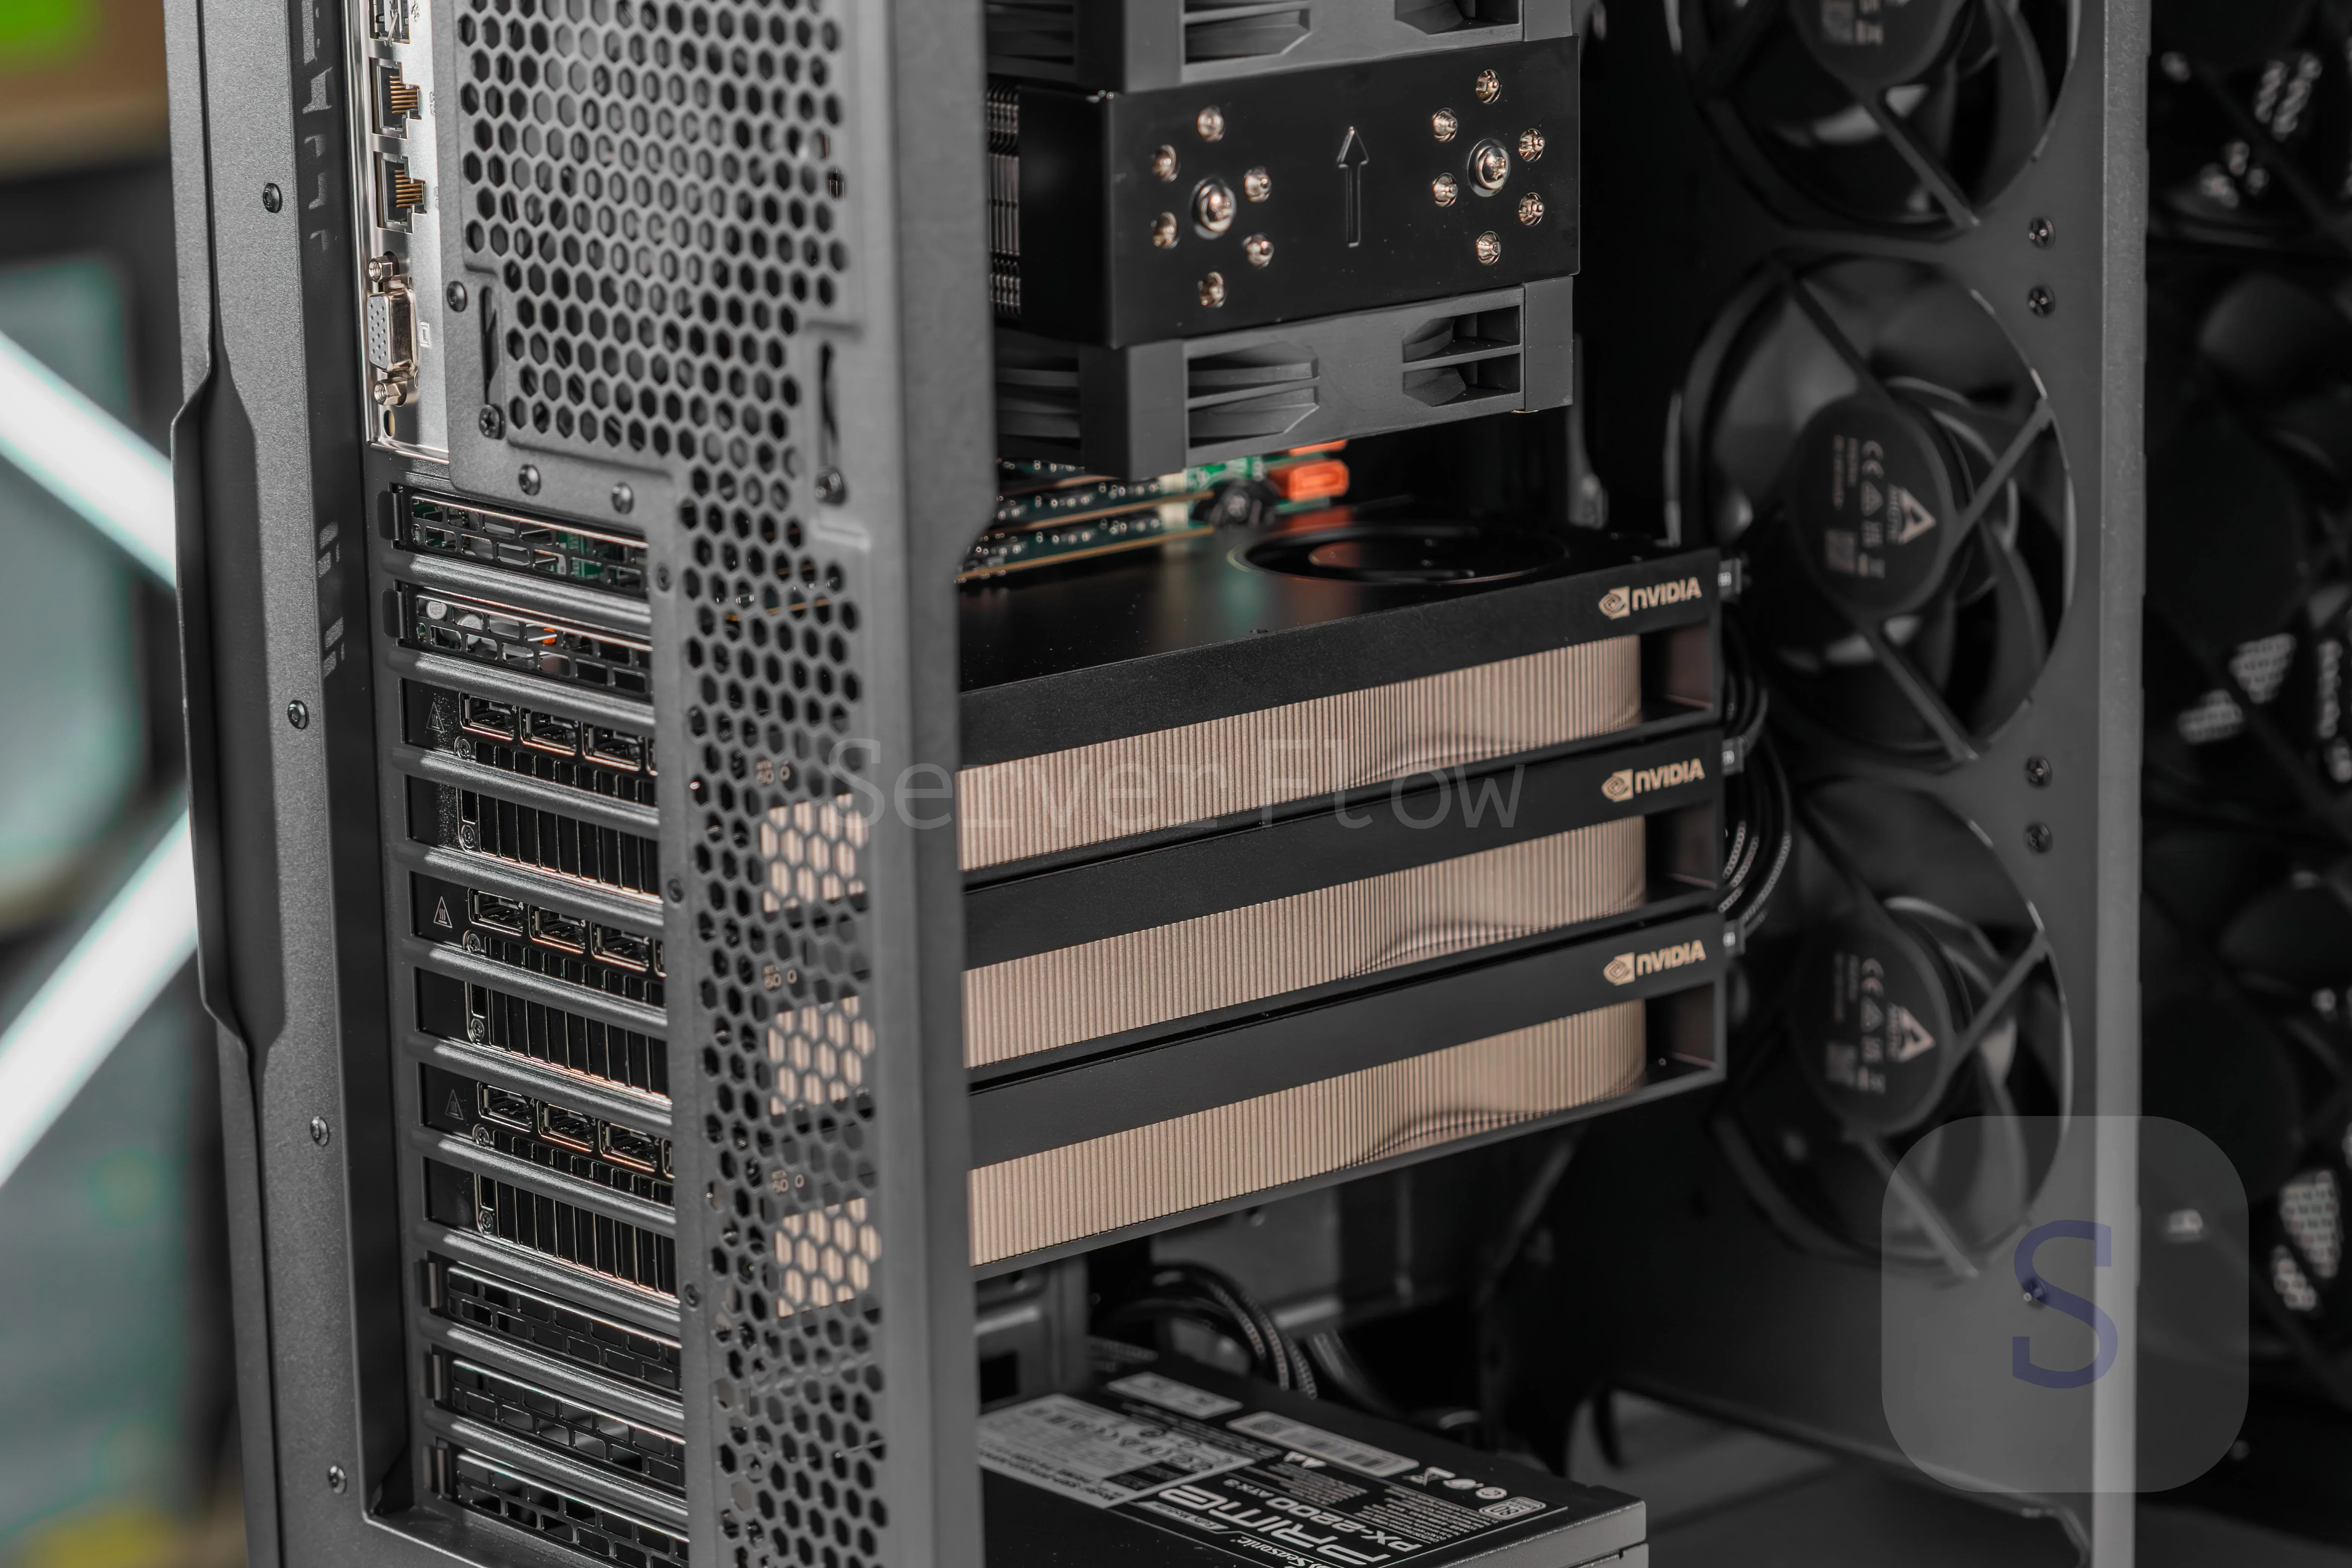
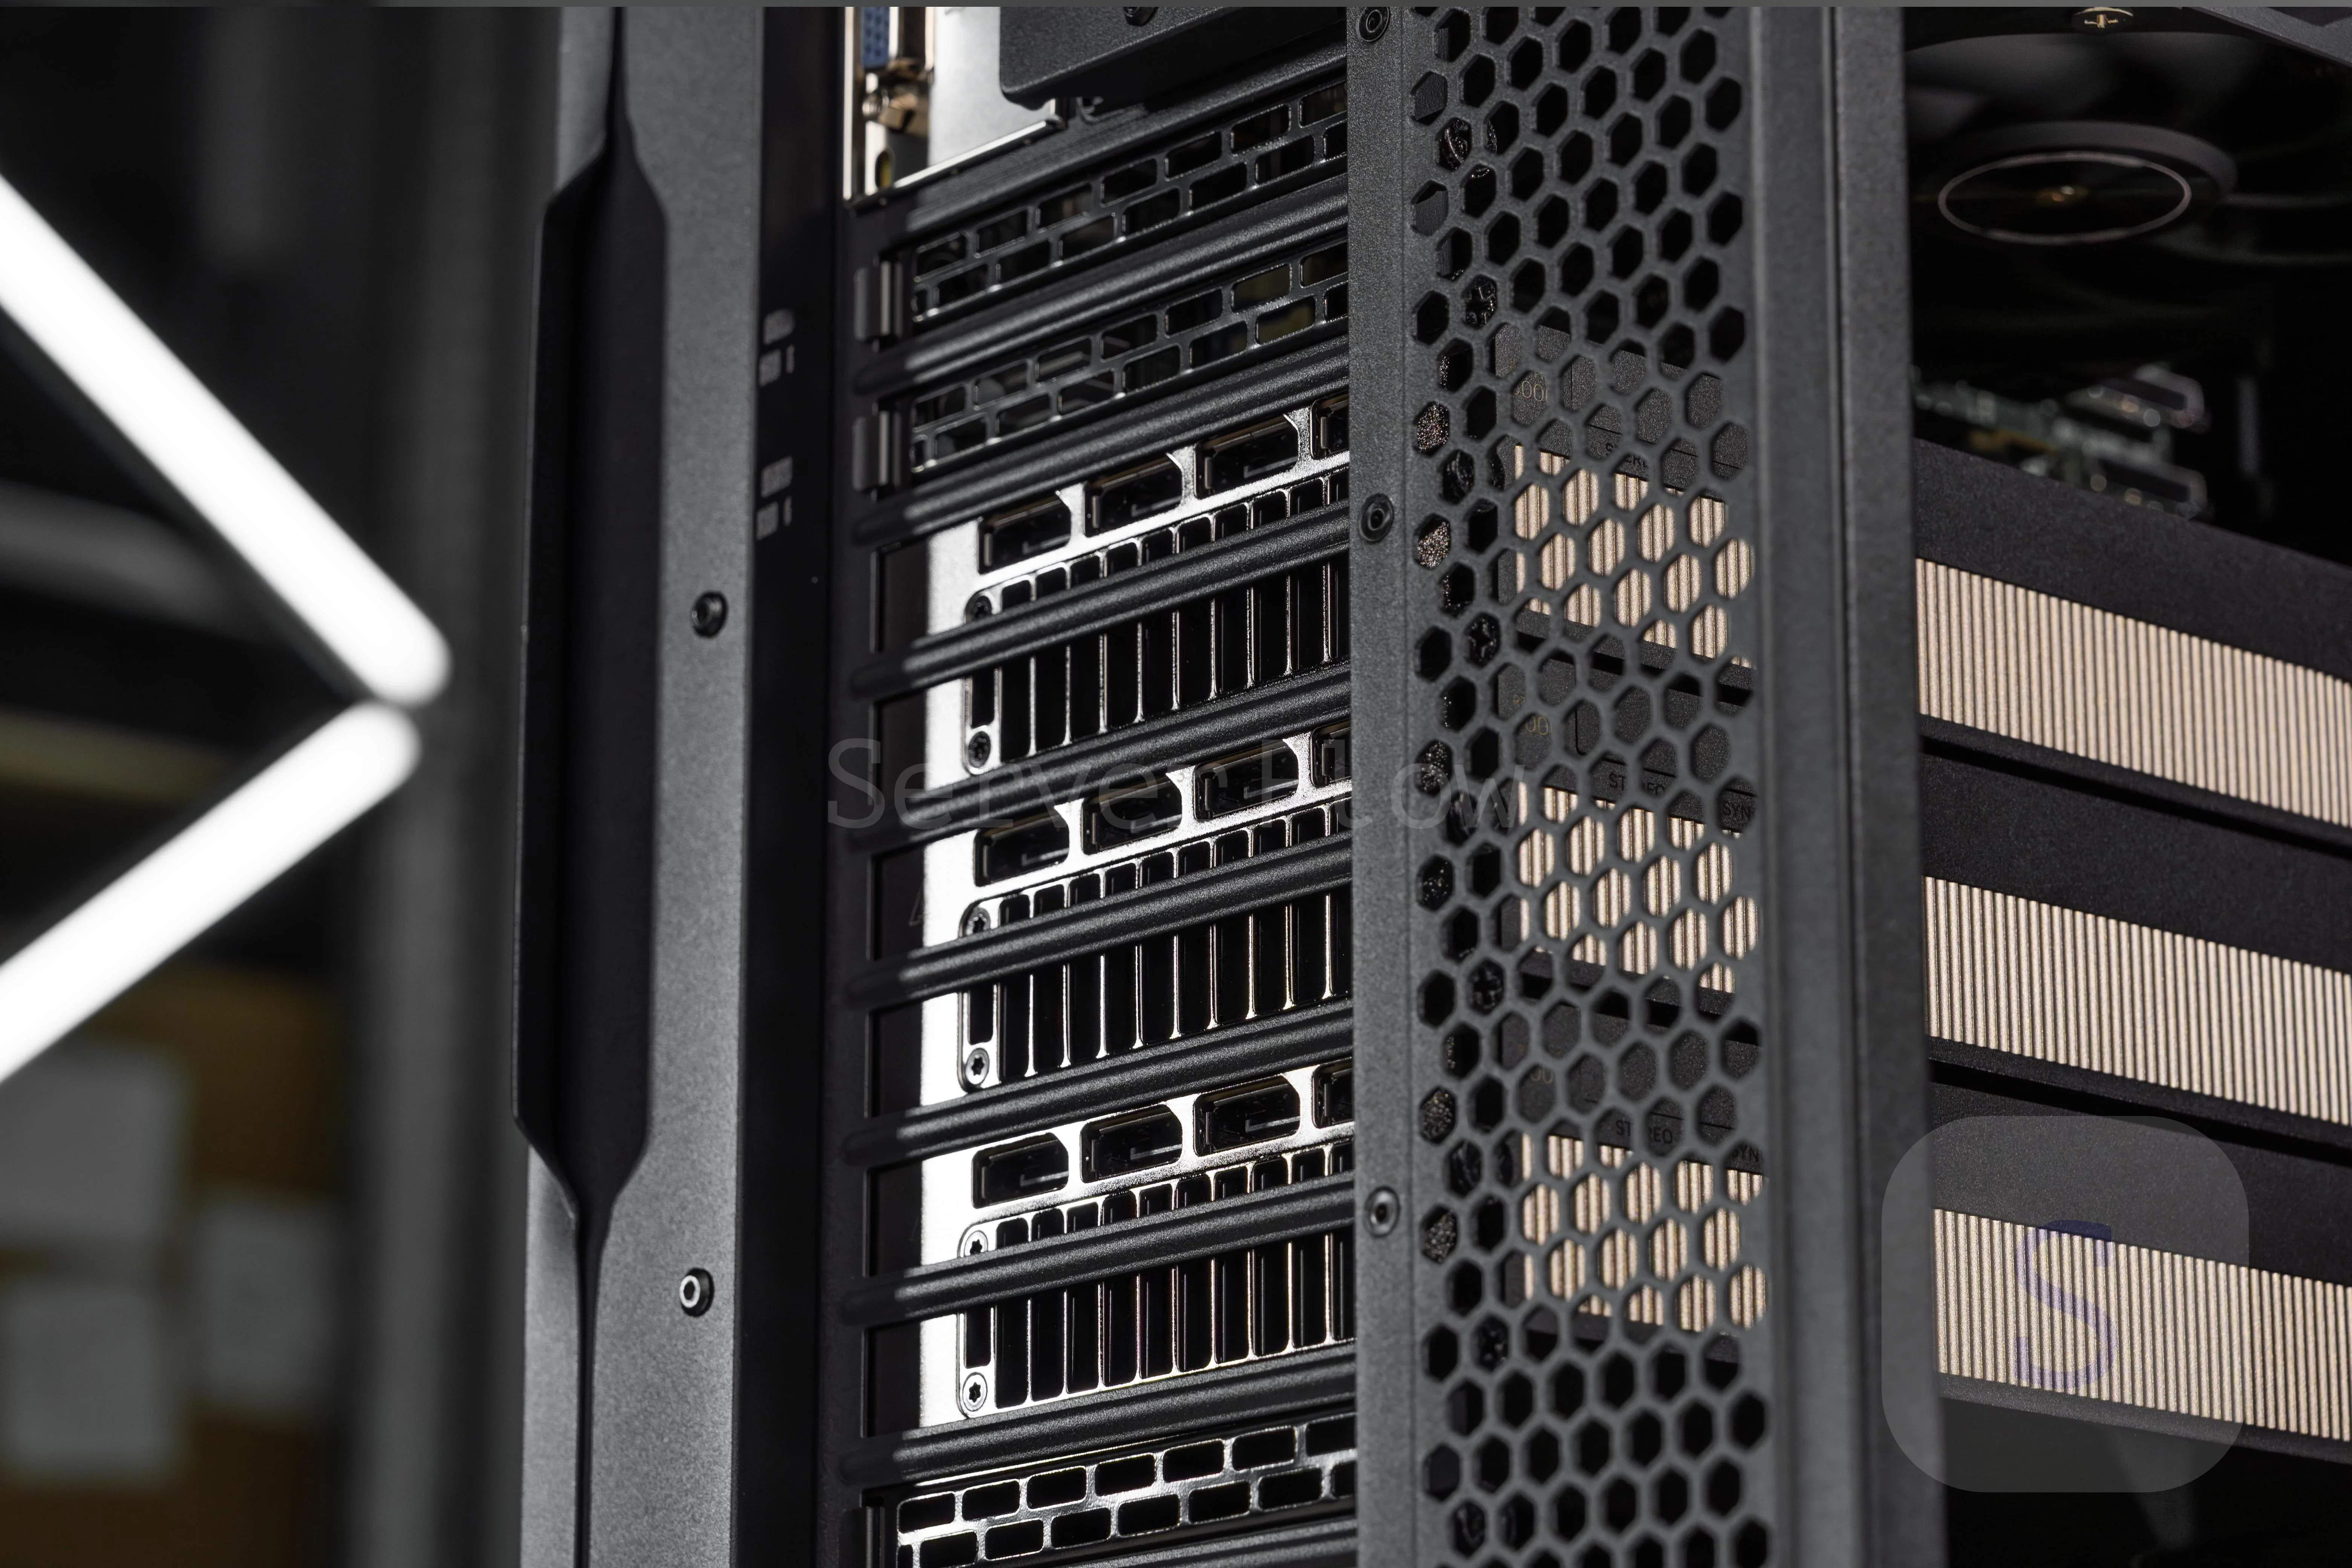
- Видеокарты - NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition 96GB GDDR7 - 3 шт. (общий объём видеопамяти 288 ГБ).
- Охлаждение процессора - COOLSERVER CS-SP5-4UM98 PRO - 1 шт.
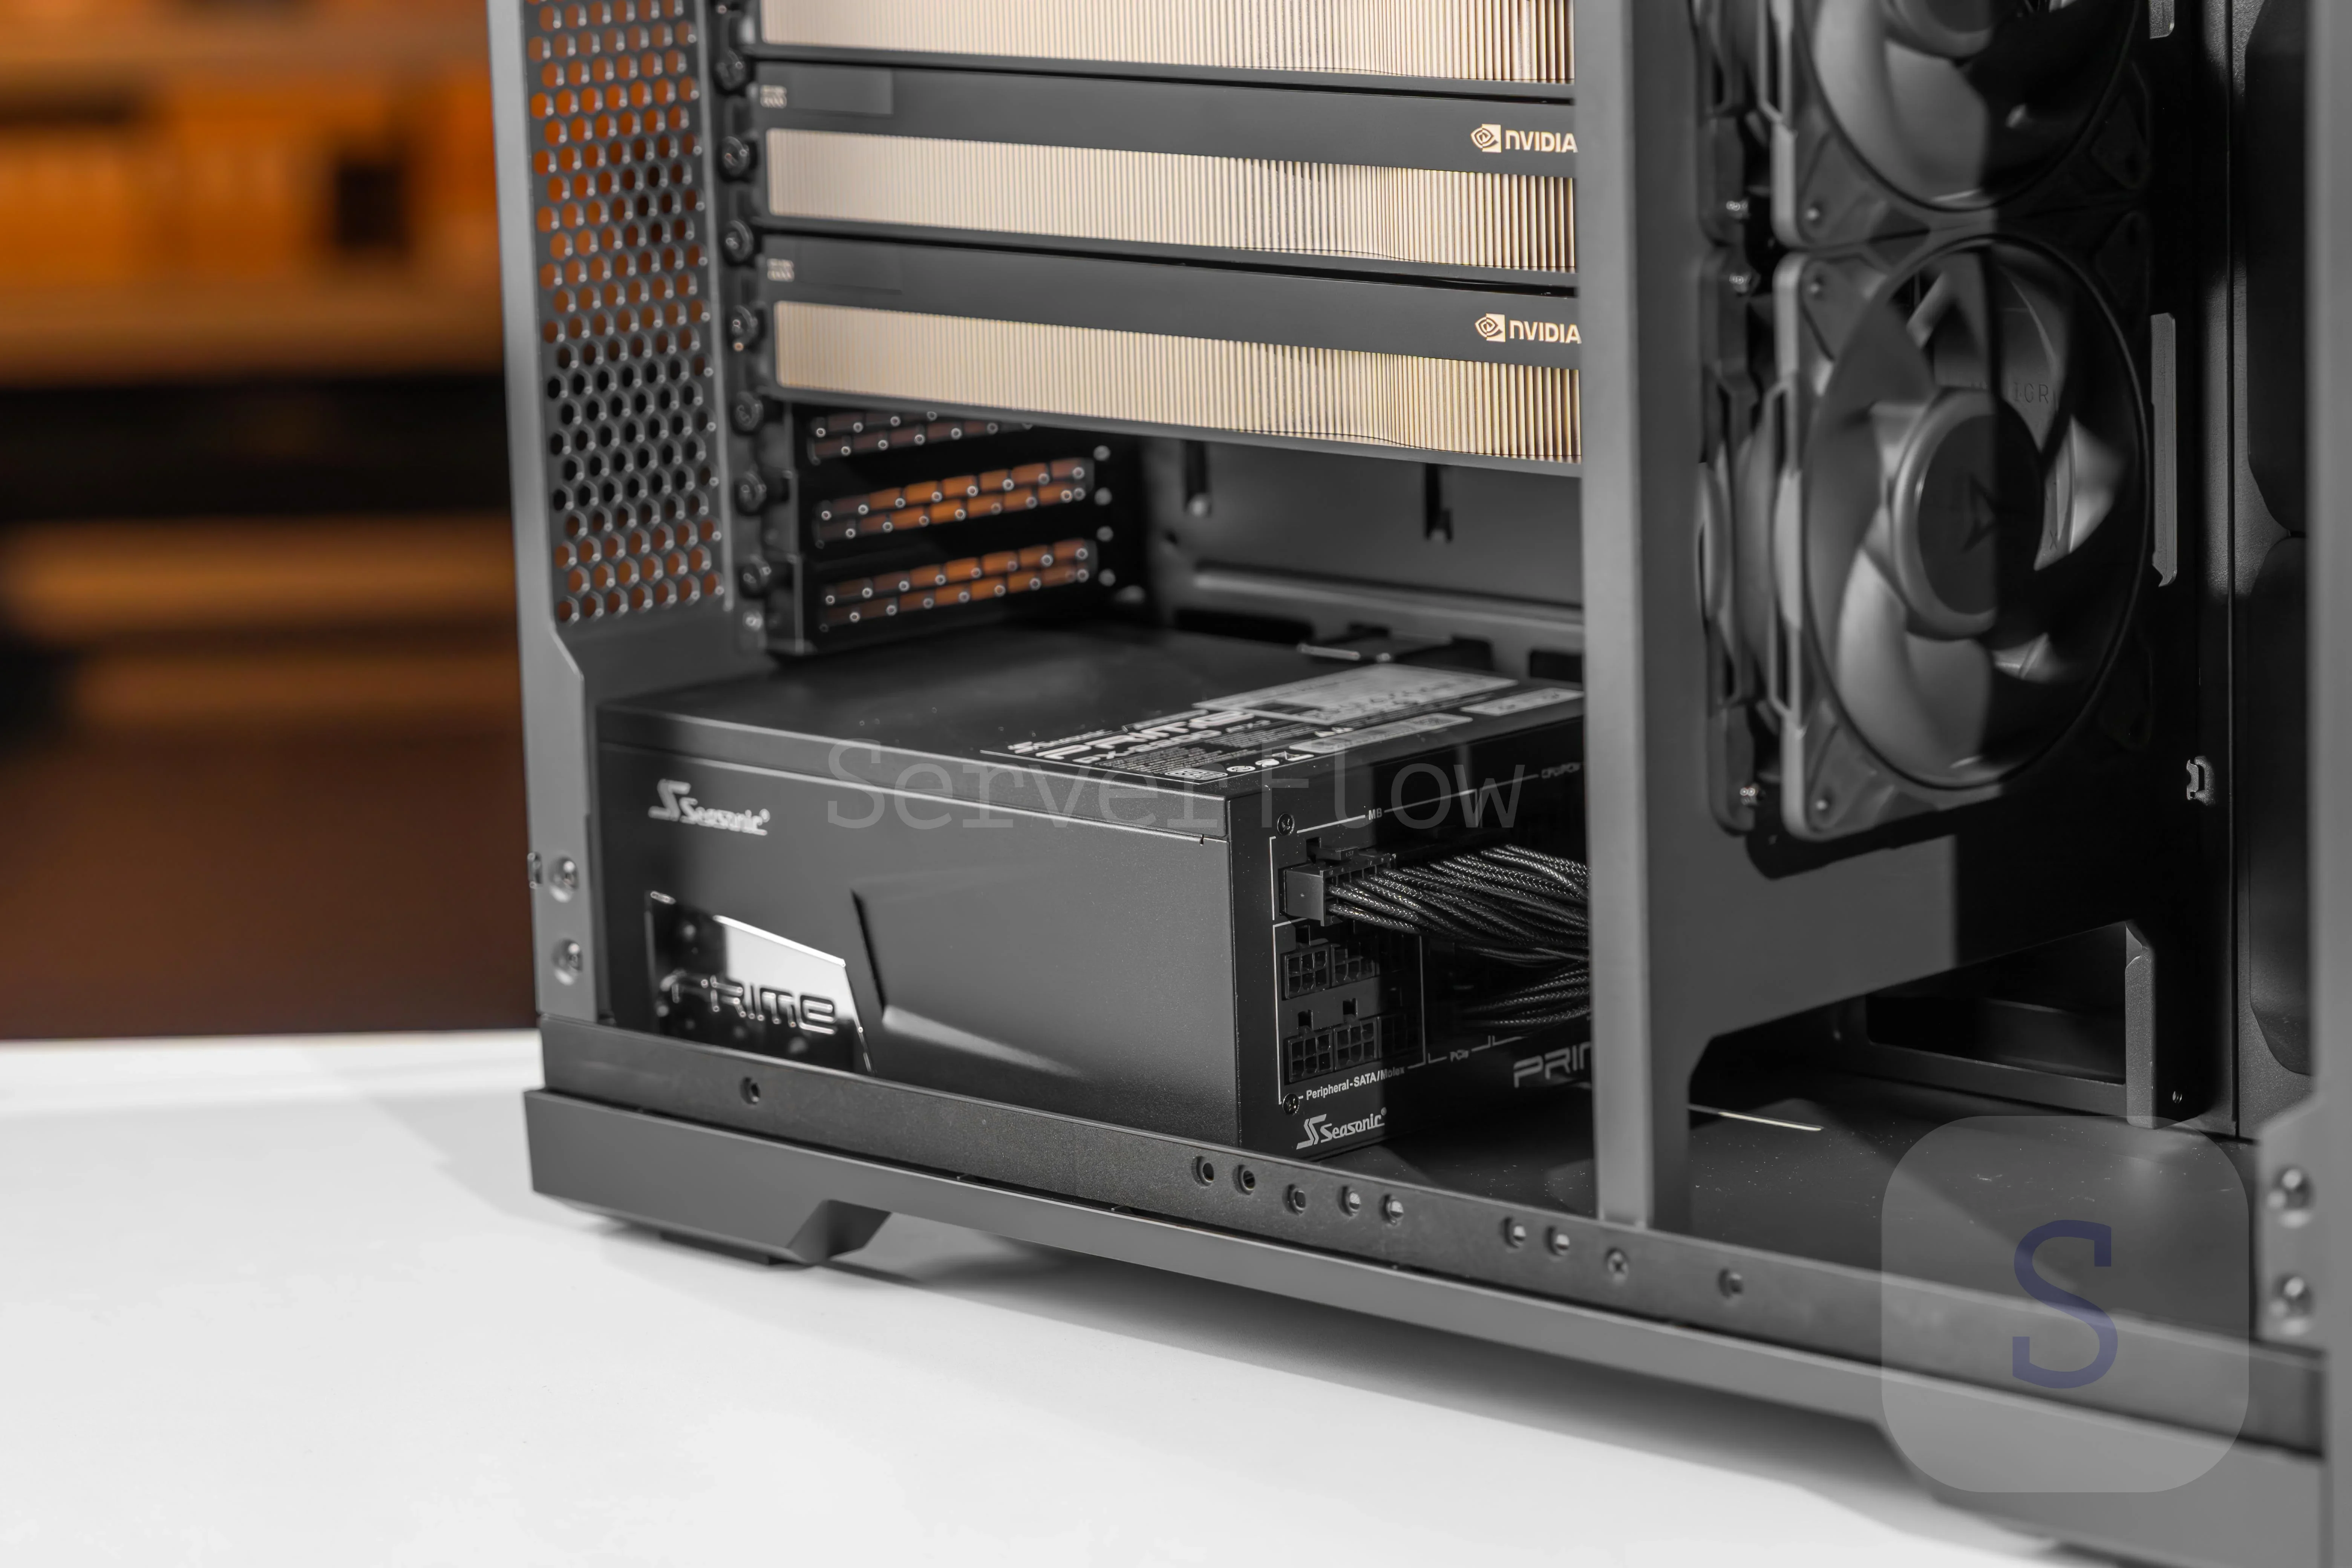
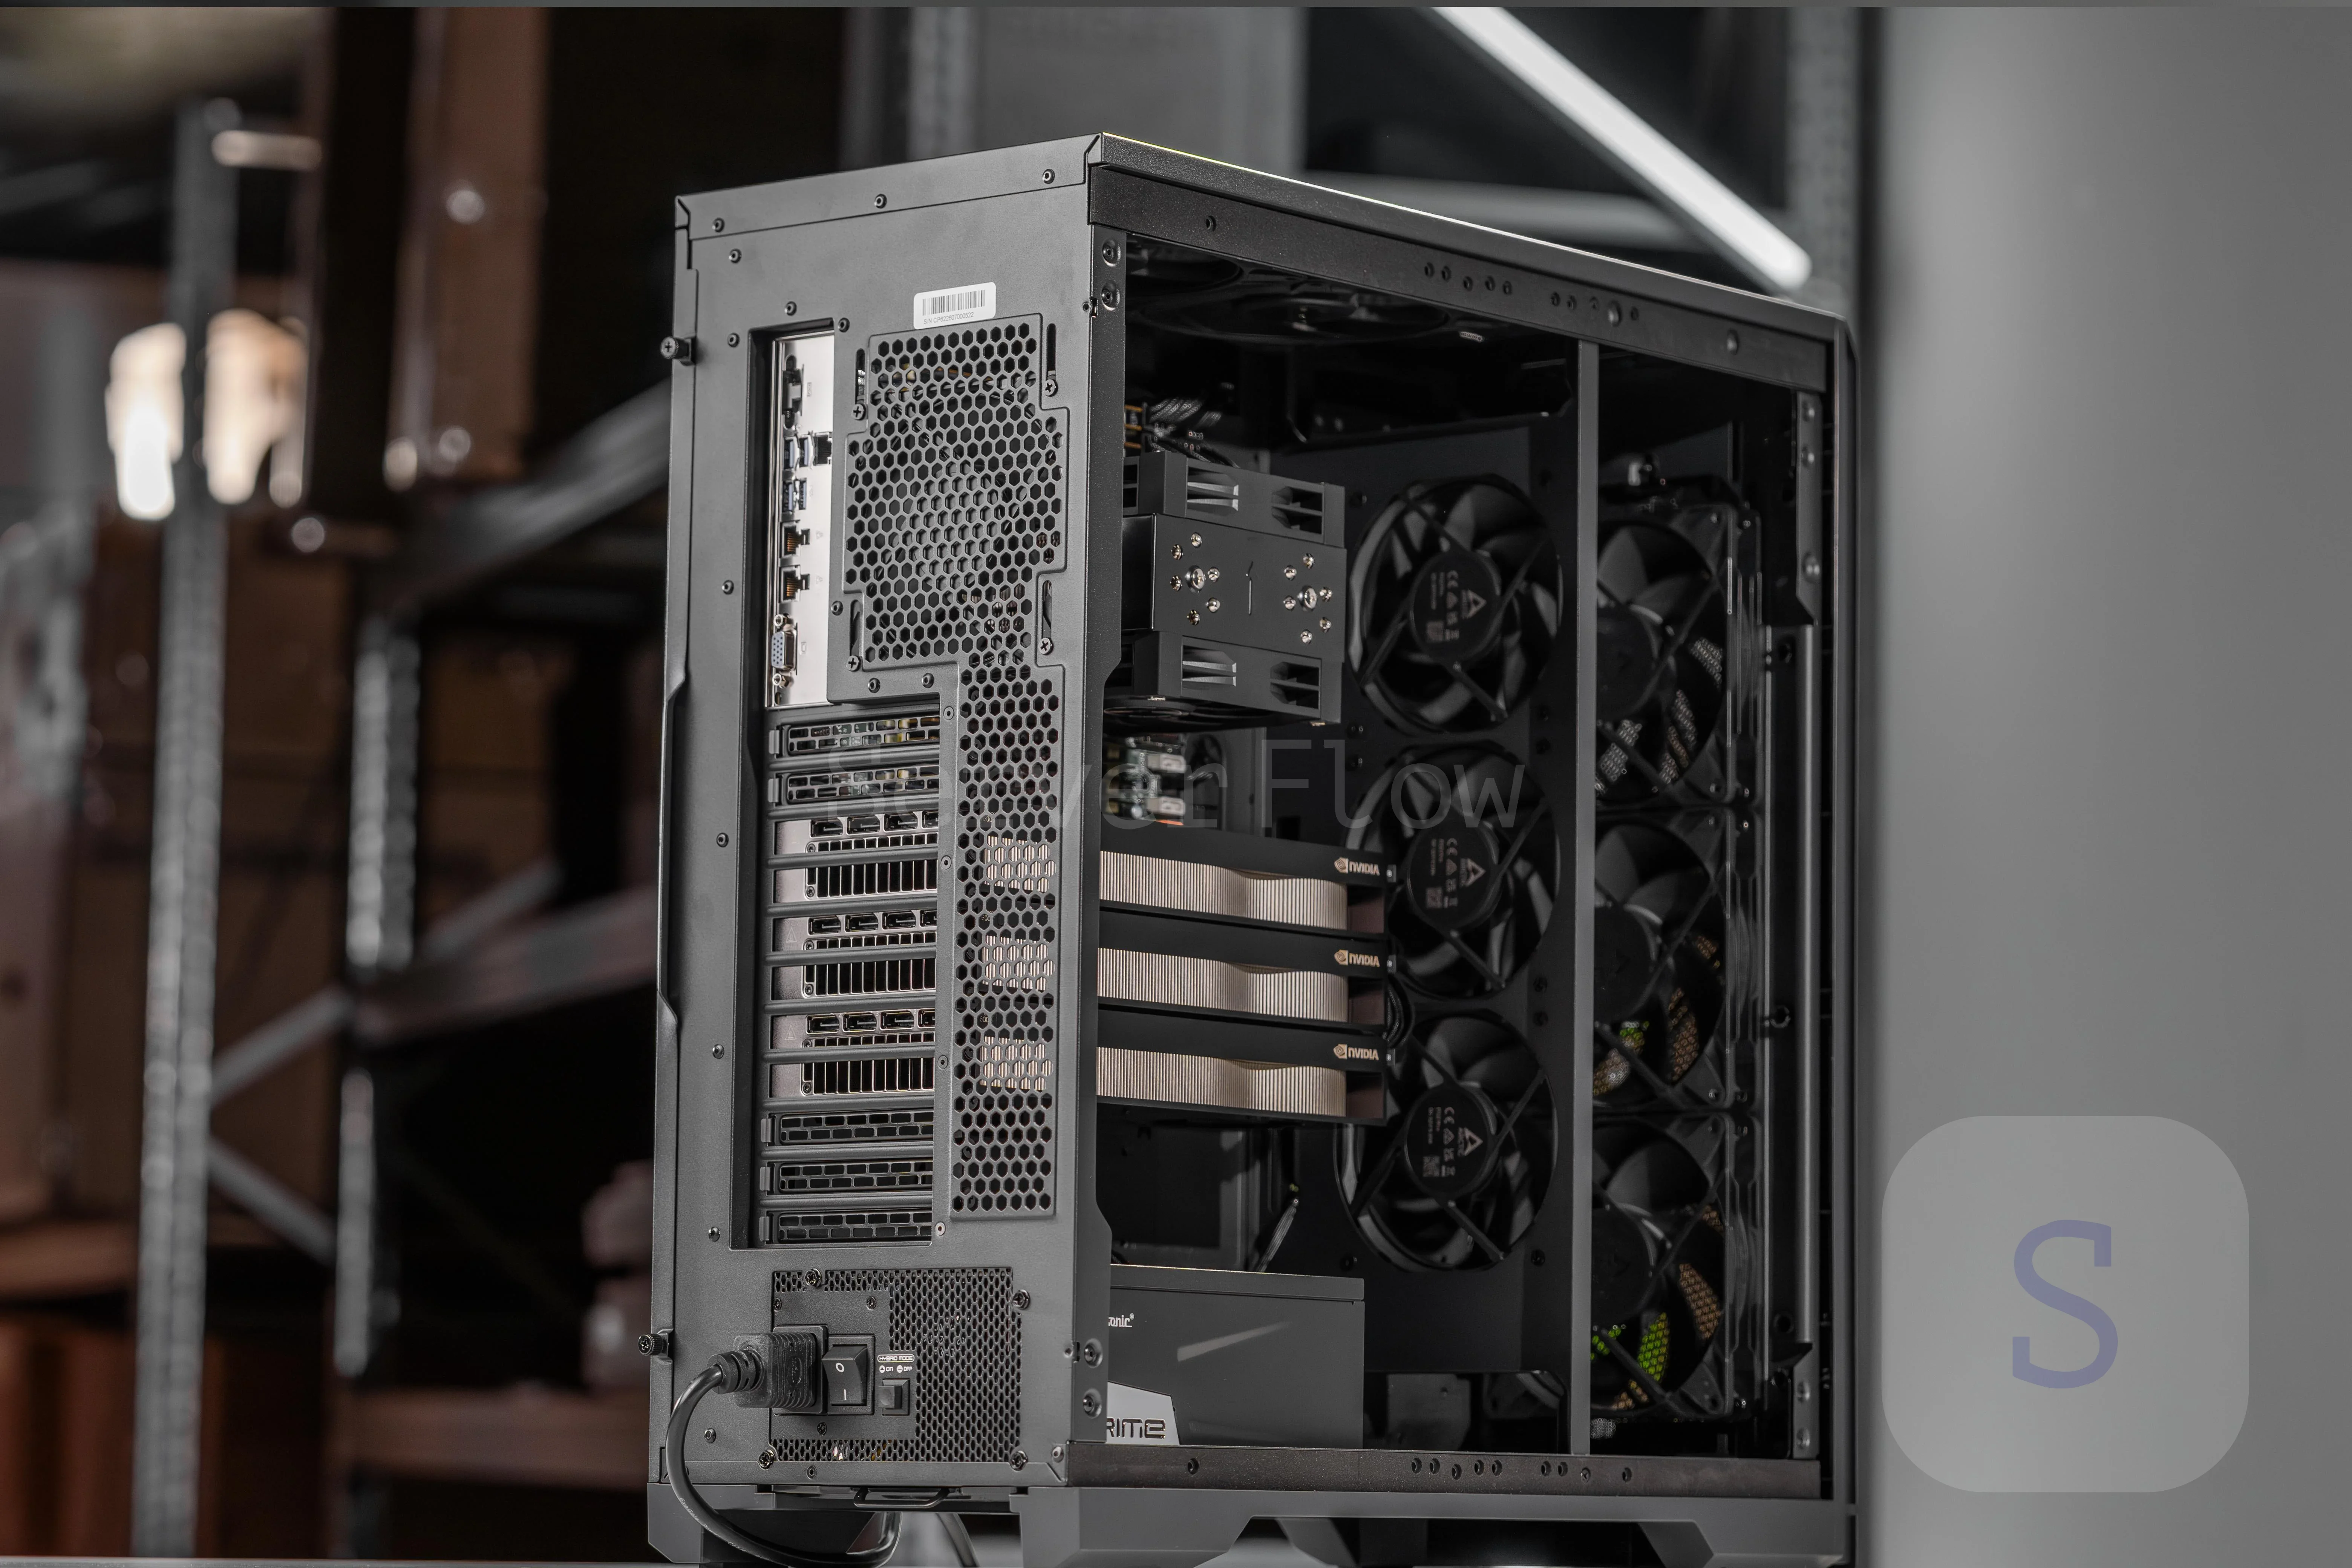
- Корпус - Phanteks Enthoo Pro 2 Server Edition - 1 шт.
- Корпусные вентиляторы - ARCTIC P12/P14 Pro PWM - 7 шт.
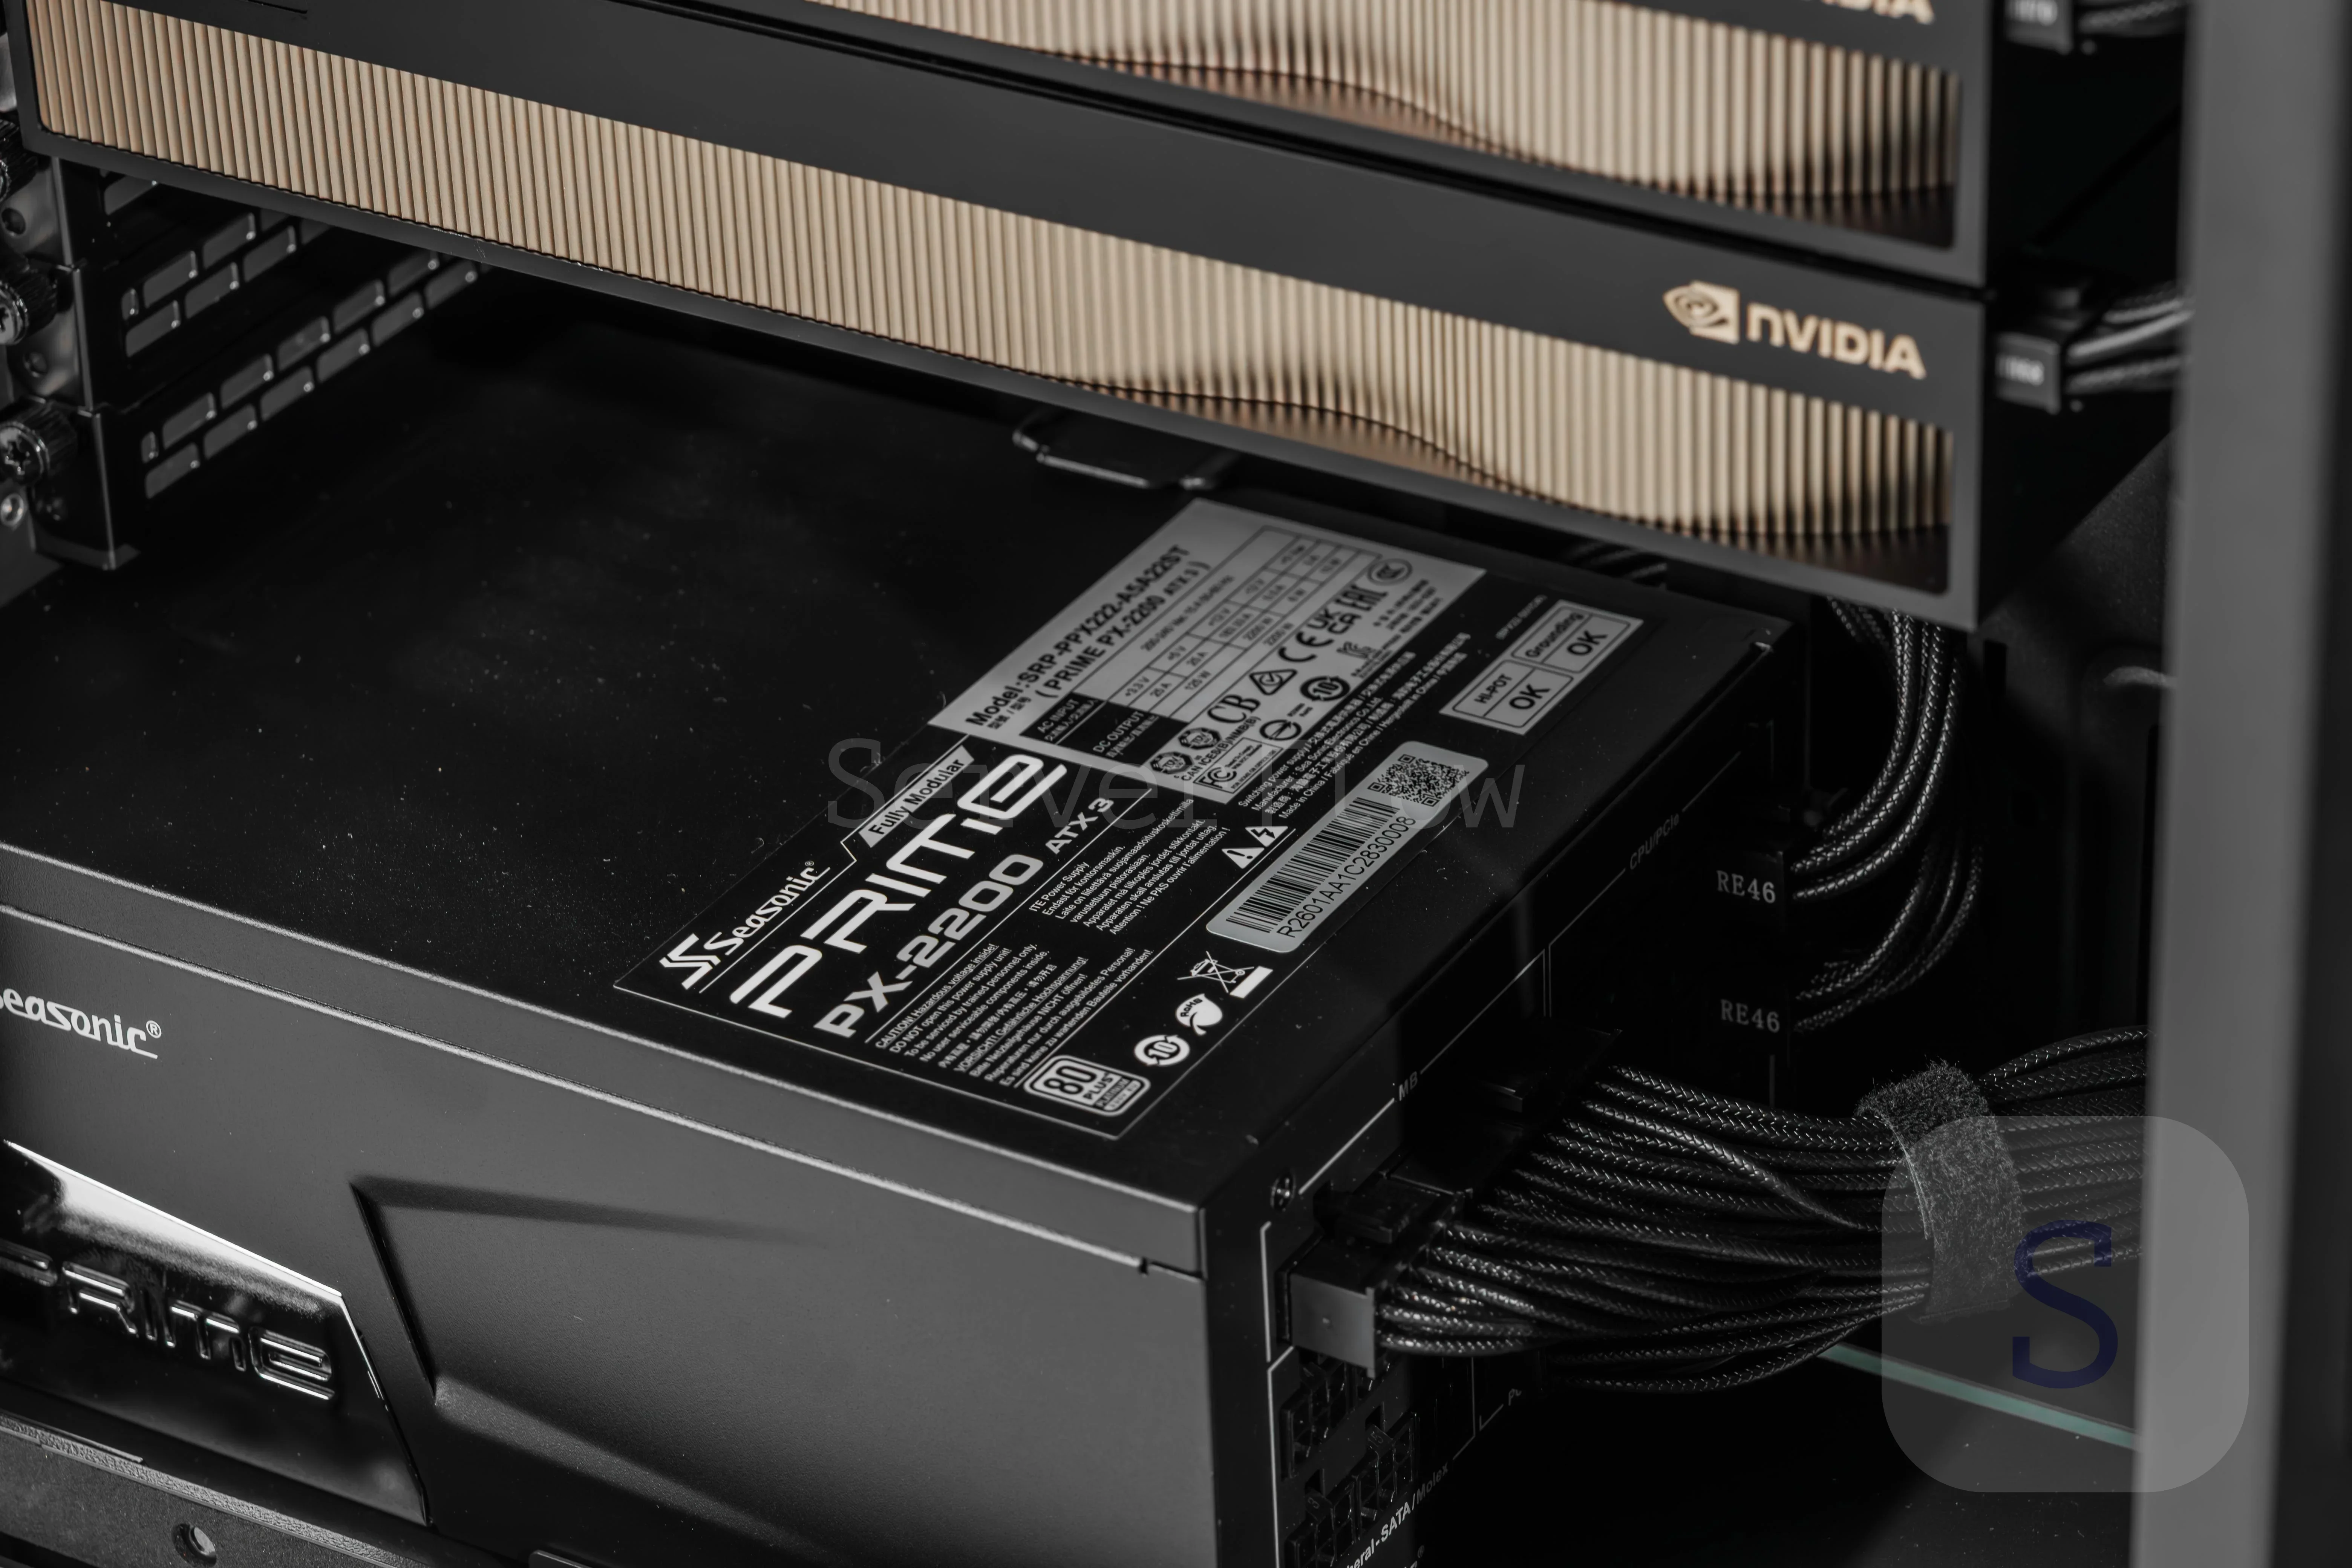
- Блок питания - Seasonic PRIME PX-2200, 2200 Вт, ATX 3.1 - 1 шт.
- SSD-накопитель - WD_BLACK SN7100 4 ТБ, PCIe 4.0 ×4 - 1 шт.
- HDD-накопители - Seagate Exos X18 14TB - 2 шт. (суммарный объём 28 ТБ).
Этот проект - GPU-сервер для локального запуска больших языковых моделей, собранный на базе 32-ядерного AMD EPYC 9354 и трёх профессиональных видеокарт NVIDIA RTX PRO 6000 Blackwell Max-Q по 96 ГБ. Суммарный объём видеопамяти составляет 288 ГБ, а оперативной - 192 ГБ DDR5 ECC RDIMM. Конфигурация предназначена для распределённого инференса крупных LLM, обработки длинного контекста и параллельной работы нескольких экземпляров нейросетей.
Задача
Команде ServerFlow предстояло собрать высокопроизводительный GPU-сервер для работы с современными нейросетями. Основное требование - обеспечить достаточный объём видеопамяти и вычислительную мощность для запуска крупных языковых моделей на собственном оборудовании.
Система должна была поддерживать несколько сценариев: распределение одной большой модели между несколькими видеокартами, запуск нейросетей с длинным контекстным окном и одновременную работу нескольких независимых экземпляров LLM.
Отдельной задачей было обеспечить эффективное охлаждение трёх профессиональных GPU при продолжительной нагрузке. Для этого требовалось подобрать корпус, систему вентиляции и блок питания с необходимым запасом мощности, а затем проверить реальные температуры, энергопотребление и уровень шума.
Решение команды ServerFlow
Мы спроектировали и собрали сервер на базе процессора AMD EPYC 9354, материнской платы Supermicro H13SSL-N и трёх видеокарт NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition по 96 ГБ.
Совокупный объём видеопамяти составил 288 ГБ GDDR7 ECC, а оперативной памяти - 192 ГБ DDR5 ECC RDIMM.
В качестве корпуса выбрали Phanteks Enthoo Pro 2 Server Edition, позволяющий разместить три профессиональные видеокарты, серверную платформу и дополнительные накопители в одной системе.
После сборки провели стресс-тестирование в OCCT Power и проверили производительность нескольких больших языковых моделей через vLLM.
Температуры, потребление и уровень шума
| Показатель | Optimal Speed | FullSpeed |
|---|---|---|
| Шум, дБ | 50 | 65 |
| Потребление из розетки, Вт | 1 200 | 1 285 |
| CPU - средняя температура ядер, °C | 61,4 | 48,9 |
| CPU - Tctl/Tdie, °C | 60,0 | 48,7 |
| CPU - эффективная частота ядер, ГГц | 2,99 | 3,02 |
| CPU - Package Power / PPT, Вт | 245 / 267 | 244 / 264 |
| Кулер процессора FAN2, об/мин | 700 | 1 680 |
| Корпусные FAN1 / FAN3 / FAN4, об/мин | 1 400 / 1 120 / 1 120 | 2 940 / 2 380 / 2 380 |
| Плата - System / Peripheral, °C | 39,0 / 49,0 | 28,8 / 39,9 |
| VRM CPU - VRM0 / VRM1, °C | 62,9 / 54,1 | 52,5 / 40,8 |
| Память - DIMM A–F / G–L, °C | 44,0 / 49,0 | 32,6 / 38,8 |
| SSD WD_BLACK - два датчика, °C | 41,4 / 59,0 | 33,7 / 49,9 |
Переход на FullSpeed снизил среднюю температуру ядер процессора с 61,4 до 48,9 °C, то есть на 12,5 °C. При этом уровень шума увеличился с 50 до 65 дБ, а потребление из розетки - с 1200 до 1285 Вт.
В режиме простоя с профилем Optimal Speed сервер потреблял 220 Вт, а уровень шума составлял 35 дБ.
Температуры трёх NVIDIA RTX PRO 6000 Blackwell
| Видеокарта и режим | Ядро, °C | Память, °C | Hot Spot, °C | Вентилятор, об/мин | GPU, Вт |
|---|---|---|---|---|---|
| GPU 0 - Optimal | 72,7 | 74,0 | 76,3 | 2 416 | 292 |
| GPU 0 - FullSpeed | 63,5 | 63,9 | 67,4 | 3 350 | 300 |
| GPU 1 - Optimal | 80,0 | 80,0 | 83,9 | 3 101 | 300 |
| GPU 1 - FullSpeed | 78,6 | 79,3 | 82,4 | 3 350 | 300 |
| GPU 2 - Optimal | 76,9 | 76,0 | 80,9 | 2 826 | 300 |
| GPU 2 - FullSpeed | 69,9 | 67,8 | 73,7 | 3 350 | 300 |
Наибольшую температуру в обоих режимах показала GPU 1: 80 °C по ядру при Optimal Speed и 78,6 °C при FullSpeed.
Повышение оборотов вентиляторов заметно улучшило охлаждение GPU 0 и GPU 2, снизив среднюю температуру их ядер примерно на 9,1 и 7 °C соответственно. При этом GPU 1 реагировала на изменение профиля охлаждения значительно слабее: температура ядра снизилась примерно на 1,5 °C.
Тестирование позволило сравнить эффективность двух профилей вентиляции и оценить компромисс между температурой компонентов, уровнем шума и энергопотреблением.
Тестирование производительности нейросетей
После проверки аппаратной части мы протестировали систему в задачах локального инференса больших языковых моделей.
Для запуска использовали vLLM. Проверяли производительность DeepSeek, Nemotron и Qwen в разных конфигурациях - от одной до трёх видеокарт. Отдельно оценивали скорость генерации одного ответа, суммарную производительность при параллельных запросах и возможность обработки длинного контекста.
Результаты тестирования LLM
| Модель и конфигурация | Результат |
|---|---|
| DeepSeek V4 Flash 0731 NVFP4 / FP8, 2 GPU, TP=2 | 219,60 ток/с при одиночной генерации (медиана 5 прогонов, DSpark k=3, Marlin). В пакетном тесте без DSpark - 559,80 ток/с при 32 параллельных запросах. Обработано 119 982 входных токена в тесте длинного контекста. |
| Nemotron 3.5 Super VL 120B-A12B NVFP4 / FP8, 1 GPU, TP=1, MTP5 | 768,25 ток/с при 32 параллельных запросах. В режиме контекста 320K обработано 319 806 входных токенов за 57,81 с. |
| Qwen3.8 27B NVFP4 1 GPU, FP8 KV-кеш | При одиночной генерации MTP3 увеличил скорость с 57,22 до 105,55 ток/с. Пиковая производительность пакетного теста - 534,07 ток/с при 64 параллельных запросах. Успешно запущен профиль 256K. |
| 9 × Qwen3.8 27B NVFP4 3 GPU, по 3 экземпляра на каждой | 1383,31 ток/с по общему времени прогона при 4608 параллельных клиентских запросах. За все уровни нагрузки - 20 736 успешных запросов и 0 ошибок. |
Скорости приведены в выходных токенах в секунду. Одиночная генерация и пакетный инференс - разные сценарии нагрузки, поэтому их показатели напрямую не сопоставляются.
Распределение больших моделей между GPU
При работе с крупными языковыми моделями одним из главных ограничений является объём доступной видеопамяти. В конфигурации с тремя NVIDIA RTX PRO 6000 Blackwell Max-Q сервер располагает 288 ГБ совокупной VRAM. Однако видеопамять каждой карты физически независима, поэтому для размещения большой модели на нескольких GPU необходима соответствующая схема распределения.
В ходе тестирования мы проверили запуск DeepSeek с распределением слоёв модели по трём видеокартам в режиме Pipeline Parallelism (PP=3). По данным nvidia-smi, загрузка видеопамяти составила 80 708, 92 018 и 85 608 MiB на трёх GPU соответственно.
Это подтвердило возможность размещения крупной модели с использованием ресурсов всех трёх ускорителей.
Работа с длинным контекстом
Отдельное внимание уделили обработке больших объёмов входного текста. При тестировании Nemotron на одной видеокарте с лимитом контекста 320K удалось обработать 319 806 входных токенов за 57,81 секунды. Для Qwen также успешно запустили профиль с контекстом 256K.
Такие сценарии актуальны при анализе больших документов, обработке программного кода, работе с базами знаний и других задачах, где нейросети необходимо учитывать значительный объём информации в одном запросе.
Использование видеопамяти
| Конфигурация | Занято по nvidia-smi, MiB |
|---|---|
| DeepSeek, 3 GPU, распределение слоёв PP=3 | 80 708 / 92 018 / 85 608 |
| Nemotron, 1 GPU, профиль 16K | 88 961 |
| Qwen, 1 GPU, профиль 256K | 86 214 |
Показатели включают не только веса моделей, но и KV-кеш, рабочие буферы и другие данные, необходимые для инференса. Например, в тесте Qwen при общей занятости 86 214 MiB загрузка весов модели составляла 18,96 GiB.
Одновременный запуск девяти экземпляров Qwen
Одним из основных испытаний стала проверка системы в режиме параллельного обслуживания большого количества запросов. На трёх видеокартах одновременно запустили девять независимых экземпляров Qwen3.8 27B - по три экземпляра на каждом GPU.
При контексте 4096 токенов на экземпляр и использовании MTP3 суммарная производительность составила 1383,31 выходного токена/с по общему времени прогона при 4608 параллельных клиентских запросах.
За все уровни нагрузочного тестирования система обработала 20 736 запросов без единой ошибки.
Этот результат демонстрирует эффективность многокарточной конфигурации не только при распределении одной большой модели, но и при работе нескольких независимых нейросетевых сервисов одновременно.
Результат
Команда ServerFlow собрала и протестировала производительный GPU-сервер на базе AMD EPYC 9354 и трёх NVIDIA RTX PRO 6000 Blackwell Max-Q с совокупным объёмом видеопамяти 288 ГБ.
Проведённые испытания подтвердили возможность работы системы в нескольких сценариях: распределённый инференс больших языковых моделей, обработка длинного контекста и одновременное обслуживание множества запросов.
В тесте девяти экземпляров Qwen на трёх GPU удалось достичь суммарной производительности 1383,31 выходного токена/с при отсутствии ошибок на всех уровнях нагрузки.
Дополнительно мы проверили температурные характеристики системы под полной нагрузкой. При потреблении до 1285 Вт из розетки сервер продемонстрировал возможность работы трёх профессиональных ускорителей в корпусе Phanteks Enthoo Pro 2 Server Edition.
В результате получилась вычислительная платформа для локального запуска LLM, развёртывания AI-сервисов и экспериментов с большими нейросетями без обязательного использования облачных вычислительных ресурсов.
Готовая сборка доступна для заказа. Этот GPU-сервер на базе AMD EPYC 9354 и трёх NVIDIA RTX PRO 6000 Blackwell Max-Q 96GB представлен в каталоге ServerFlow. Посмотреть конфигурацию и оформить заказ можно в карточке готового GPU-сервера.
Видео сборки и тестирования
Посмотреть процесс сборки, компоновку компонентов и проверку системы можно в нашем видео:
Фотографии