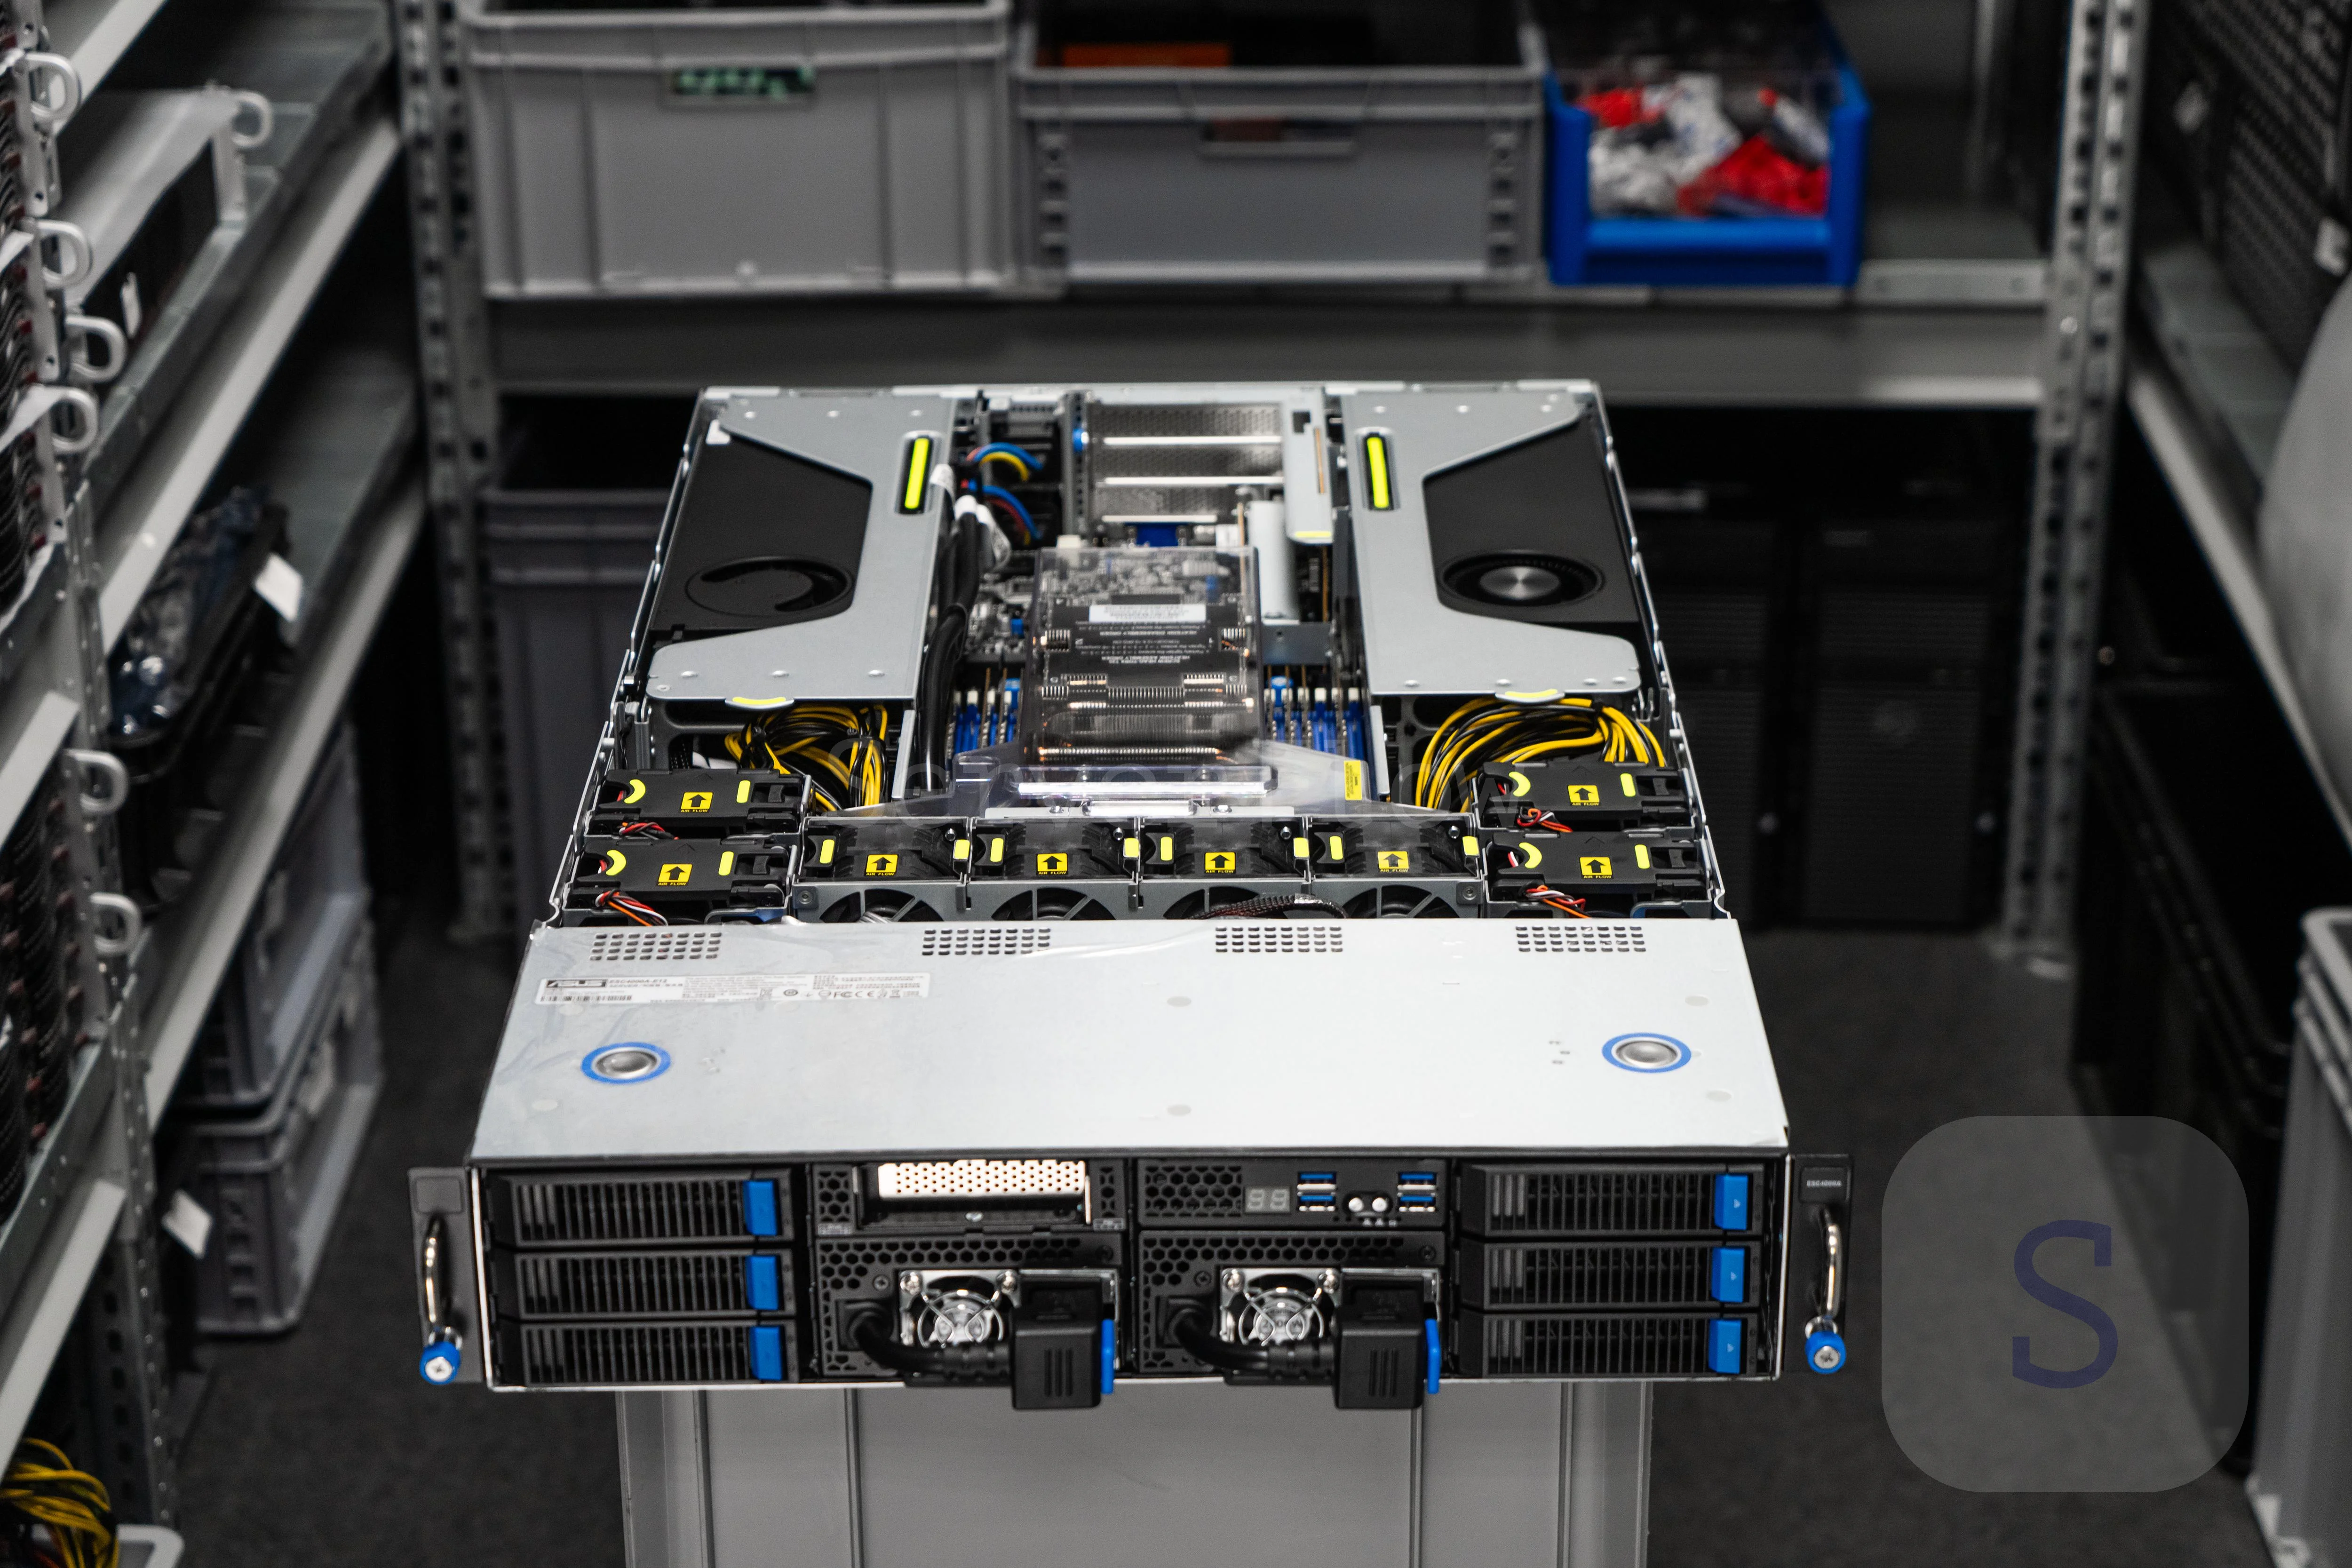
GPU-сервер ASUS ESC4000A-E12 с 4× NVIDIA RTX PRO 5000 Blackwell 72GB для локального запуска DeepSeek V4-Flash
- Серверная платформа - ASUS ESC4000A-E12 SKU1, 2U, Socket SP5, поддержка четырёх GPU с подключением PCIe 5.0 x16 - 1 шт.
- Процессор - AMD EPYC 9374F, 32 ядра / 64 потока, частота до 4,3 ГГц, TDP 320 Вт - 1 шт.
- Видеокарты - NVIDIA RTX PRO 5000 Blackwell 72GB GDDR7 - 4 шт. (совокупный объём видеопамяти 288 ГБ).
- Оперативная память - Samsung 16GB DDR5-4800 ECC REG 1Rx8 - 8 шт. (общий объём 128 ГБ).
- Накопитель - Intel D5-P5530 960GB U.2, PCIe 4.0 x4 - 1 шт.
- Блоки питания - Gospower G1302-2600WNA 2600W - 2 шт., резервирование по схеме 1+1.
Этот проект - GPU-сервер для локального запуска больших языковых моделей, построенный на платформе ASUS ESC4000A-E12 с четырьмя NVIDIA RTX PRO 5000 Blackwell по 72 ГБ. Суммарно система получила 288 ГБ видеопамяти GDDR7, размещённой на четырёх независимых ускорителях. Мы собрали конфигурацию для запуска DeepSeek V4-Flash-0731, проверили работу аппаратной части под нагрузкой и протестировали нейросеть в синтетических и практических сценариях.
Задача проекта
При локальном запуске крупных LLM одним из главных ограничений становится объём видеопамяти. Нужно не только разместить веса модели на GPU, но и оставить ресурсы под KV-кеш, длинные запросы и одновременную работу пользователей. При этом оборудование должно помещаться в серверную стойку и обеспечивать стабильное охлаждение всех ускорителей.
Мы поставили задачу собрать производительный 2U-сервер с четырьмя профессиональными видеокартами, организовать полноценное подключение GPU по PCIe 5.0 x16 и проверить, как такая платформа справляется с DeepSeek V4-Flash-0731. Отдельно оценивали температуры, энергопотребление и шум системы, а также скорость генерации при одиночных и параллельных запросах.
Решение команды ServerFlow
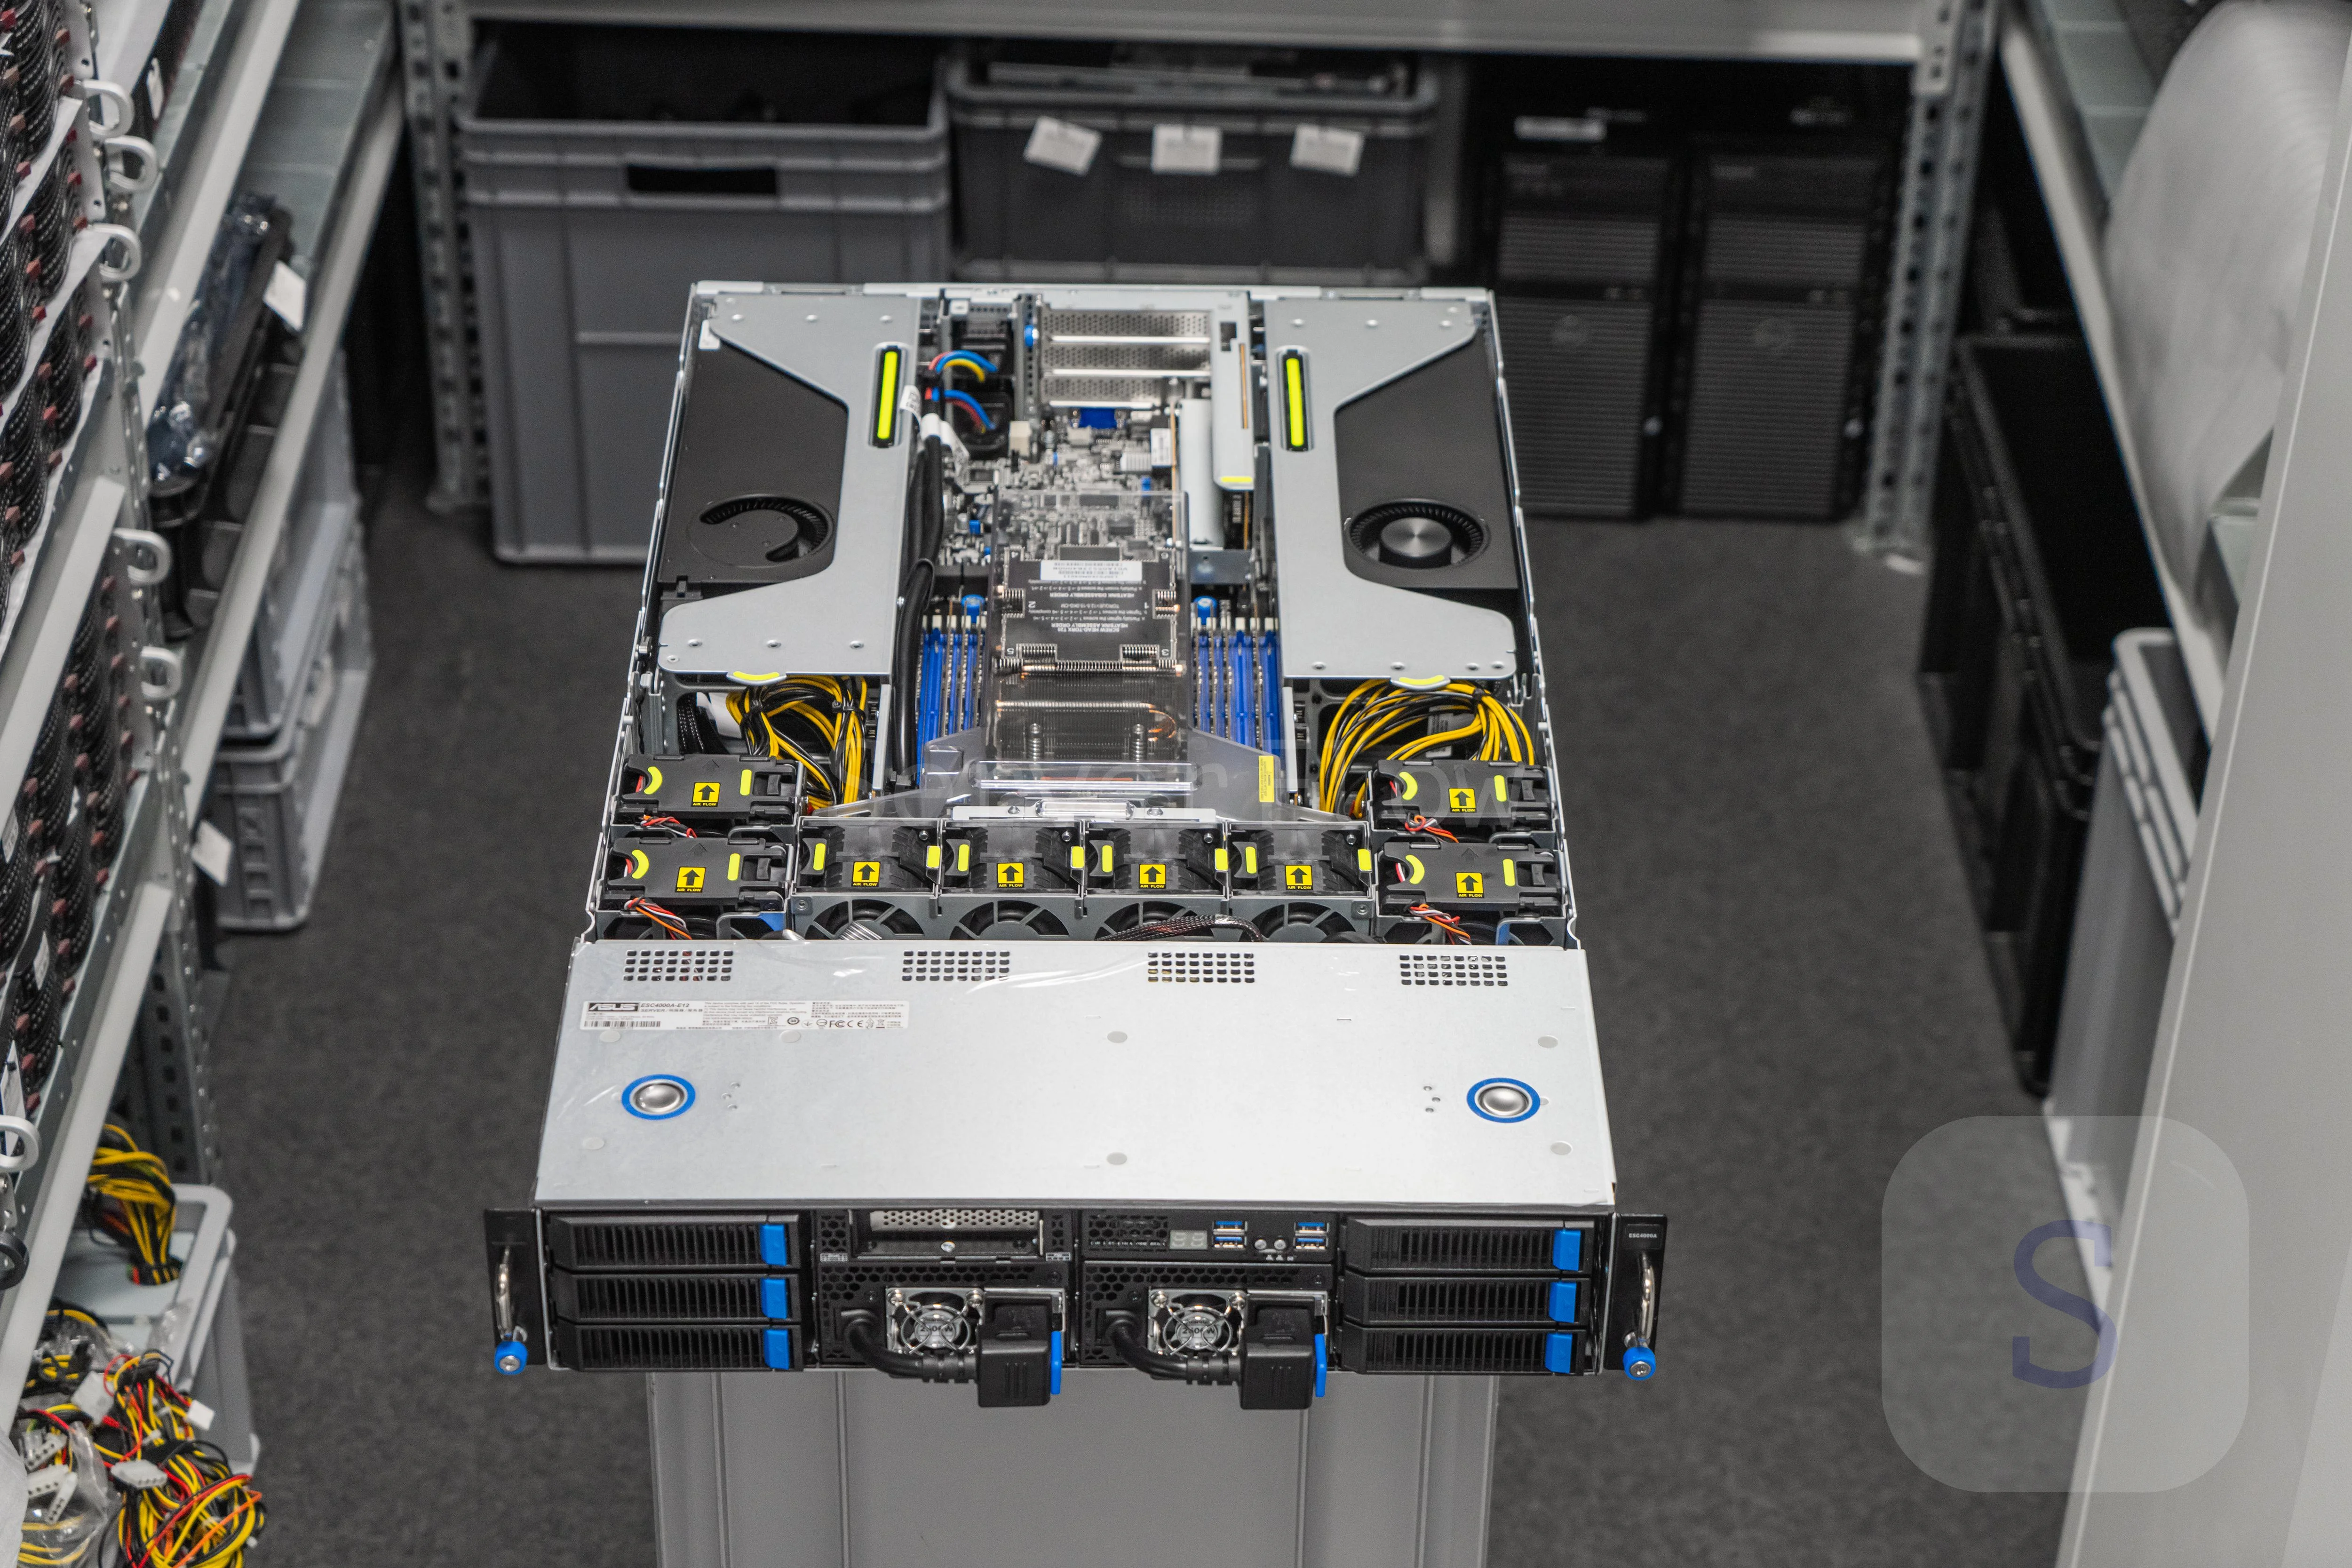
В основу сборки легла платформа ASUS ESC4000A-E12 с одним процессором AMD EPYC 9374F, 128 ГБ серверной памяти DDR5 ECC REG и четырьмя видеокартами RTX PRO 5000 Blackwell 72GB. В отличие от конфигурации на двух RTX PRO 6000 по 96 ГБ, четыре RTX PRO 5000 дают 288 ГБ совокупной видеопамяти вместо 192 ГБ. Это увеличивает доступный объём под модель и рабочие буферы, хотя использование четырёх GPU требует учитывать дополнительные затраты на обмен данными между ускорителями.
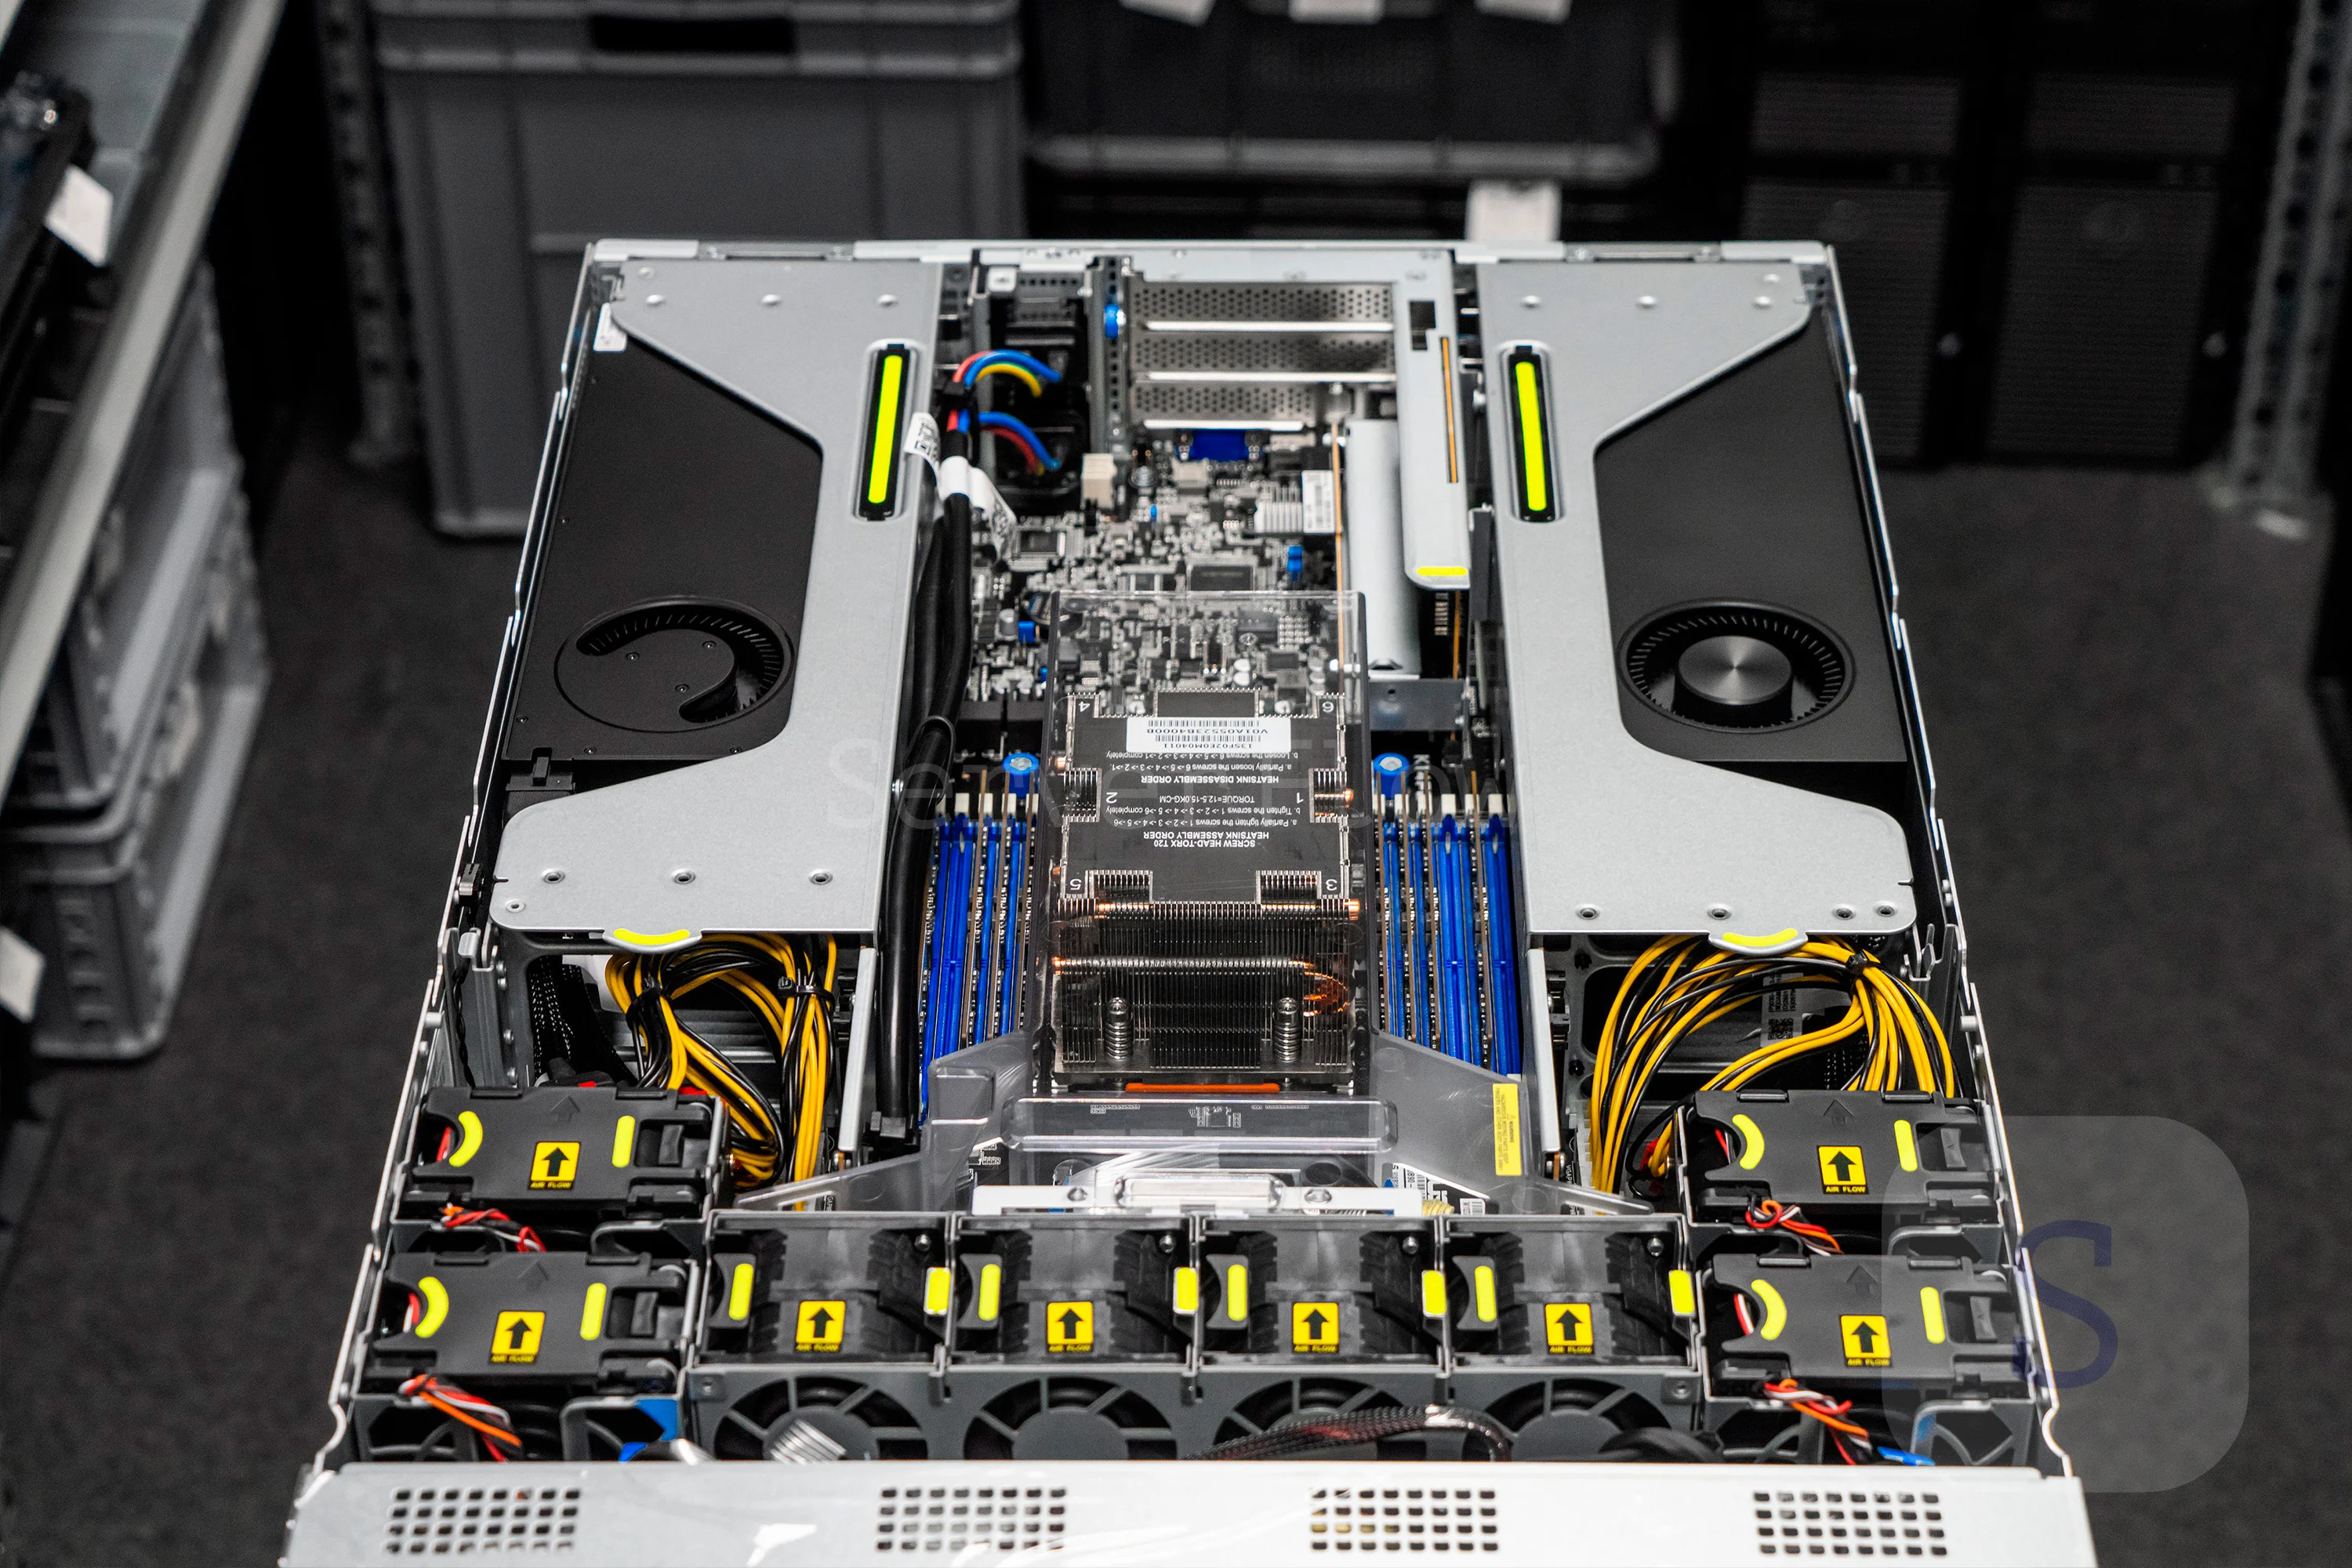
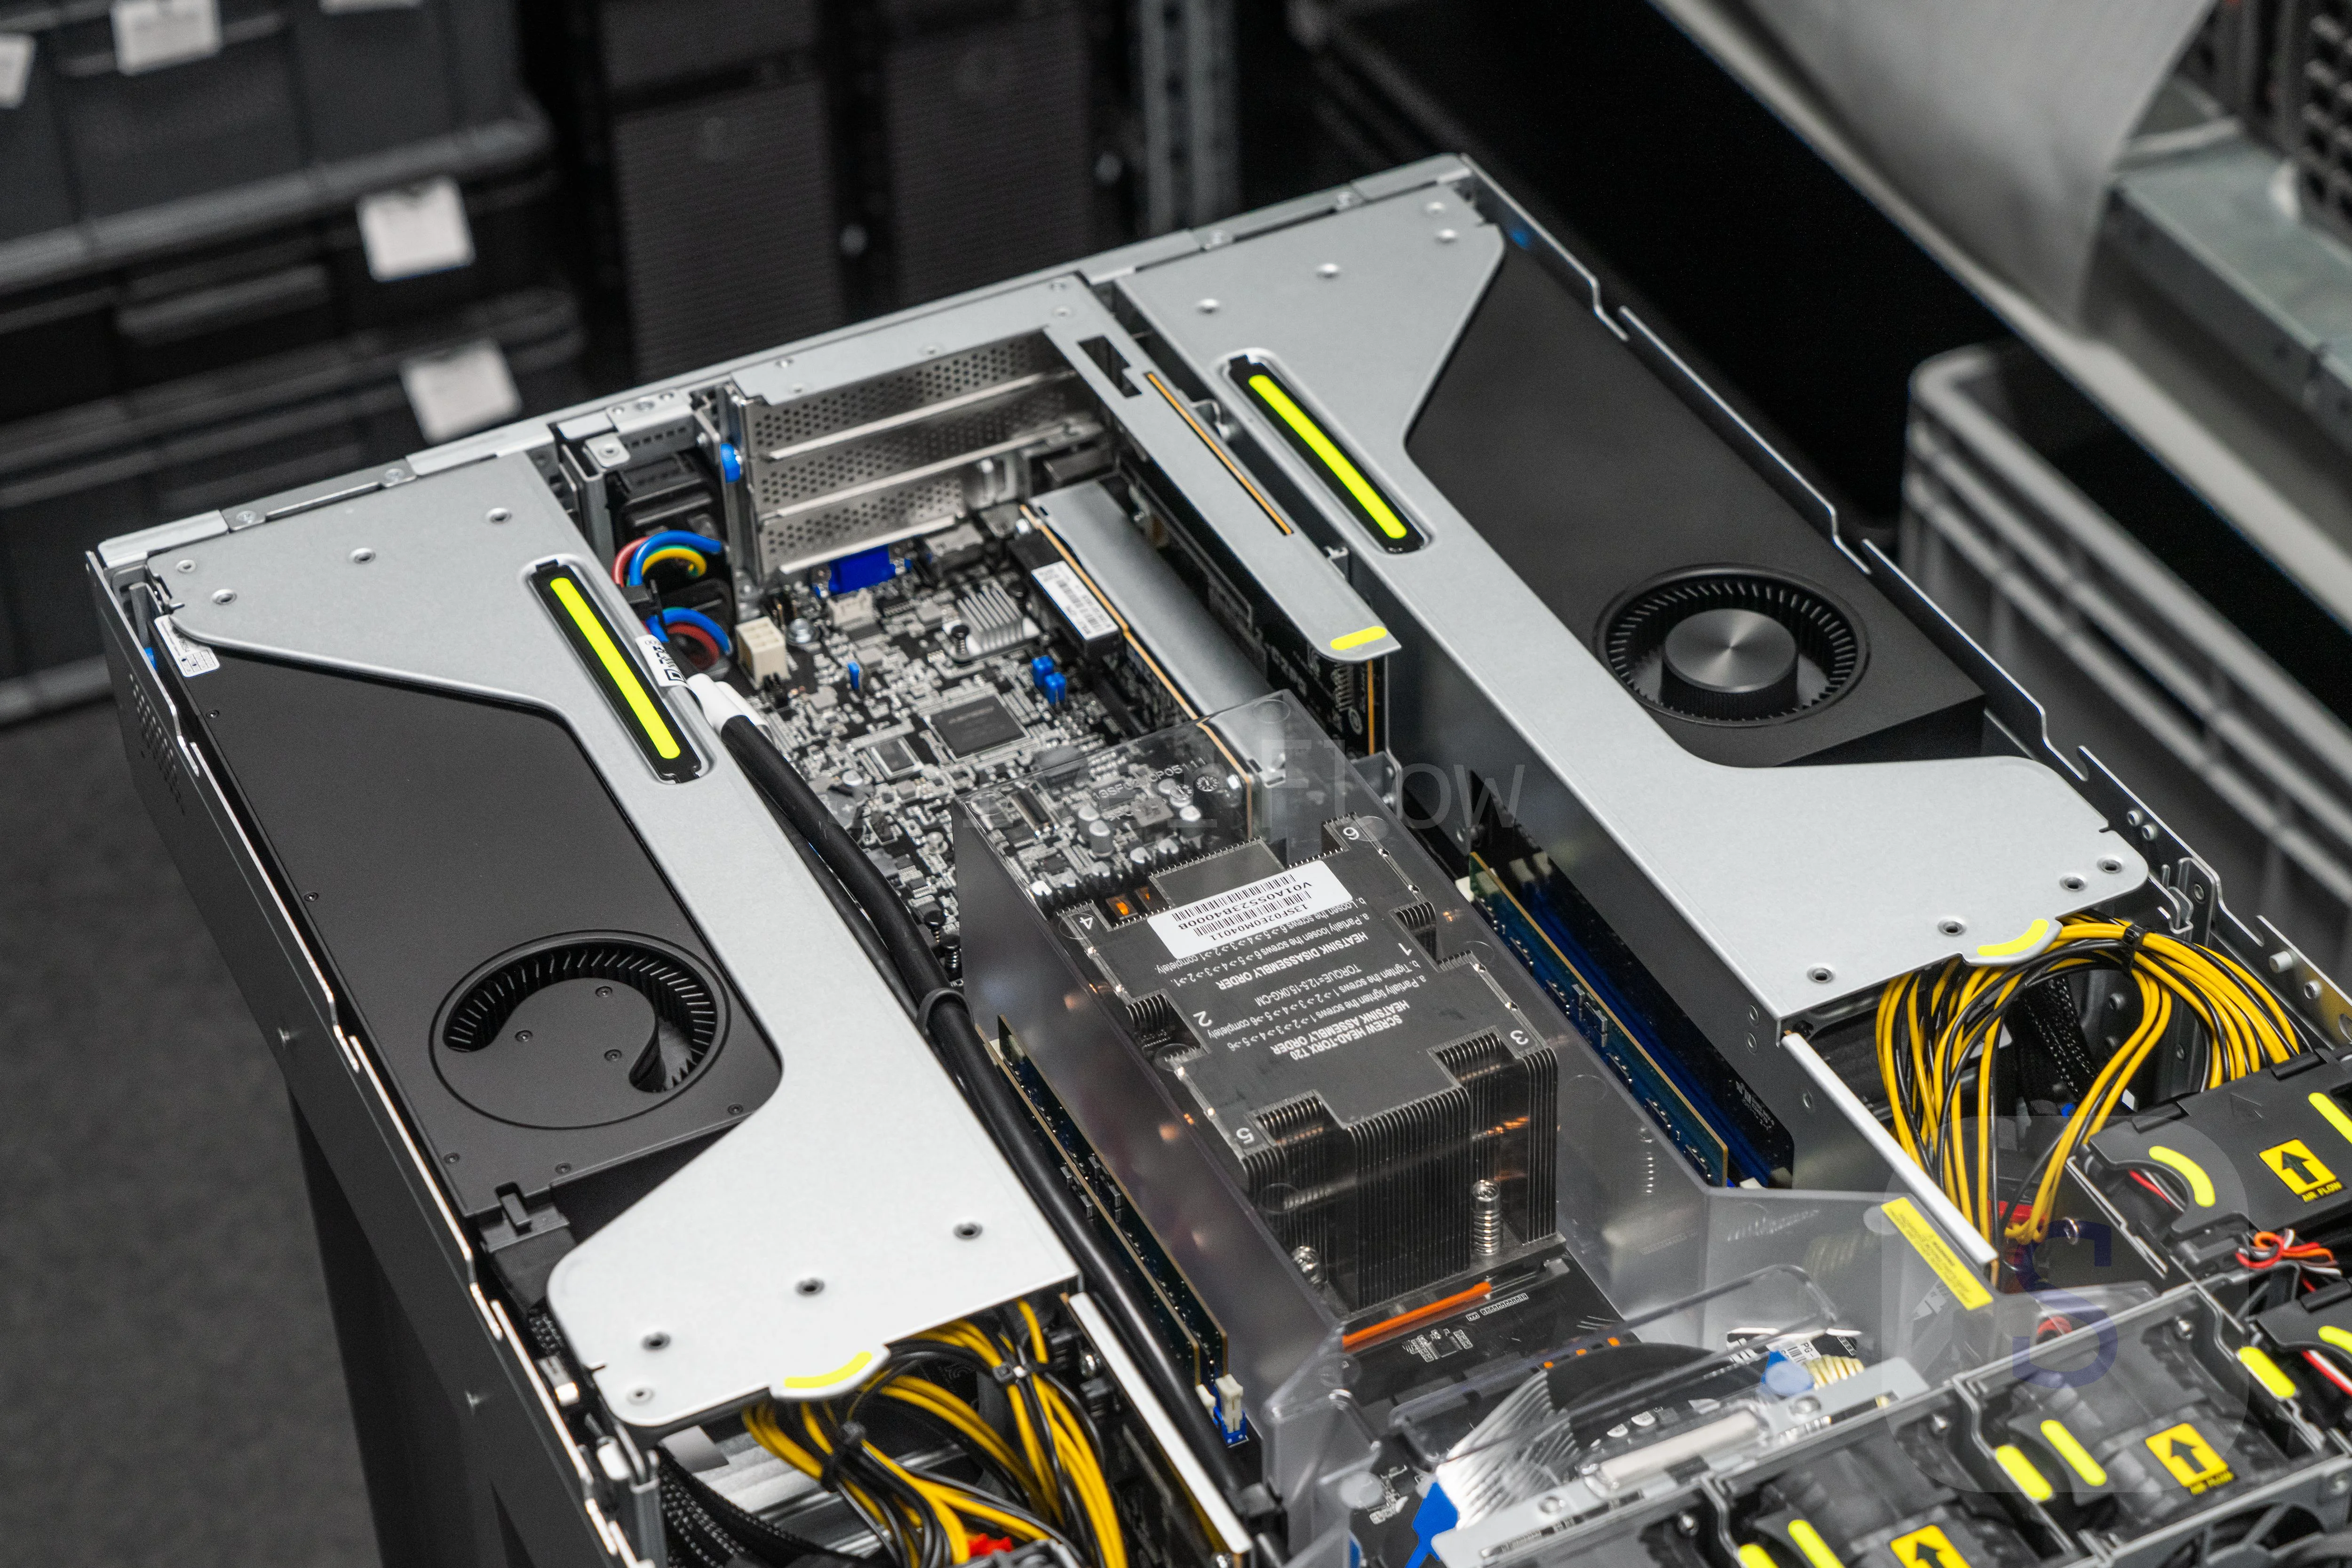
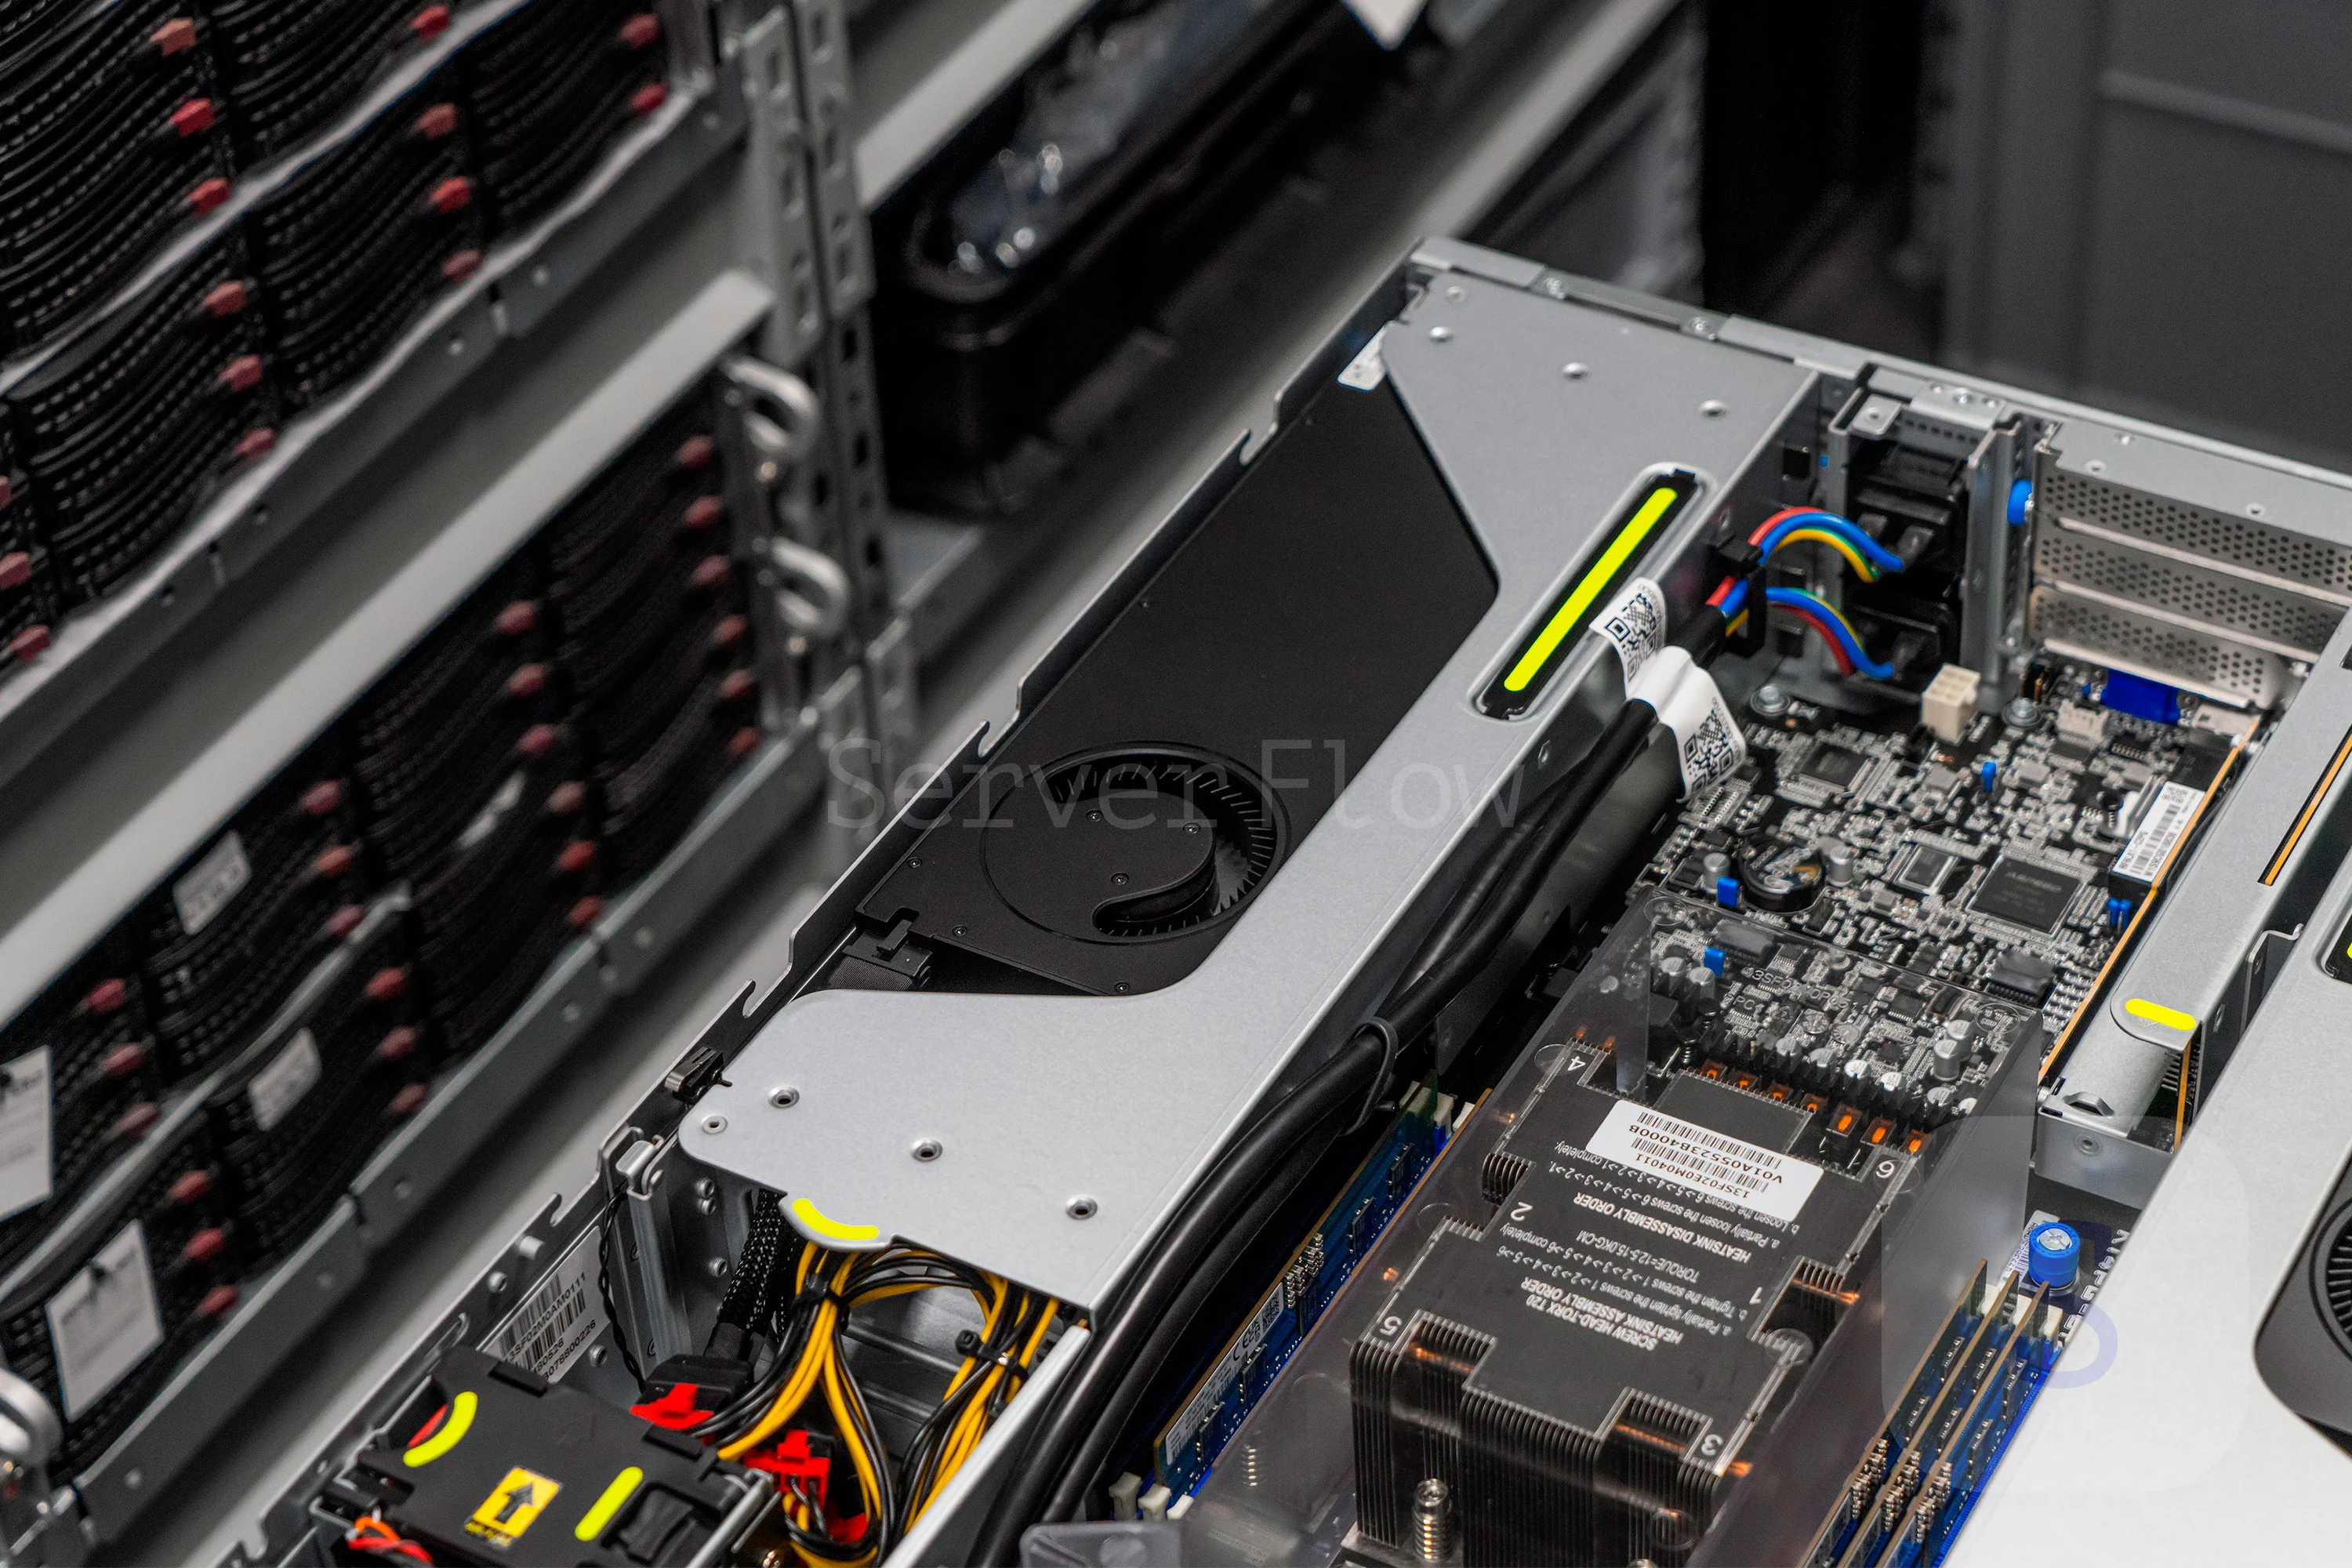
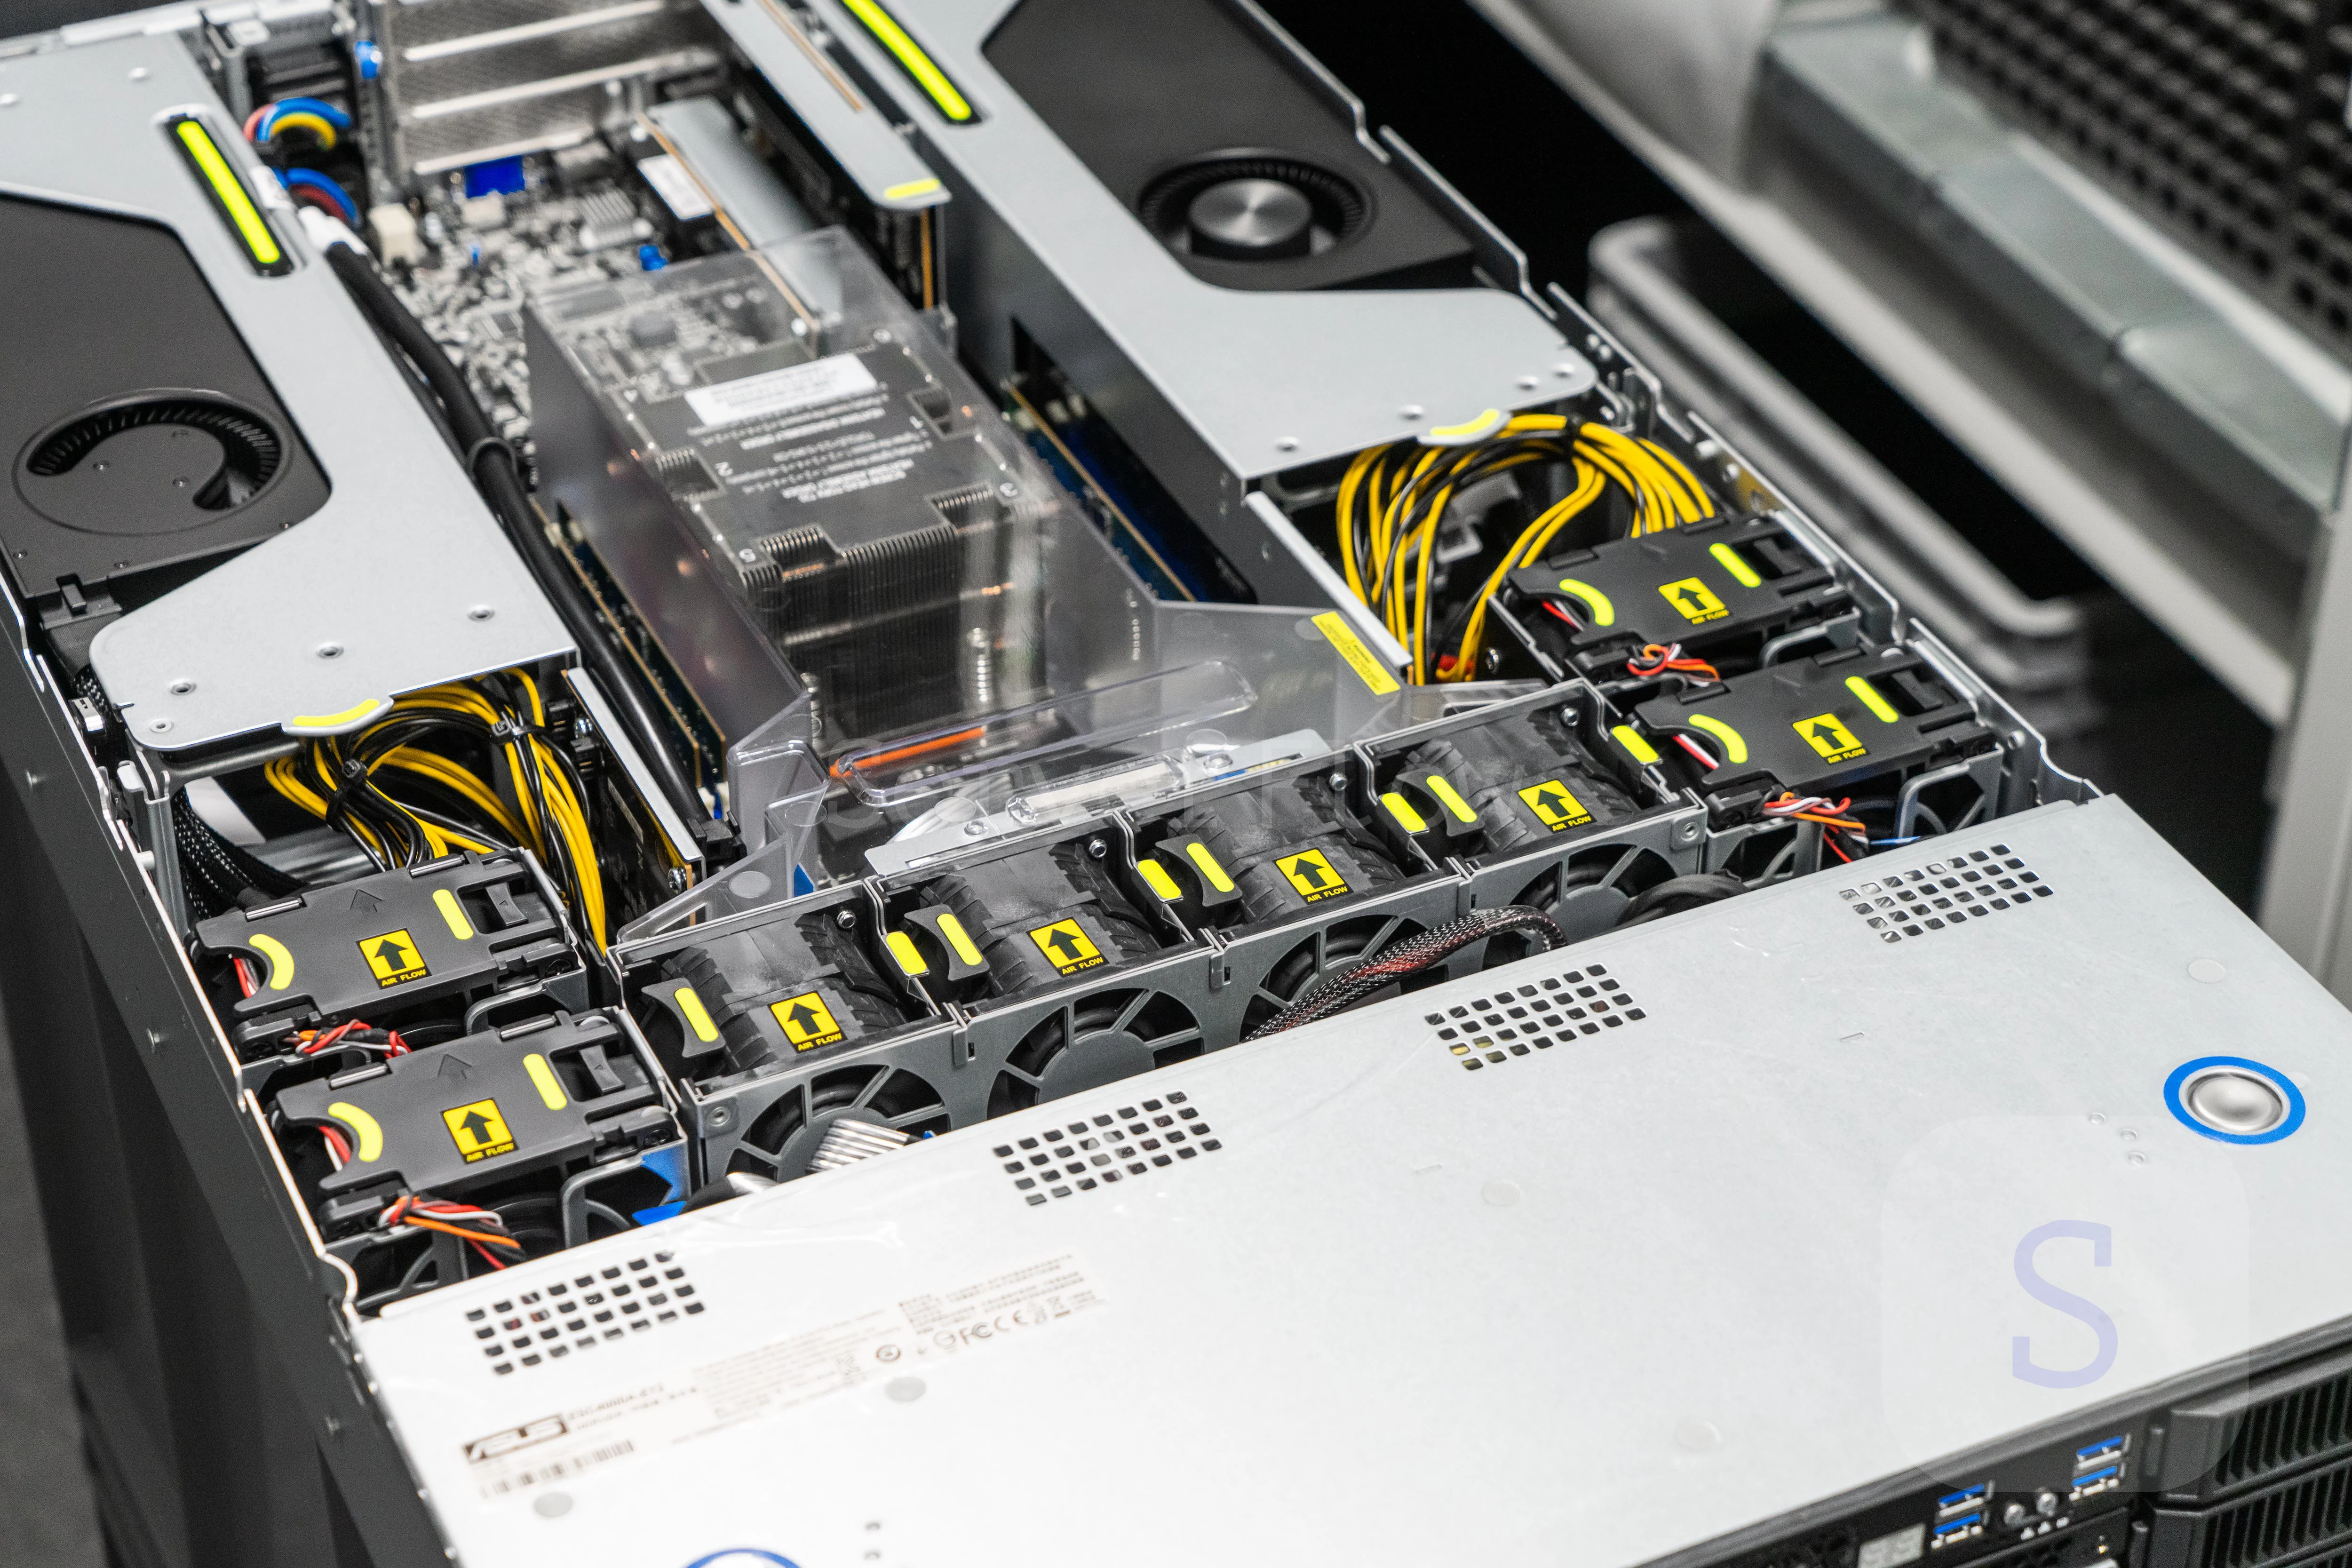
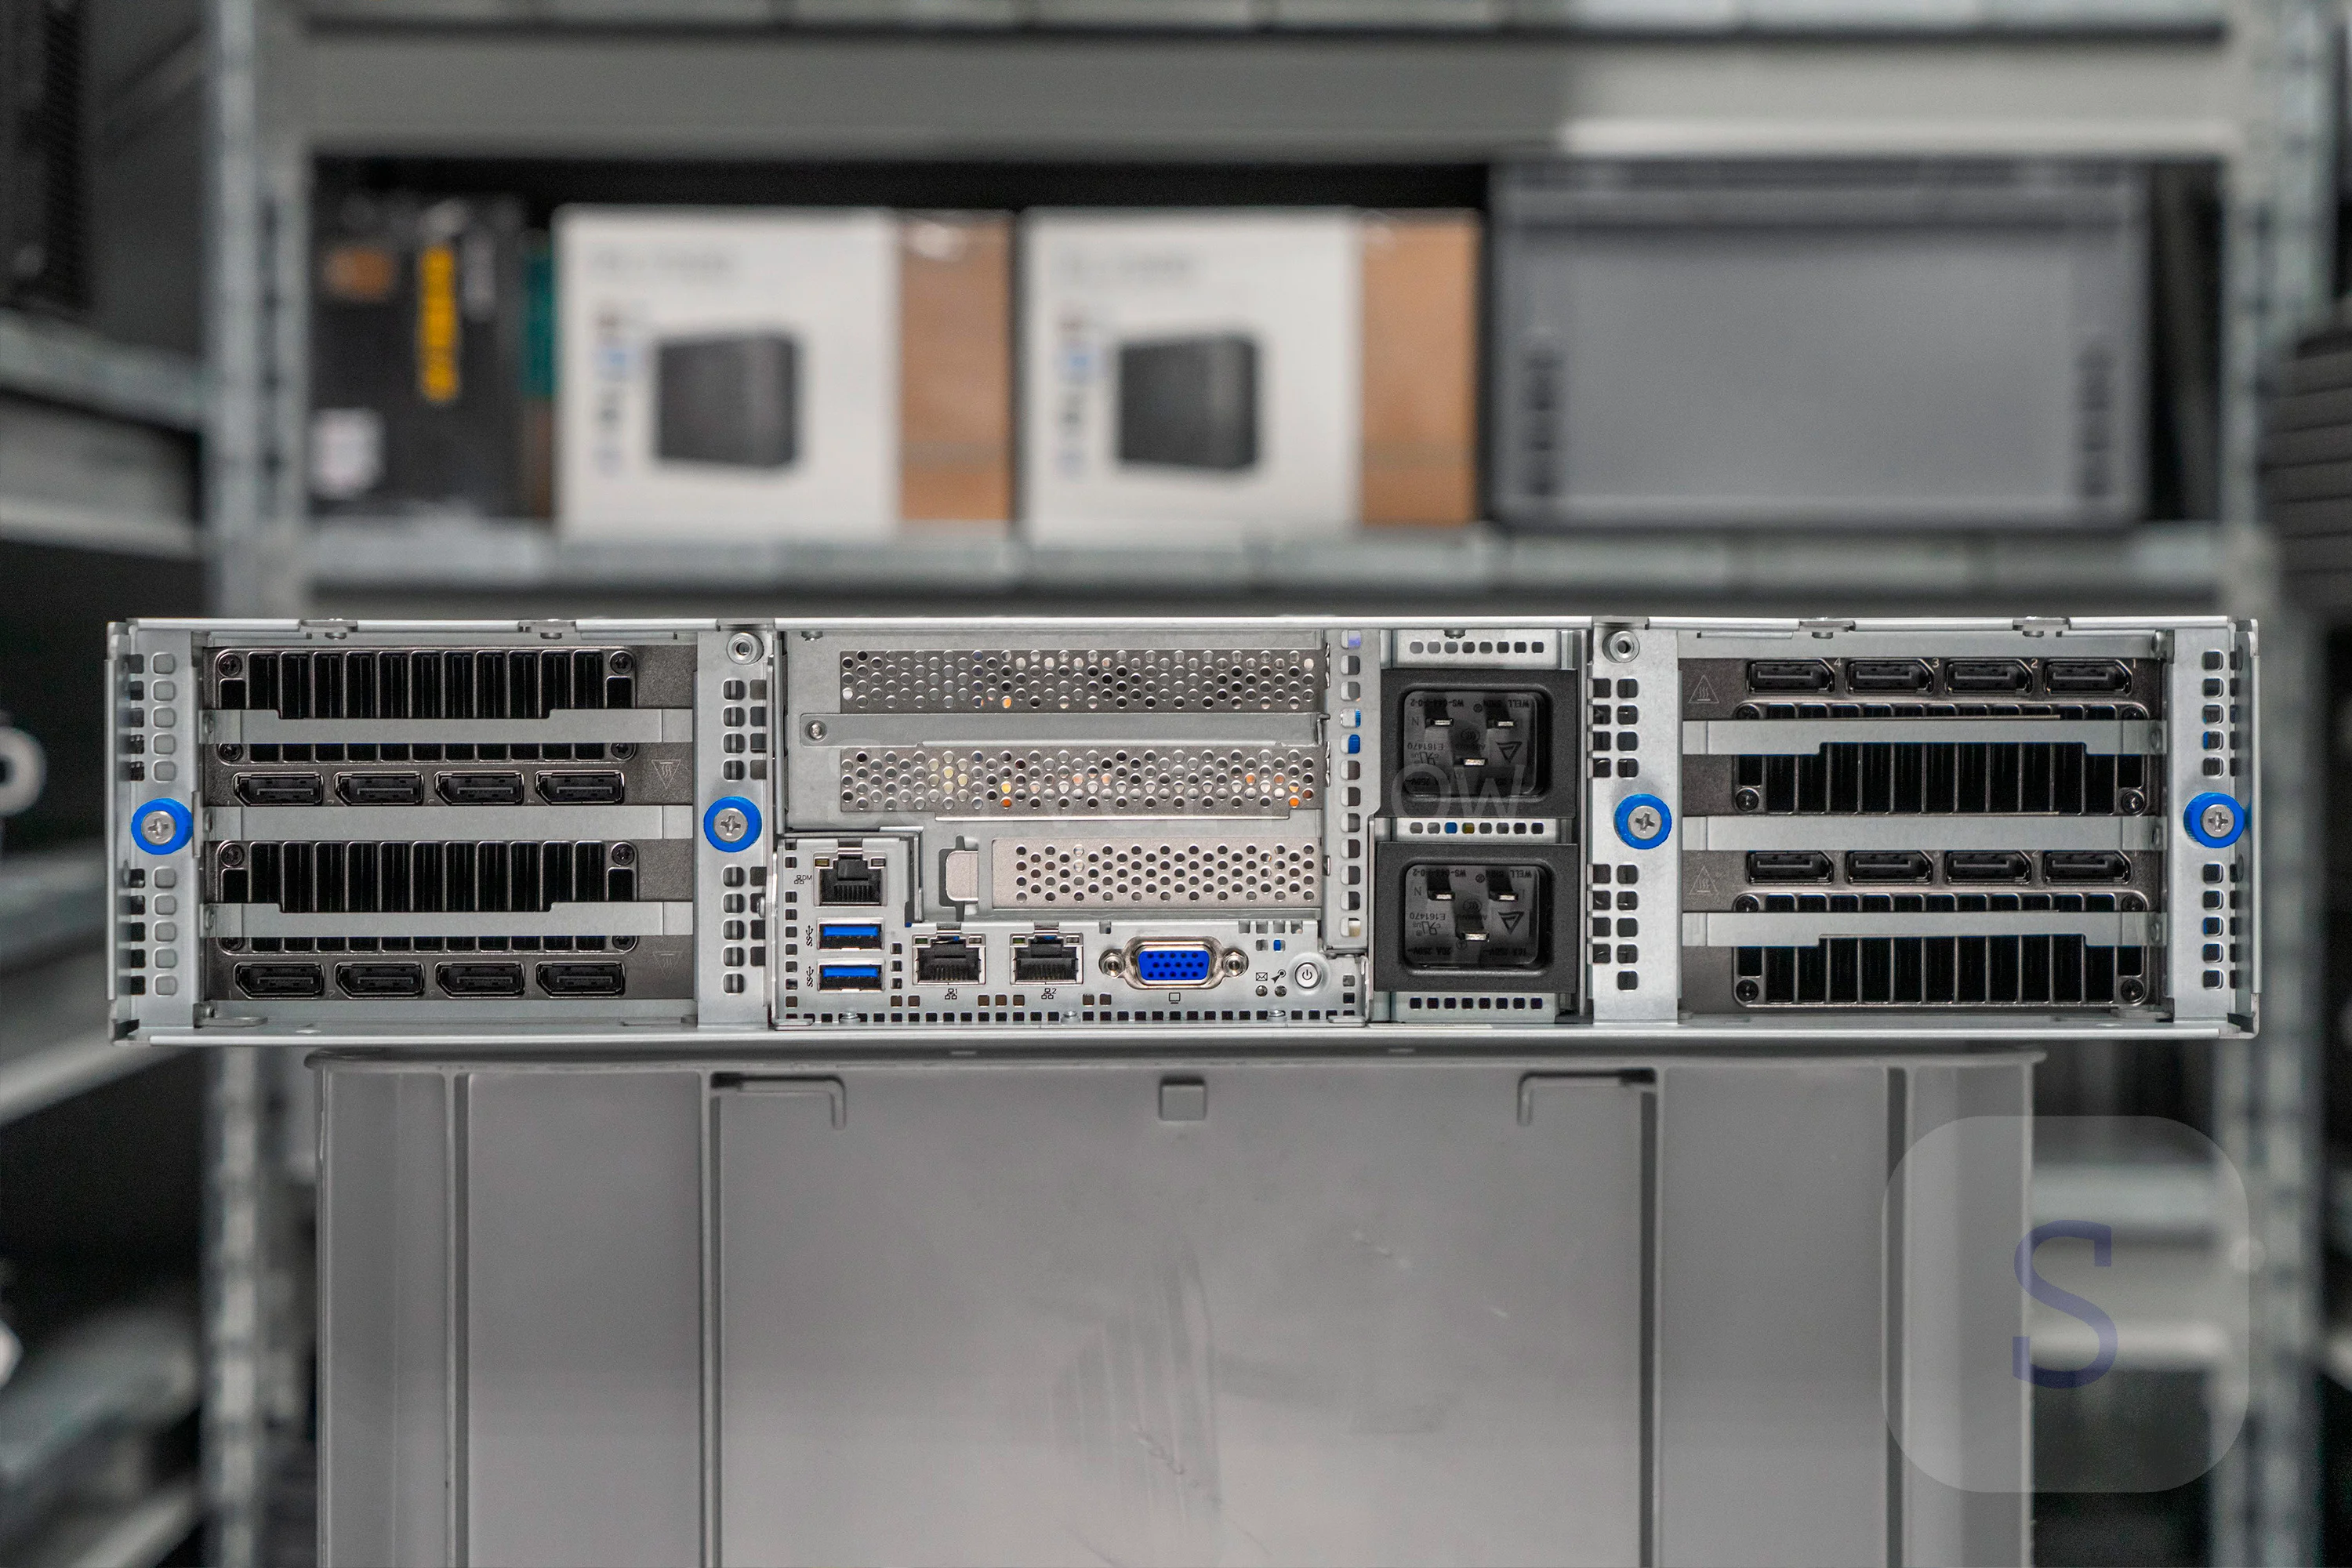
Ключевое достоинство ASUS ESC4000A-E12 - возможность установить четыре двухслотовые видеокарты в компактное 2U-шасси. Они располагаются по две на каждой из двух riser-плат и получают полноценные подключения PCIe 5.0 x16. При таком расположении все четыре ускорителя можно использовать одновременно для распределённого инференса одной большой модели.
Особенность компоновки сервера - блоки питания вынесены в переднюю часть корпуса. В центральной зоне располагаются процессор, оперативная память и системные компоненты, а по бокам размещены видеокарты. Такое разделение помогает организовать отдельные воздушные потоки для CPU и GPU и использовать ограниченное пространство 2U-корпуса максимально эффективно.
За охлаждение отвечают высокооборотные серверные вентиляторы и направляющий воздуховод процессора. Отдельные боковые блоки вентиляторов подают воздух к видеокартам, а центральная группа охлаждает процессор, память и компоненты материнской платы. Для обслуживания предусмотрена система удалённого управления BMC, позволяющая контролировать состояние оборудования и выполнять операции без физического доступа к серверу.
Процессор AMD EPYC 9374F с 32 ядрами и 64 потоками обеспечивает вычислительный запас для подготовки данных и серверных процессов. Восемь модулей Samsung DDR5-4800 ECC REG формируют 128 ГБ оперативной памяти. Для операционной системы и программного окружения выбран SSD Intel D5-P5530 на 960 ГБ с интерфейсом U.2.
Питание реализовано на двух блоках Gospower G1302-2600WNA мощностью 2600 Вт каждый. Они работают по схеме 1+1: второй блок резервирует первый, а не увеличивает доступную мощность до 5200 Вт. Такая архитектура важна для серверного применения, где необходимо сохранить работоспособность системы при отказе одного источника питания.
Проверка охлаждения и энергопотребления
После сборки мы проверили сервер в Windows Server с использованием OCCT Power, а затем отдельно нагрузили видеокарты в Ubuntu при помощи GPU-BURN. Это позволило оценить как работу всей системы, так и охлаждение четырёх GPU под одинаковой вычислительной нагрузкой.
В OCCT Power все видеокарты не удалось стабильно вывести на максимальную нагрузку, поэтому результаты этого теста нельзя считать полным измерением предельного энергопотребления конфигурации. Тем не менее он показал различия в шуме и потреблении при автоматическом и максимальном управлении вентиляторами.
| Режим | Потребление из розетки | Уровень шума | Комментарий |
|---|---|---|---|
| Простой, автоматическое управление вентиляторами | 380 Вт | 75 дБ | Система без вычислительной нагрузки |
| OCCT Power, автоматический профиль | около 2000 Вт | 83 дБ | Не все четыре GPU были нагружены полностью |
| OCCT Power, максимальные обороты вентиляторов | около 2240 Вт | 85 дБ | Часть GPU также не достигла максимальной нагрузки |
Для более показательной оценки температур видеокарт мы запустили GPU-BURN в Ubuntu и выдержали нагрузку в течение 30 минут. В этом тесте ускорители работали с потреблением до 300 Вт каждый. Самая горячая видеокарта достигла 78 °C, при этом карты, расположенные в менее благоприятных зонах воздушного потока, оказались примерно на 7 °C горячее остальных.
Таким образом, сборка показала, что в одном 2U-корпусе можно разместить и охлаждать четыре профессиональных GPU под длительной нагрузкой. При этом стоит учитывать типичный для высокоплотных серверов акустический компромисс: такая система ориентирована прежде всего на серверную стойку, а не на размещение рядом с рабочим местом.
Локальный запуск DeepSeek V4-Flash-0731
Основным практическим сценарием стал запуск DeepSeek V4-Flash-0731 на четырёх RTX PRO 5000 Blackwell. Большой совокупный объём VRAM нужен не только для размещения весов модели, но и для обработки длинного контекста и обслуживания нескольких запросов одновременно. При распределении модели используются ресурсы четырёх независимых видеокарт, а не единый физический пул памяти.
Мы сравнили базовый запуск через vLLM, оптимизированную версию движка и вариант со спекулятивным декодированием. На одном запросе базовый vLLM показал 93,4 выходного токена/с, оптимизированная сборка r27 без DSpark - 114,6 токена/с, а r27 с DSpark K5 - 406,6 токена/с. Ниже приведены подробные результаты этих испытаний, тестов параллельной нагрузки и длинного контекста.
Производительность DeepSeek V4-Flash-0731: один запрос
В первую очередь мы сравнили скорость генерации одного ответа при трёх вариантах запуска. Обычный vLLM без спекулятивного декодирования показал 93,4 выходного токена/с. В оптимизированной сборке r27 без DSpark скорость выросла до 114,6 токена/с. С включённым DSpark K5 на r27 мы получили 406,6 токена/с - примерно в 4,35 раза быстрее базового vLLM и в 3,55 раза быстрее r27 без DSpark в представленном тесте.
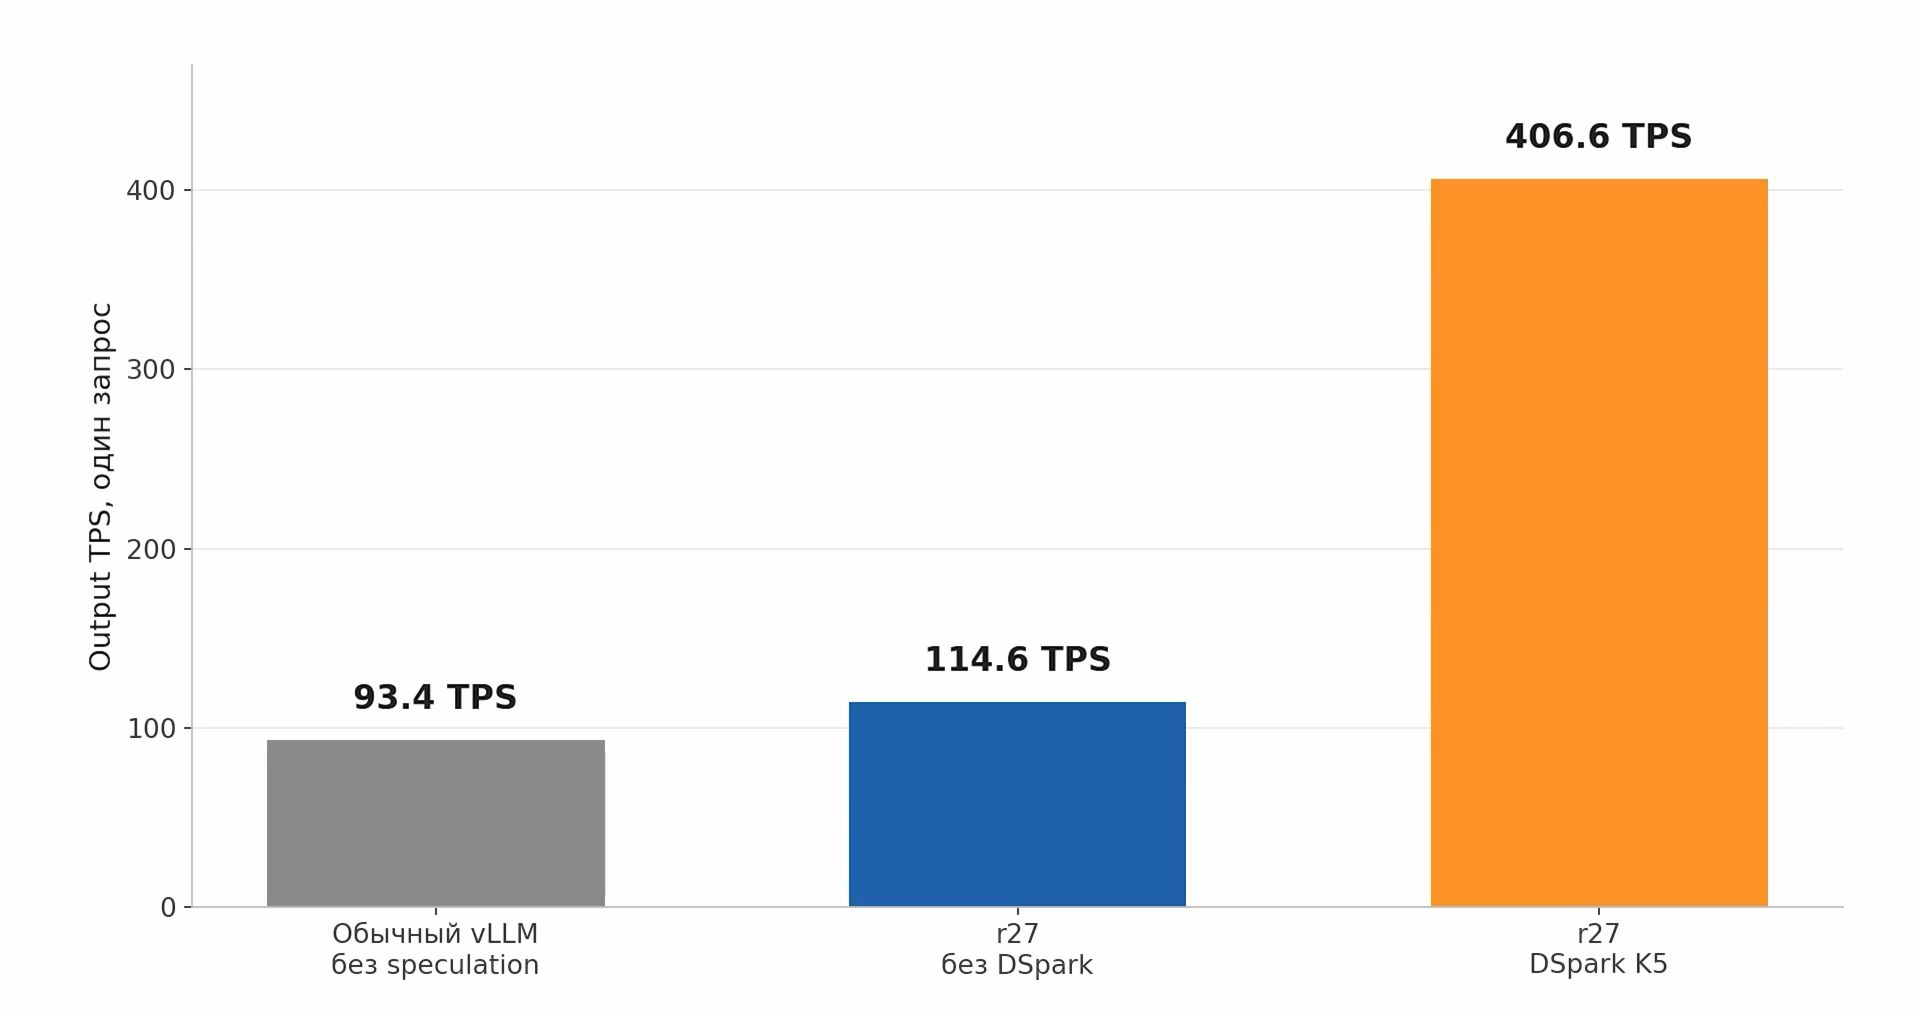
График 1. Скорость генерации одного ответа в разных режимах работы движка. TPS - количество выходных токенов в секунду.
Параллельные запросы: скорость и задержка ответа
Следующий этап - проверка работы нескольких клиентов одновременно. Мы сравнили настройки MAX_NUM_SEQS=8 и MAX_NUM_SEQS=128, изменяя количество одновременных запросов. Чем выше нагрузка, тем больше суммарное число генерируемых токенов, но тем важнее учитывать скорость отдельного ответа и задержку до первого токена.
| MAX_NUM_SEQS | Одновременные запросы | Общий TPS | TPS на запрос | TTFT p50, с | E2E p95, с |
|---|---|---|---|---|---|
| 8 | 1 | 406,56 | 406,56 | 0,149 | 1,322 |
| 8 | 16 | 1 471,98 | 92,00 | 2,928 | 6,012 |
| 128 | 32 | 2 740,83 | 85,65 | 0,601 | 7,489 |
| 128 | 64 | 3 340,55 | 52,20 | 0,807 | 12,732 |
| 128 | 96 | 3 521,05 | 36,68 | 1,123 | 18,718 |
При 96 одновременных запросах суммарная производительность достигла 3 521,05 выходного токена/с. Медианное время до первого токена при этом составило 1,123 секунды, а 95-й перцентиль полного времени ответа - 18,718 секунды. Эти цифры показывают пропускную способность всей системы, а не скорость каждого пользователя по отдельности: средний показатель на один запрос в указанном режиме - 36,68 токена/с.
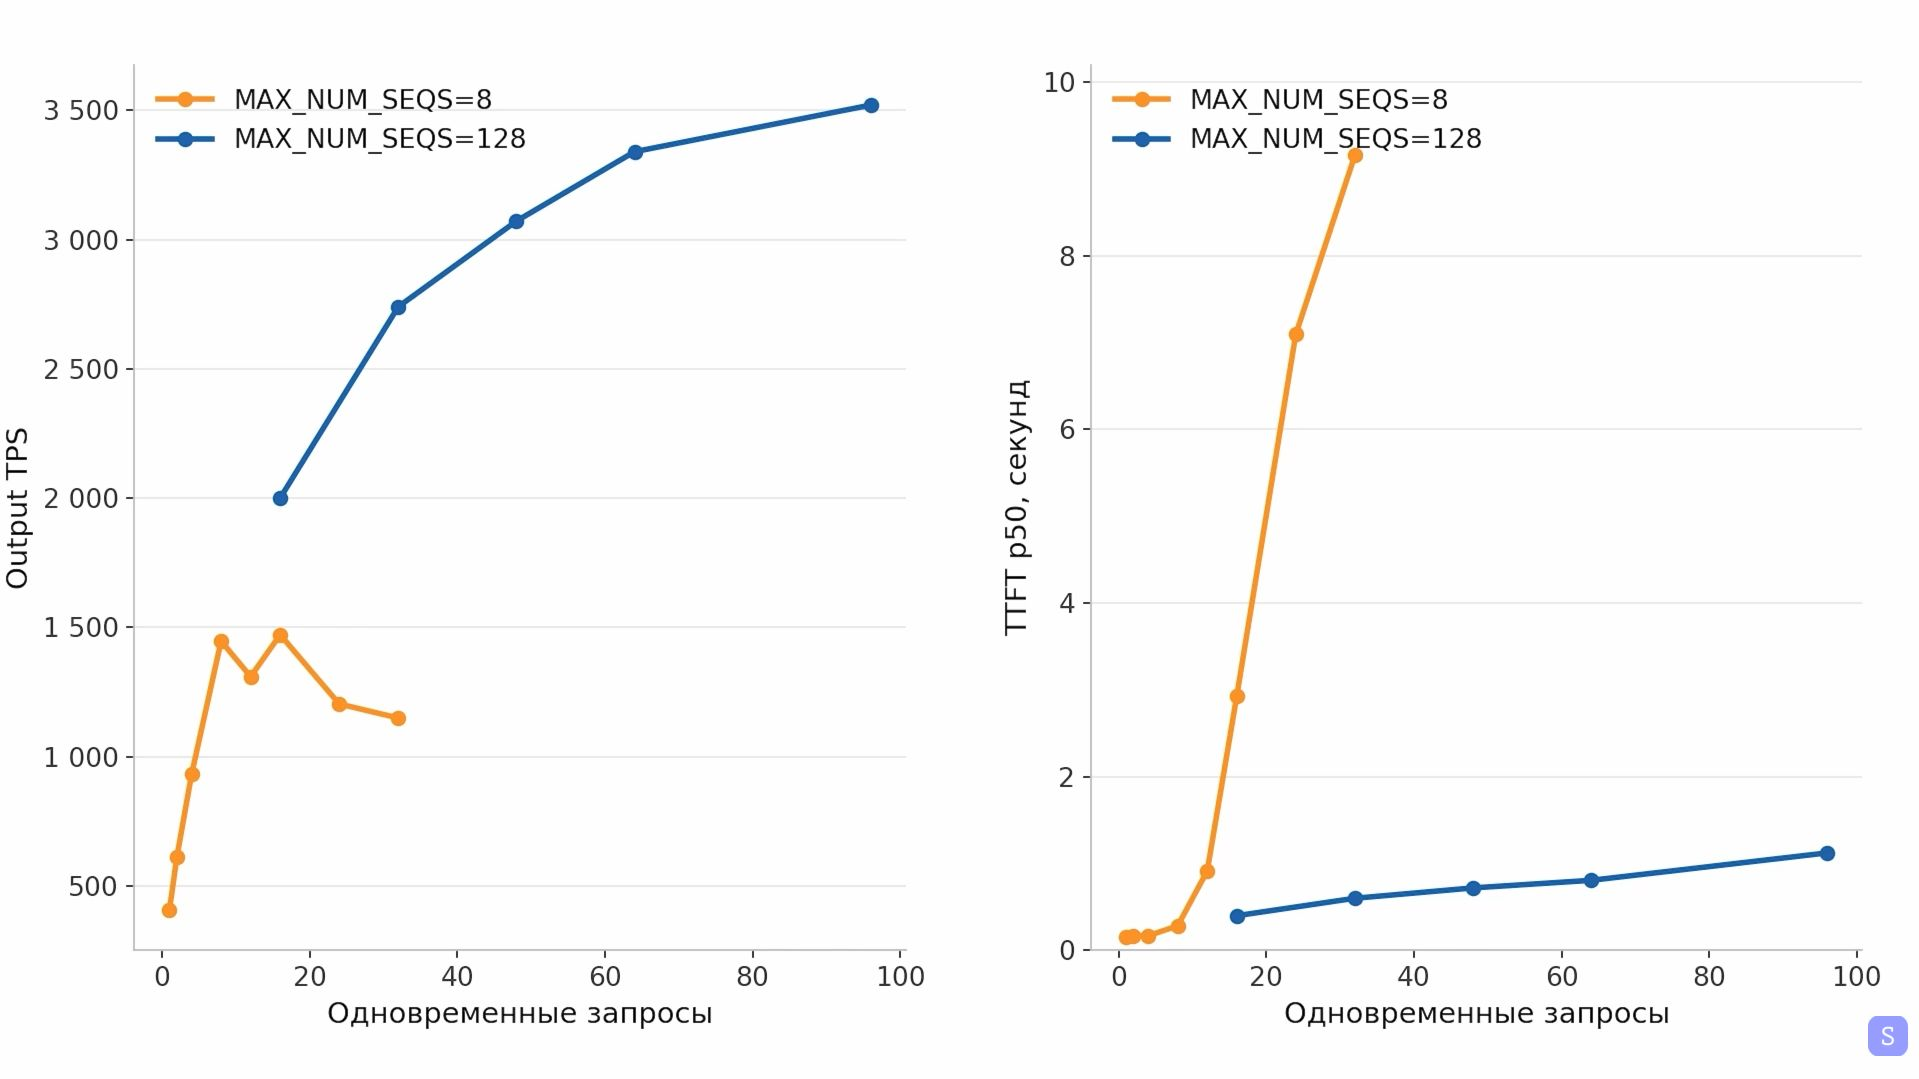
График 2. Влияние количества одновременных запросов на суммарный Output TPS и TTFT p50. TTFT - время до первого токена, E2E - полное время обработки запроса.
Длинный контекст: до 190 тысяч входных токенов
Отдельно проверили влияние длины входного контекста на задержку ответа и скорость последующей генерации. При увеличении объёма входа с 8K до 190K токенов время до первого токена выросло с 0,7 до 21,5 секунды. При этом скорость декодирования уменьшилась с 415 до 349 выходных токенов/с - примерно на 16%.
| Размер входного контекста | TTFT, с | Decode TPS |
|---|---|---|
| 8K | 0,7 | 415 |
| 32K | 2,8 | 396 |
| 65K | 5,9 | 384 |
| 131K | 13,4 | 371 |
| 190K | 21,5 | 349 |
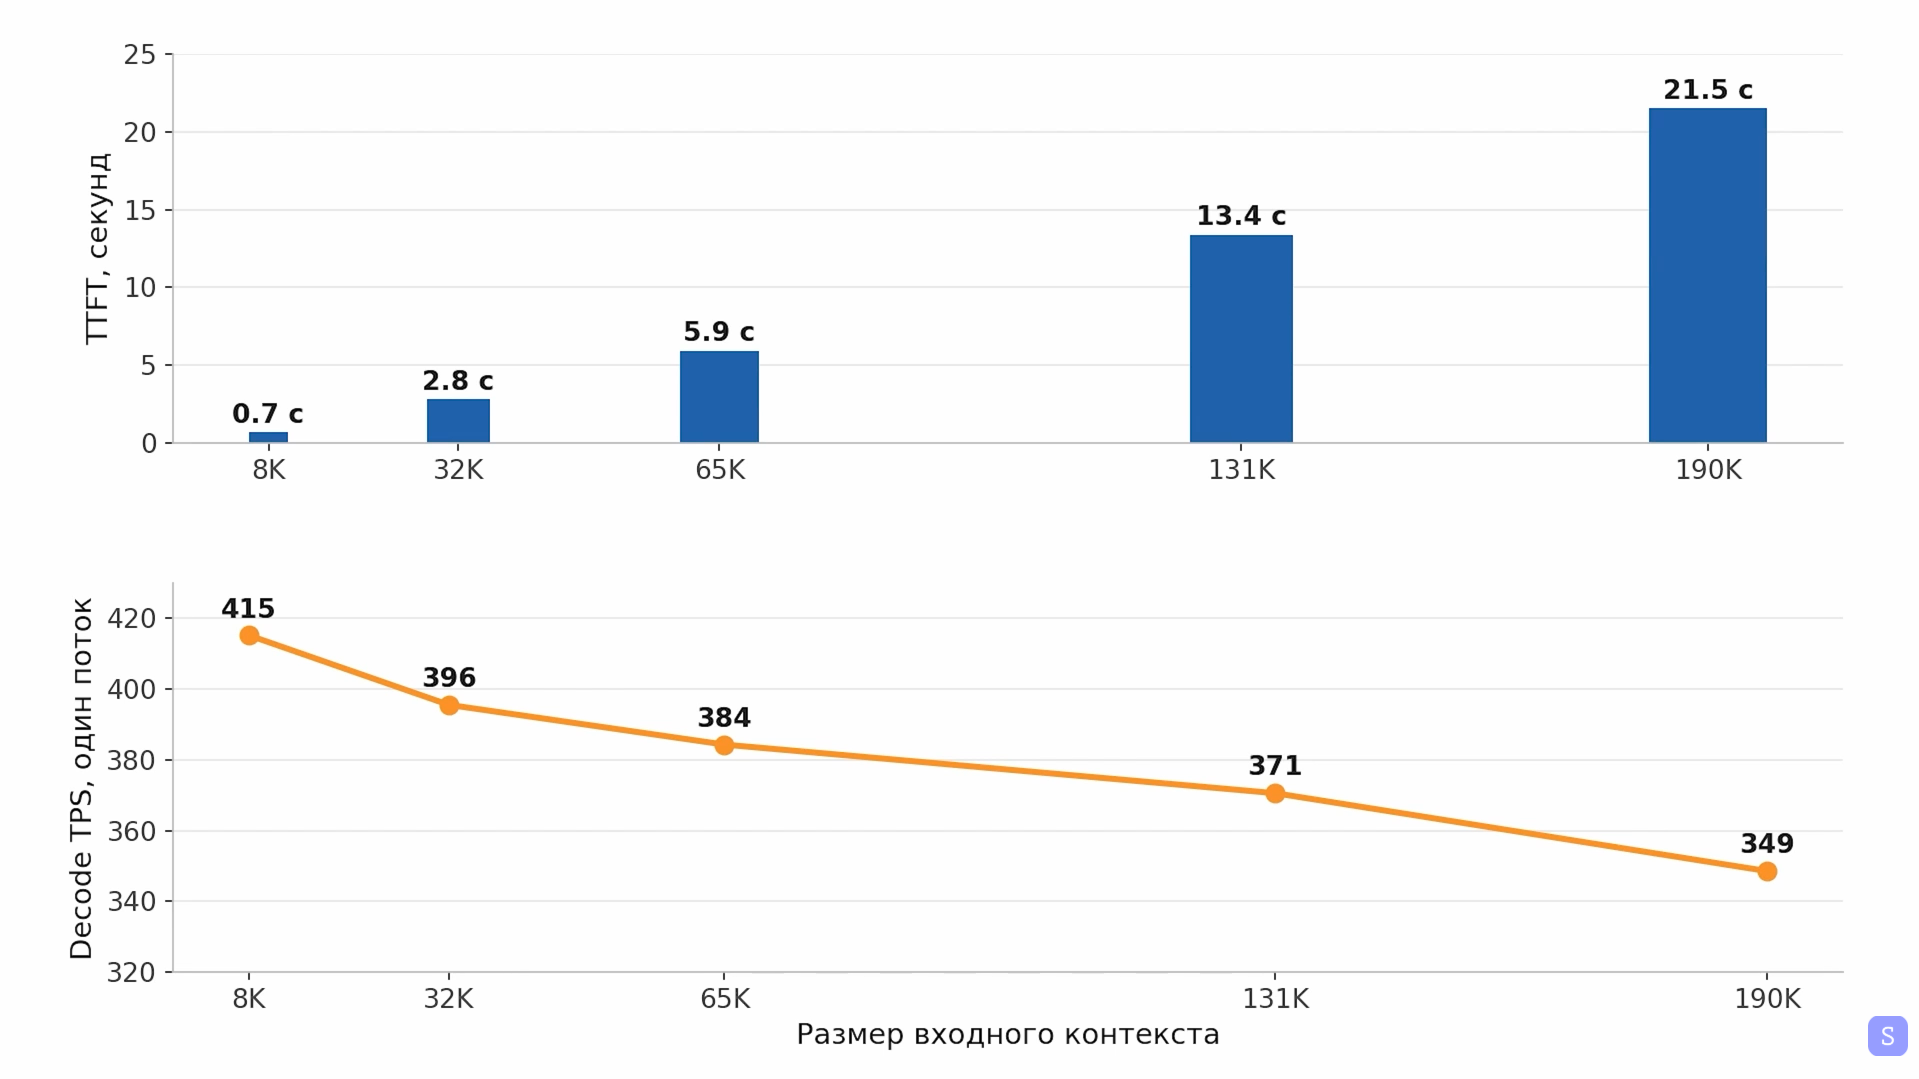
График 3. Влияние длины входного контекста на TTFT и скорость декодирования. Эти результаты относятся к отдельному тесту длинного контекста и не должны напрямую сопоставляться с тестом большого числа параллельных запросов.
Таким образом, измерения показали три разных свойства конфигурации: ускорение отдельного ответа при использовании DSpark, высокую суммарную производительность при параллельной нагрузке и возможность обработки длинных входных последовательностей. Для оценки конкретного сценария важно учитывать не только максимальный TPS, но и задержку первого токена, число пользователей и длину запроса.
Отдельно мы проверили DeepSeek в прикладных задачах. В одном эксперименте модель анализировала исполняемый файл GTA: San Andreas и пыталась восстановить на C++ логику внутриигровой камеры. Полученную реализацию удалось собрать и запустить в игре, однако при сложных движениях камеры сохранялись расхождения с оригиналом. Такой тест показал не только возможности модели по работе с кодом, но и пределы автоматического реверс-инжиниринга без дополнительной проверки.
Во втором сценарии DeepSeek использовали для создания офлайн-приложения DocLens под Android. Модель подготовила работающее приложение для обработки фотографий документов: обнаружения границ, коррекции изображения и распознавания текста. Это продемонстрировало возможность применения локальной LLM для практических задач разработки, когда модель не просто отвечает на вопросы, а работает с проектом и программным окружением.
Результат
В результате команда ServerFlow собрала и испытала высокоплотный GPU-сервер на базе ASUS ESC4000A-E12 и четырёх NVIDIA RTX PRO 5000 Blackwell 72GB. Система располагает 288 ГБ совокупной видеопамяти и позволяет разворачивать крупные языковые модели локально, без обязательного обращения к облачным GPU.
Испытания подтвердили возможность длительной нагрузки четырёх ускорителей в корпусе 2U, а тесты DeepSeek V4-Flash-0731 показали производительность при одиночной генерации, длинных входных запросах и параллельном обслуживании пользователей. Дополнительно модель проверили в задачах анализа кода и разработки Android-приложения.
Такую платформу можно использовать для локального инференса LLM, корпоративных AI-сервисов, обработки конфиденциальных документов и задач, в которых важны большой объём VRAM, плотное размещение GPU и централизованное серверное управление.
ServerFlow может не только собрать подобный сервер, но и подготовить его к работе с конкретной нейросетью: подобрать модель, установить операционную систему, развернуть движок инференса и настроить программное окружение под задачи заказчика.
Видео сборки и тестирования
Подробный обзор аппаратной платформы, процесс сборки, замеры охлаждения и тестирование DeepSeek V4-Flash-0731 показаны в нашем видео: .
Фотографии
Подобный GPU-сервер можно заказать в ServerFlow. На нашем сайте доступен конфигуратор платформы ASUS ESC4000A-E12, где можно подобрать комплектацию под нужную нейросеть, требования к видеопамяти и вычислительной производительности. При необходимости мы подготовим систему к работе с вашим программным обеспечением.