Кэш процессора: зачем он нужен и как устроен
Введение
Кэш процессора: как устроена память, которая скрывает медлительность оперативной памяти
Современный процессор способен выполнять миллиарды операций в секунду, но толку от этой скорости немного, если каждое обращение к оперативной памяти занимает в сотни раз больше времени, чем один такт ядра. Именно для решения этой проблемы придумали кэш – небольшую, но очень быструю память, расположенную прямо на кристалле процессора или максимально близко к нему.
Проблема разрыва скоростей
С конца 1980-х годов частота процессоров росла заметно быстрее, чем скорость доступа к оперативной памяти. Ядро, готовое обрабатывать данные каждый такт, вынуждено было простаивать десятки и сотни тактов, ожидая ответа от ОЗУ. Это явление называют “стеной памяти” – ситуацией, когда узким местом системы становится не вычислительная мощность, а скорость доставки данных.
Кэш стал промежуточным буфером между ядром и основной памятью: он хранит копии тех данных и команд, к которым процессор недавно обращался или, вероятно, обратится в ближайшее время. Если нужные данные уже лежат в кэше, ядро получает их почти мгновенно, не дожидаясь ответа от ОЗУ.
Физическое устройство кэша
Кэш строится на статической памяти (SRAM), а не на динамической (DRAM), из которой сделана обычная оперативная память. Ячейка SRAM хранит бит информации на нескольких транзисторах без необходимости постоянного обновления заряда, что делает такую память гораздо быстрее, но и заметно дороже в пересчёте на один мегабайт. Именно поэтому объём кэша всегда на порядки меньше объёма оперативной памяти.
Данные в кэше хранятся не отдельными байтами, а блоками фиксированного размера – строками кэша. Типичный размер такой строки в современных процессорах составляет 64 байта. Когда процессору требуется хотя бы один байт из ОЗУ, в кэш загружается сразу вся строка, к которой этот байт принадлежит – это ускоряет последующие обращения к соседним данным.
Почему это работает: принцип локальности
В основе всей идеи кэширования лежит наблюдение за поведением реальных программ: обращения к памяти не случайны, а подчиняются двум закономерностям.
Временная локальность означает, что если программа обратилась к какой-то ячейке памяти, велика вероятность, что она обратится к ней снова в ближайшее время – например, при выполнении цикла. Пространственная локальность говорит о том, что если программа обратилась к одному адресу, скорее всего, она вскоре обратится и к соседним адресам – так происходит при последовательном переборе массива. Благодаря этим двум свойствам загрузка целой строки кэша, а не одного байта, действительно ускоряет работу программы, а не тратит пропускную способность впустую.
Иерархия уровней: L1, L2, L3
Кэш современного процессора не единый блок, а несколько уровней, различающихся объёмом, скоростью и расположением.
Кэш первого уровня (L1) находится максимально близко к исполнительным блокам ядра и является самым быстрым уровнем кэш-памяти. В современных процессорах его объём обычно составляет десятки или сотни килобайт на ядро, а задержка доступа измеряется всего несколькими тактами. L1 чаще всего разделён на кэш инструкций и кэш данных, что позволяет одновременно получать команды и работать с данными. L1 обычно разделён на две части – кэш данных и кэш инструкций, что позволяет процессору одновременно читать команду и данные, не создавая друг другу помех.
Кэш второго уровня (L2) значительно крупнее L1 и обычно имеет объём от сотен килобайт до нескольких мегабайт. В большинстве современных производительных ядер L2 является собственным для каждого ядра, однако существуют архитектуры, где несколько ядер разделяют общий L2. По скорости он занимает промежуточное положение между L1 и кэшем последнего уровня.
Кэш третьего уровня (L3) – общий для всех ядер процессора. Его объём в потребительских чипах достигает 32–64 мегабайт, а в серверных моделях – куда больше, при задержке доступа порядка 30–70 тактов. Общий доступ к L3 позволяет ядрам обмениваться данными, не обращаясь к оперативной памяти напрямую.
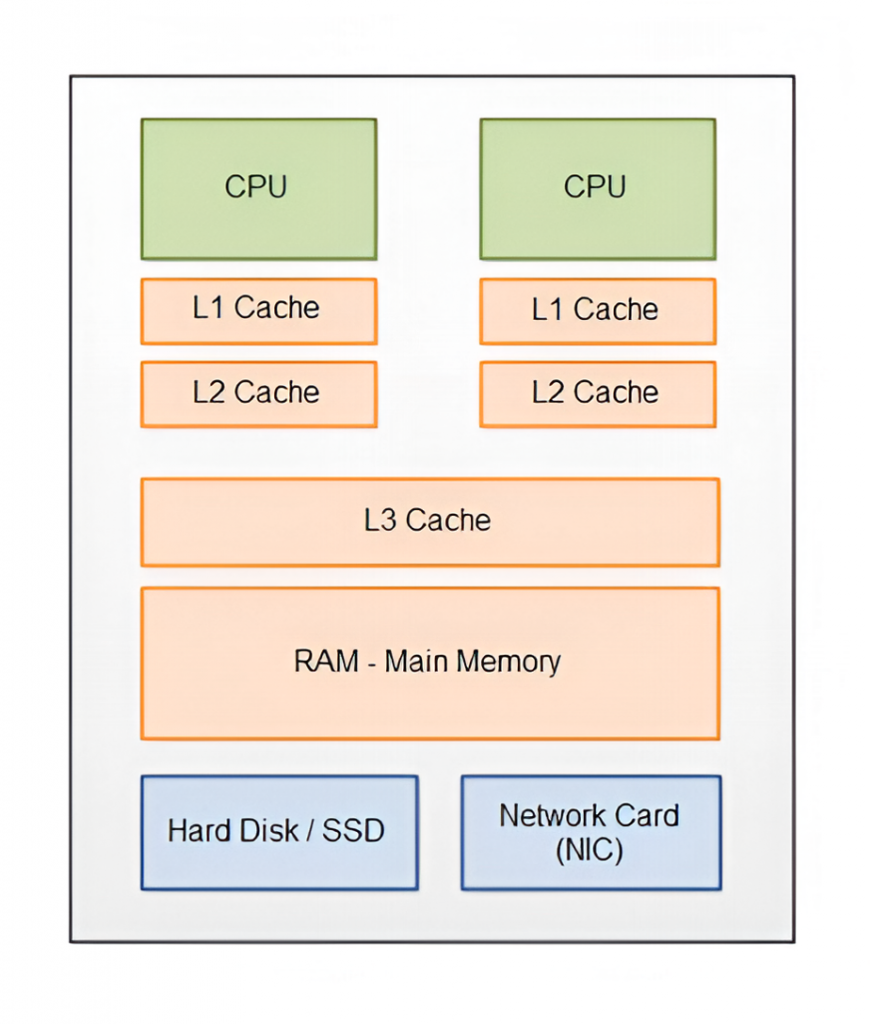
Схема иерархии кэша: у каждого процессорного ядра – собственные L1 и L2, а общий L3 обслуживает все ядра сразу, прежде чем запрос уходит в оперативную память. Источник:
Путь запроса: попадание и промах
Когда ядру нужны данные, оно сначала проверяет L1. Если данные там есть – это называется попаданием (hit), и запрос выполняется почти мгновенно. Если данных нет, происходит промах (miss), и запрос уходит на следующий уровень – в L2, затем в L3, и только в самом худшем случае – в оперативную память.
Каждый промах кэша стоит процессору драгоценных тактов простоя, поэтому разработчики компиляторов и алгоритмов стараются писать код так, чтобы обращения к памяти были предсказуемыми и последовательными – это повышает долю попаданий и напрямую влияет на реальную скорость программы.
Как устроена организация кэша
Чтобы кэш работал эффективно, важно не только, где хранить данные, но и как их искать и чем жертвовать при нехватке места.
Ассоциативность определяет, в какое место кэша может попасть конкретная строка данных. При прямом отображении каждому адресу соответствует ровно одна ячейка кэша, что просто в реализации, но приводит к частым конфликтам. Полностью ассоциативная организация позволяет разместить строку в любом свободном месте, что снижает число конфликтов, но усложняет и удорожает поиск. Компромиссом стала множественно-ассоциативная организация, где кэш делится на группы (наборы), а строка может занять любое место внутри своей группы
.
Когда кэш заполнен и нужно освободить место под новые данные, применяется алгоритм вытеснения. Самый распространённый – LRU (Least Recently Used), при котором вытесняется строка, которая дольше всех не использовалась. Такой подход опирается на ту же временную локальность и статистически даёт лучший результат, чем случайный выбор.
Отдельный вопрос – политика записи. При сквозной записи (write-through) каждое изменение данных в кэше сразу дублируется в оперативной памяти, что просто, но медленно. При обратной записи (write-back) изменения сохраняются только в кэше и переносятся в память лишь при вытеснении строки, что значительно быстрее, но требует дополнительного механизма отслеживания “грязных” (изменённых) строк.
Согласованность кэшей в многоядерных процессорах
Когда у процессора несколько ядер, у каждого из них свой L1 и L2, но данные из одного и того же участка памяти могут одновременно лежать в кэшах разных ядер. Если одно ядро изменит эти данные в своём кэше, а другое продолжит читать устаревшую копию, программа начнёт работать неправильно.
Для решения этой проблемы используется протокол когерентности кэшей, самый известный из которых – MESI. Название складывается из первых букв четырёх состояний, в которых может находиться строка кэша: изменённая (Modified) – данные обновлены только в этом кэше; эксклюзивная (Exclusive) – данные совпадают с памятью и есть только здесь; разделяемая (Shared) – копия есть в нескольких кэшах одновременно; недействительная (Invalid) – данные устарели и должны быть перечитаны. Когда одно ядро получает право изменить строку, соответствующие копии в других кэшах могут быть переведены в недействительное состояние. Если другому ядру позже понадобятся эти данные, актуальная строка будет получена через механизм когерентности - например, из другого кэша или, при необходимости, из более низкого уровня памяти.
3D-кэш: вертикальное решение проблемы объёма
Долгое время увеличить объём кэша можно было только одним способом – расширить площадь кристалла, отведённую под SRAM. Но площадь кристалла ограничена и стоит дорого, а перегружать её кэшем в ущерб вычислительным блокам невыгодно. Ответом на эту проблему стала технология трёхмерного кэша, при которой дополнительный слой памяти размещается не рядом с ядром, а прямо над ним.
Практическую реализацию этого подхода первой массово применила компания AMD в технологии 3D V-Cache. Поверх обычного вычислительного кристалла процессора устанавливается отдельный кристалл, целиком состоящий из SRAM – фактически дополнительный слой L3. Соединение между двумя кристаллами происходит через сквозные кремниевые переходы (TSV, Through-Silicon Vias) – тончайшие вертикальные проводники, которые пронизывают кремний насквозь и обеспечивают прямой контакт медь-к-меди без использования припоя. Такая связь получается на порядок быстрее и энергоэффективнее, чем если бы дополнительная память располагалась рядом на подложке.
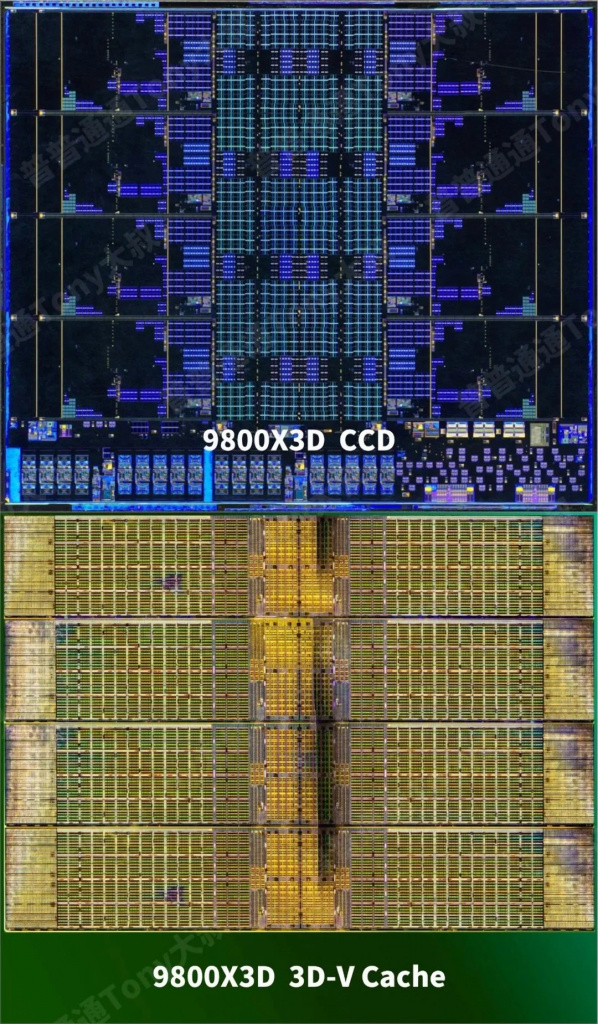
Снимок кристалла процессора AMD Ryzen 9800X3D под микроскопом: верхний слой – вычислительные ядра (CCD), нижний, с золотистыми контактами – стек 3D V-Cache. Источник:
Практический выигрыш от такого решения – резкое увеличение объёма L3 без увеличения площади самого вычислительного кристалла: дополнительный слой SRAM способен добавить порядка 64 мегабайт к уже имеющемуся кэшу. Обратная сторона технологии – рост тепловыделения на единицу площади, ведь под слоем памяти оказывается менее удобный путь для отвода тепла от ядер, а также более сложный и дорогой процесс производства, требующий точного совмещения кристаллов.
Насколько объём кэша влияет на реальную работу
Прирост производительности от увеличенного кэша заметен далеко не всегда одинаково – он сильно зависит от характера нагрузки. В играх, где движок держит в памяти большие и часто пересчитываемые структуры данных (например, объекты игрового мира), увеличенный L3 способен дать ощутимый прирост частоты кадров, потому что снижает число обращений к куда более медленной оперативной памяти. При компиляции больших проектов и в задачах с крупными наборами данных для работы нейросетевых моделей объём кэша также напрямую сказывается на скорости, поскольку сокращает количество промахов при обходе больших массивов весов или объектных файлов.
При этом многие повседневные нагрузки - офисные приложения, веб-браузинг или простые скрипты – часто получают гораздо меньший прирост от очень большого L3, чем игры или специализированные вычислительные задачи. Это не означает, что весь их рабочий набор помещается в L1 или L2: он может быть значительно больше. Просто производительность таких приложений часто ограничивается другими факторами, поэтому дополнительная ёмкость L3 не всегда даёт заметное ускорение.
Заключение: Куда движется технология
Кэш остаётся одним из главных инструментов борьбы с разрывом скоростей между процессором и памятью, и производители продолжают искать способы нарастить его объём без увеличения площади кристалла. После успеха 3D V-Cache в L3 инженеры AMD уже прорабатывают возможность подобного вертикального наложения и для кэша второго уровня , а конкуренты изучают собственные варианты трёхмерной упаковки чипов. По мере замедления роста тактовых частот совершенствование иерархии памяти, увеличение объёма кэша и развитие трёхмерной упаковки становятся одними из важных способов повысить производительность процессоров без простого увеличения частоты или радикальной смены микроархитектуры.
