Intel oneAPI: конкурент ли CUDA и ROCm?
Введение
Индустрия ускоренных вычислений много лет держится на трёх опорах: закрытой платформе NVIDIA CUDA, открытой, но привязанной к своему железу платформе AMD ROCm и относительно молодой инициативе Intel oneAPI. Формально все три решения позволяют программисту распределять задачи между процессором и графическим ускорителем, но задуманы они по-разному, и это различие определяет, насколько честно можно сравнивать oneAPI с двумя другими средами.
Проблема привязки к поставщику
Успех CUDA во многом объясняется не превосходством отдельных чипов, а глубиной программной экосистемы, выстроенной вокруг них за пятнадцать лет. Библиотеки, готовые модели, учебные материалы и инструменты профилирования написаны с оглядкой именно на архитектуру NVIDIA, поэтому переход на другое оборудование почти всегда требует переписывания критичных участков кода. Такая зависимость превратилась в устойчивое конкурентное преимущество и одновременно в источник беспокойства для крупных заказчиков – научных центров, облачных провайдеров и производителей серверов, которые не хотят зависеть от одного поставщика микросхем.
Компания AMD ответила на эту проблему платформой ROCm, но пошла тем же путём: открыла исходный код инструментов, однако оставила программный стек рассчитанным преимущественно на собственные ускорители линеек Radeon и Instinct. HIP, основной язык ROCm, синтаксически напоминает CUDA и облегчает перенос кода, но остаётся отдельной, самостоятельной средой со своими ограничениями по поддерживаемым чипам и операционным системам.
Intel выбрала третий путь. Вместо создания ещё одной закрытой или полузакрытой экосистемы Intel предложила экосистему oneAPI, опирающуюся на открытые стандарты, прежде всего SYCL, разработанный Khronos Group, способный работать поверх оборудования разных производителей без переписывания исходного кода. Именно поэтому вопрос “конкурент ли oneAPI CUDA и ROCm?” не имеет однозначного ответа: сравнивать напрямую можно только отдельные компоненты, а не всю философию проекта.
Архитектура трёх платформ
В основе CUDA лежит собственный компилятор nvcc и набор расширений языка C, C++ и Fortran, дающих программисту прямой доступ к регистрам и памяти графического процессора NVIDIA. Такая близость к аппаратуре обеспечивает предсказуемую производительность, но исключает запуск того же кода на чипах других изготовителей без промежуточных слоёв трансляции.
ROCm устроен похоже: язык HIP компилируется в машинный код через собственный драйвер и интерфейс, ориентированный на архитектуру CDNA и RDNA. AMD также поддерживает трансляцию CUDA-кода в HIP через утилиту hipify, что снижает порог входа для разработчиков, привыкших к экосистеме конкурента, но итоговый результат всё равно исполняется в рамках закрытого именно под AMD стека.
Intel oneAPI строится вокруг открытого языка SYCL – надстройки над современным C++, разработанной консорциумом Khronos Group независимо от какого-либо производителя оборудования. Компилятор DPC++ поддерживает выполнение SYCL-программ на различных устройствах через соответствующие программные среды. Для графических ускорителей Intel преимущественно используется Level Zero, а для процессоров и других устройств могут применяться иные механизмы исполнения. Ключевая особенность в том, что тот же исходный код теоретически может исполняться и на чипах других производителей, если для них существует соответствующий модуль поддержки – это принципиально отличает подход Intel от закрытых сред NVIDIA и AMD.
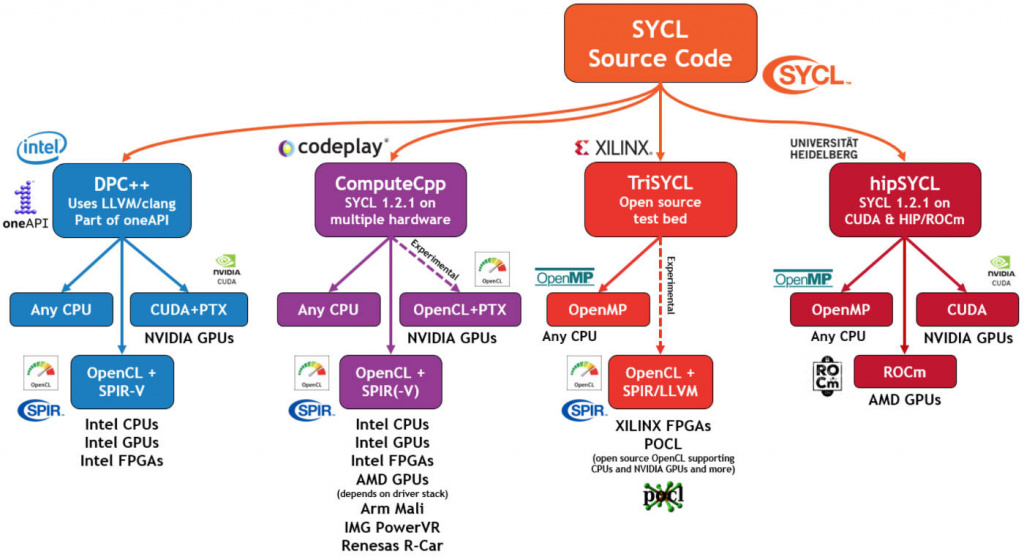
Схема экосистемы SYCL: единый исходный код может обрабатываться разными реализациями и направляться на процессоры, графические процессоры и ПЛИС нескольких поставщиков. Это наглядно раскрывает идею переносимости, лежащую в основе oneAPI. Источник: .
Стоит отдельно отметить, что уровень абстракции у трёх платформ различается принципиально. CUDA и HIP дают программисту почти прямой доступ к аппаратным блокам конкретного чипа: потоковым мультипроцессорам у NVIDIA или вычислительным блокам у AMD, что удобно для тонкой ручной оптимизации, но требует переписывания кода при смене поколения оборудования. SYCL изначально задумывался как более высокоуровневый язык, где параллелизм описывается через очереди задач и буферы данных, а конкретное распределение работы между вычислительными единицами берёт на себя компилятор и среда исполнения. Такой подход упрощает перенос кода между поколениями чипов, но оставляет меньше прямых рычагов управления для тех, кто привык выжимать из железа максимум ручными средствами.
Как oneAPI работает на чужом оборудовании
Практическая многоплатформенность oneAPI реализуется через отдельные модули расширения, часть которых разрабатывает компания Codeplay, специализирующаяся на компиляторах для гетерогенных систем. Эти модули добавляют в компилятор DPC++ способность генерировать код для видеоускорителей NVIDIA и AMD, используя их же низкоуровневые интерфейсы: программа на SYCL в итоге транслируется в вызовы, близкие к тем, что делает CUDA Driver API или интерфейс ROCr.
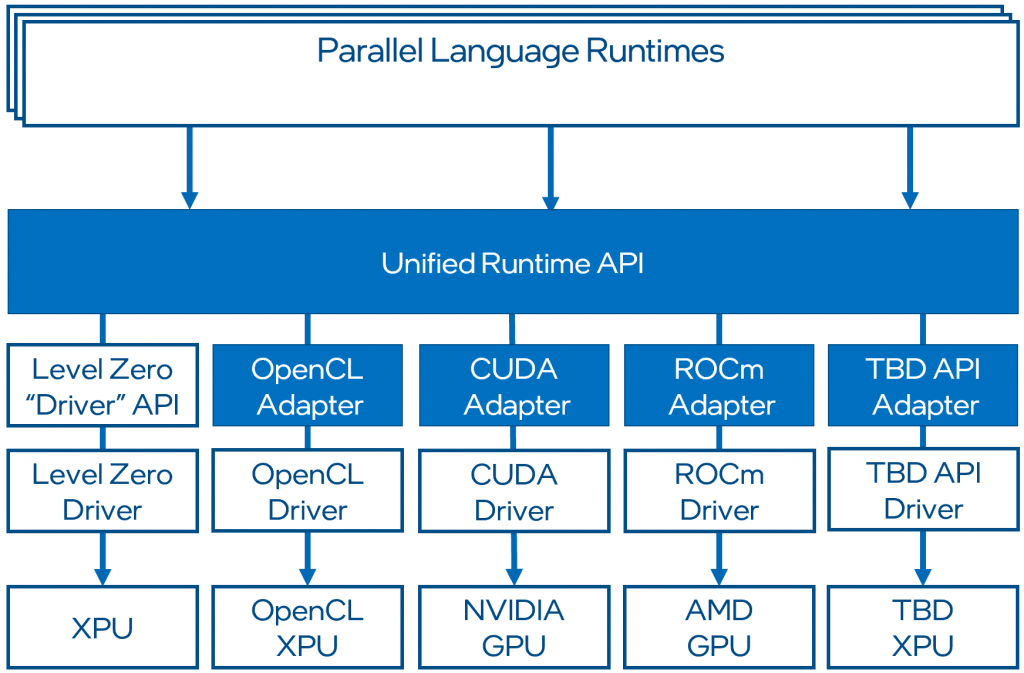
Архитектура Unified Runtime: общий программный интерфейс связывает среды параллельного программирования с адаптерами Level Zero, OpenCL, CUDA и ROCm, а через них – с оборудованием Intel, NVIDIA и AMD. Источник: документация .
Библиотеки верхнего уровня из состава oneAPI, такие как oneMath для линейной алгебры и oneDNN для операций глубокого обучения, устроены как диспетчеры: в зависимости от того, на каком оборудовании запущена программа, они перенаправляют вычисления либо в собственные реализации Intel, либо в библиотеки cuBLAS и rocBLAS соответствующих производителей. Формально это позволяет писать один код для трёх экосистем сразу, но накладывает дополнительный слой абстракции, который в некоторых сценариях сказывается на производительности по сравнению с нативным кодом CUDA или HIP.
Состояние экосистемы и практическое применение
Ключевой вопрос для инженера, выбирающего платформу под конкретную задачу, – не архитектурная чистота, а зрелость программной поддержки. Здесь разрыв между CUDA и двумя альтернативами остаётся заметным. Подавляющее большинство фреймворков машинного обучения, включая PyTorch и JAX, изначально проектировались с прицелом на CUDA, и хотя ROCm получила официальную поддержку в PyTorch, а для JAX доступен поддерживаемый AMD плагин. Intel также развивает встроенную поддержку своих GPU в PyTorch через интерфейс XPU. Однако доступность функций, оптимизация и совместимость продолжают зависеть от конкретного оборудования и версий программного обеспечения, глубина оптимизации и стабильность там заметно ниже.
ROCm за последние версии существенно нарастил совместимость с популярными библиотеками и де-факто занял позицию основной альтернативы CUDA в задачах обучения крупных языковых моделей, особенно на серверных ускорителях линейки Instinct. У oneAPI ситуация иная: платформа сильнее в задачах, где важна переносимость между процессором, интегрированной и дискретной графикой одного производителя, например при работе на ноутбуках и рабочих станциях с чипами Intel, но в сегменте крупных обучающих кластеров пока используется реже.
Отдельный практический нюанс касается инструментов квантования и подготовки моделей для локального запуска: экосистема GGUF не привязана к конкретному производителю ускорителей. Например, llama.cpp поддерживает различные вычислительные бэкенды, включая CPU, CUDA, HIP, Vulkan, Metal и SYCL. Последний используется преимущественно для графических ускорителей Intel, тогда как поддержка oneAPI там встречается заметно реже и обычно ограничивается официальными интегрированными и дискретными видеокартами Intel.
Роль фонда UXL и дальнейшие перспективы
Осознавая, что открытый стандарт нельзя развивать силами одной компании, Intel в 2023 году передала спецификацию oneAPI под управление независимого объединения Unified Acceleration Foundation, работающего под эгидой Linux Foundation. В состав фонда вошли, помимо Intel, такие участники, как Google, Arm, Samsung, Qualcomm и Fujitsu, что теоретически снимает с проекта репутацию “ещё одной корпоративной платформы” и приближает его к статусу отраслевого стандарта, сравнимого по амбициям с OpenGL или Vulkan в графике.
Возникновение UXL Foundation не отменяет главного ограничения: даже самый открытый стандарт не работает без реальной поддержки в готовых продуктах и без готовности сообщества переносить существующий код. Пока библиотеки oneMath и oneDNN получили лишь экспериментальную поддержку графических процессоров NVIDIA и AMD, а основной объём готового программного обеспечения для обучения нейросетей продолжает ориентироваться на CUDA как на фактический отраслевой стандарт де-факто.
Заключение
Говорить о oneAPI как о прямом конкуренте CUDA и ROCm в узком смысле не совсем корректно: это не альтернативная закрытая экосистема с собственным железом, а попытка построить надстройку над всеми тремя архитектурами одновременно. В этом смысле правильнее воспринимать oneAPI не как соперника отдельных производителей, а как инструмент снижения зависимости от любого одного из них.
Если цель разработчика – максимальная производительность на конкретном оборудовании здесь и сейчас, CUDA по-прежнему остаётся наиболее зрелым и предсказуемым выбором благодаря глубине оптимизации и объёму готовых решений. Если приоритет – открытость и постепенный уход от привязки к NVIDIA при сохранении высокой производительности на серверных ускорителях, разумной альтернативой выглядит ROCm. А oneAPI стоит рассматривать как долгосрочную инвестицию в переносимость кода: платформа пока не заменяет ни CUDA, ни ROCm в задачах промышленного масштаба, но закладывает основу для будущего, в котором выбор поставщика ускорителя не потребует переписывания программного кода с нуля.
