Huawei Atlas 350 — новый ответ Nvidia от Китая
Введение
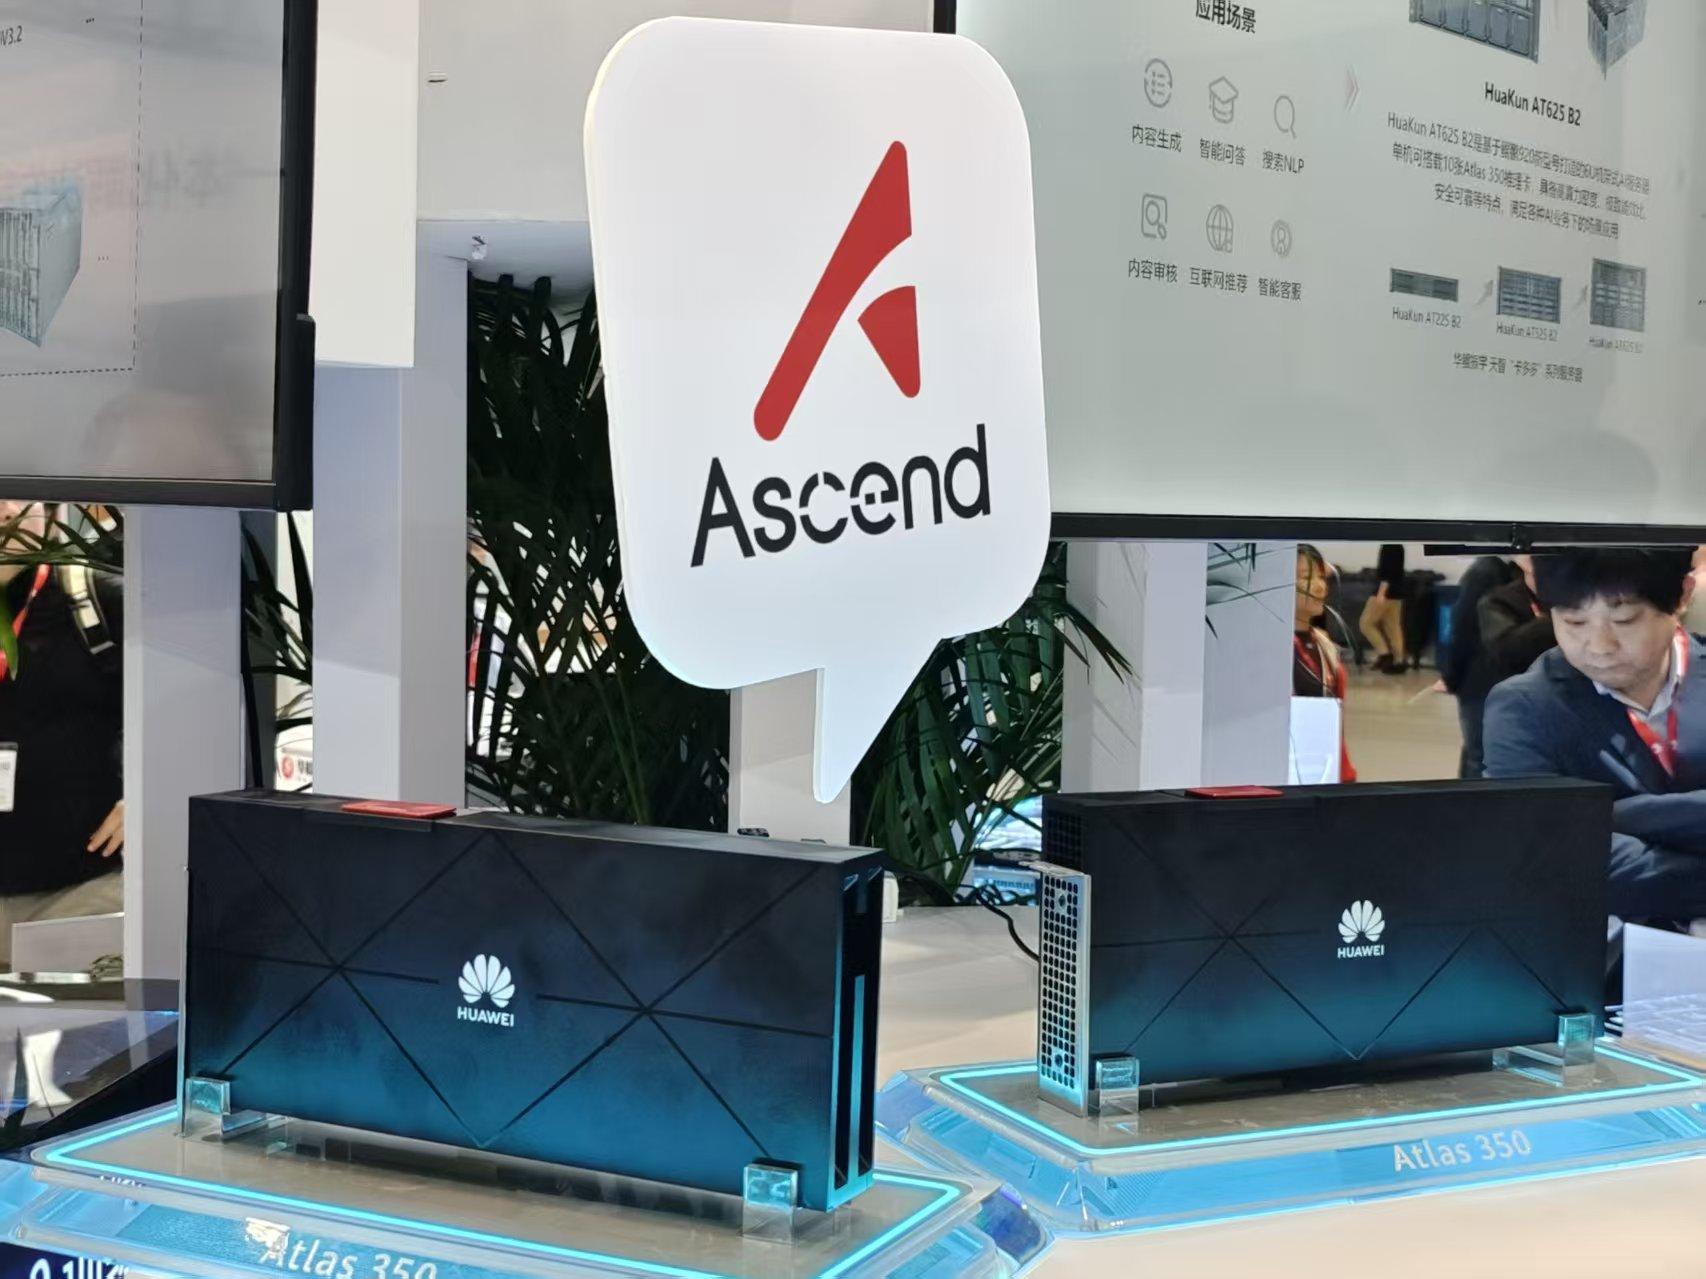
Пока американские власти то разрешают, то снова запрещают Nvidia продавать ускорители в Китай, а сама зеленая компания с барского плеча выпускает для китайского рынка урезанные версии своих GPU, Huawei решила больше не ждать милости от Хуанга. В марте 2026 года на партнерской конференции в Шэньчжэне компания представила Atlas 350 — PCIe-ускоритель на новом чипе Ascend 950PR с 1,56 PFLOPS в формате FP4, 112 ГБ памяти HBM собственной разработки и обещанием обойти Nvidia H20 почти в три раза. Звучит как очередной громкий китайский анонс, но на этот раз за цифрами стоят реальные заказы: после выхода DeepSeek V4, оптимизированной под чипы Huawei, за Ascend 350 выстроились в очередь как китайские ByteDance, Alibaba, Tencent, так и зарубежные покупатели по всему миру. В этой статье специалисты компании ServerFlow расскажут вам, как устроен NPU-чип Ascend 950PR, на котором базируется Atlas 350, чем новый ИИ-ускоритель отличается от прошлых ускорителей Huawei и насколько он на самом деле конкурентоспособен по сравнению с Nvidia.
NPU Ascend 950
Прежде чем говорить о самой карте, стоит разобраться с чипом, на котором она построена. Ascend 950 — это новое поколение ИИ-процессоров Huawei, которое компания впервые показала в своей дорожной карте еще в сентябре 2025 года. И главная особенность семейства в том, что оно сразу выходит в двух версиях, построенных на одной архитектуре, но с разной памятью:
- Ascend 950PR — 128 ГБ памяти с пропускной способностью 1,6 ТБ/с. Буквы PR в названии означают Prefill и Recommendation: чип заточен под фазу обработки промпта в LLM, рекомендательные системы и мультимодальный инференс. Именно он стоит в Atlas 350, и вышел он в первом квартале 2026 года.
- Ascend 950DT — 144 ГБ памяти с пропускной способностью 4 ТБ/с. DT означает Decode и Training: эта версия нацелена на генерацию токенов и полноценное обучение моделей. Выход запланирован на четвертый квартал 2026 года.

То есть, Huawei решила не делать один универсальный чип, а разделить задачи: 950PR с более дешевой и медленной памятью берет на себя prefill, а 950DT с быстрой памятью — decode.
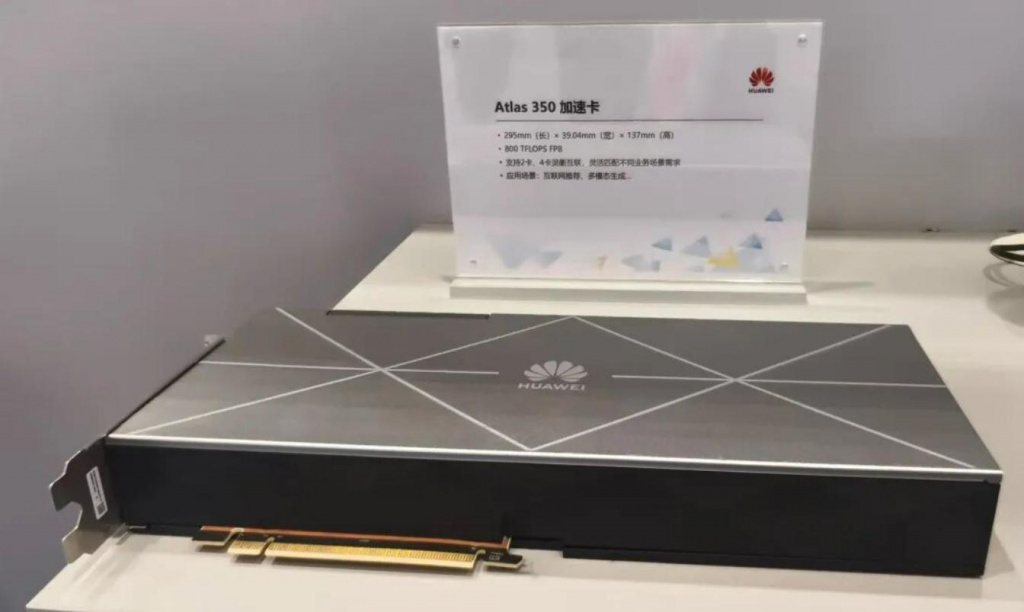
ИИ-ускоритель Huawei Atlas 350 с выставки Huawei. Источник: .
Как устроен Ascend 950PR
С предназначением NPU разобрались, теперь заглянем внутрь. Ascend 950 — это многокристальный чип: в одном корпусе собраны два вычислительных кристалла (AI Die), два кристалла ввода-вывода (IO Die) и восемь модулей памяти. Кристаллы связаны высокоскоростными межкристальными интерфейсами и образуют единое пространство памяти UMA, так что для энтузиаста весь чип выглядит как одно целое, а когерентность кэшей между кристаллами поддерживается аппаратно — это, кстати, было большой проблемой при работе с предыдущим поколением ИИ-ускорителей Huawei Atlas 300i Duo.
В полной конфигурации чип содержит 36 вычислительных блоков на третьем поколении фирменной архитектуры DaVinci. Каждый блок состоит из одного матричного ядра Cube Core и двух векторных ядер Vector Core:
- Cube Core отвечает за матричные умножения — основу любой нейросети. По сравнению с предыдущим поколением Ascend его пиковая производительность в FP4 выросла в четыре раза относительно прежнего BF16, а на ключевой для трансформеров операции FlashAttention один блок работает в 1,5–2 раза быстрее.
- Vector Core обрабатывает все, что не является матричным умножением: Softmax, функции активации, нормализацию. Его производительность в FP16 и FP32 удвоили, чтобы эти операции больше не становились узким местом.
Но самое интересное нововведение — поддержка гибридного программирования SIMD и SIMT. Раньше векторные ядра Ascend работали только в режиме SIMD, когда одна инструкция обрабатывает целый вектор данных. Это быстро, но неудобно для кода с ветвлениями и нерегулярным доступом к памяти. Теперь разработчик может писать такие участки в стиле SIMT, то есть потоками, как в CUDA. А это заметно упрощает перенос кода с видеокарт Nvidia.
Помимо ИИ-ядер, в чипе есть собственный процессорный блок на ядрах Huawei Linx816 с архитектурой Arm и поддержкой двух потоков на ядро, 128 МБ общего L2-кэша, аппаратный планировщик задач STARS 2.0 и блок DVPP для декодирования изображений и видео. В Atlas 350, судя по заявленной производительности, стоит не полная, а урезанная версия 950PR: 28 матричных ядер из 32 возможных и 112 ГБ памяти вместо 128.

Инженерный образец NPU Ascend 950PR. Источник: .
MXFP4, MXFP8 и HiF8
Рост производительности Ascend 950 во многом держится не на новых блоках, а на новых форматах данных. Чем меньше бит занимает одно число, тем больше операций ядро успевает выполнить за такт: при той же частоте 8-битные форматы дают вдвое больше операций, чем FP16, а 4-битные — вчетверо. Именно так Atlas 350 и получает свои 1561 TFLOPS в MXFP4 при 804 TFLOPS в FP8 и 425 TFLOPS в FP16/BF16.
Huawei поддерживает сразу несколько современных форматов:
- MXFP8 и MXFP4 — открытые форматы со сдвигом масштаба, при которых небольшой блок чисел хранит общий множитель. Это позволяет сохранить точность даже при 4 битах на число. Те же форматы используют и последние поколения ИИ-ускорителей Nvidia и AMD.
- HiF8 — собственный 8-битный формат Huawei. Его фишка в том, что он покрывает 38 степеней двойки против 18 у стандартного FP8 E4M3 и почти дотягивается до диапазона FP16 с его 40 степенями. При этом, в отличие от MXFP8, ему не нужен дополнительный байт общего масштаба. Точность у HiF8 максимальна для чисел около единицы и плавно снижается к краям диапазона, что хорошо соответствует реальному распределению весов в нейросетях.
Важно понимать, что 1,56 PFLOPS — это пиковая цифра для 4-битных вычислений, а реальную пользу от нее получат только модели, квантованные в MXFP4. Для классических задач в BF16 у Atlas 350 остается 425 TFLOPS, и это совсем другой уровень.
Память HiBL 1.0
Если с вычислениями у Huawei все выглядит бодро, то с памятью картина куда интереснее. Из-за американских санкций компания не может закупать передовую HBM у SK Hynix, Samsung или Micron, да и доступа к технологии упаковки TSMC CoWoS, на которой собраны ускорители Nvidia, у нее нет. Поэтому для Ascend 950PR Huawei разработала собственную высокоскоростную память HiBL 1.0 и собственную технологию ее упаковки рядом с кристаллами.
В Atlas 350 установлено 112 ГБ такой памяти с пропускной способностью 1,4 ТБ/с. По объему это даже больше, чем 96 ГБ у RTX PRO 6000 Blackwell, но по скорости — на 12,5% меньше, ведь у RTX PRO 6000 Blackwell память работает на 1,6 ТБ/с. Давайте посчитаем, что это значит для инференса. Для модели весом 70 ГБ теоретический потолок скорости генерации при batch=1 составит:
- Atlas 350: 1400 / 70 = 20 ток/с;
- RTX PRO 6000 Blackwell: 1600 / 70 = 23 ток/с
Вот и получается, что в фазе decode Atlas 350 практически достигла уровня RTX PRO 6000 Blackwell. Кроме того, HiBL 1.0 работает с гранулярностью доступа 128 байт, что ускоряет мелкие случайные обращения к памяти, характерные для рекомендательных моделей.
Не забыла Huawei и о надежности. Память поддерживает коррекцию ошибок ECC прямо в процессе работы, фоновую проверку ячеек с изоляцией слабых мест и резервные строки: если какая-то строка памяти выходит из строя, данные автоматически переносятся в запасную без остановки работы.
Интерконнект Lingqu
Одной картой большие модели не обслуживаются, поэтому не меньше памяти важно то, как ускорители общаются между собой. Здесь Huawei делает ставку на собственную шину Lingqu (в международной терминологии — Unified Bus 2.0). На уровне чипа Ascend 950 выводит наружу 72 высокоскоростные линии SerDes по 112 Гбит/с, сгруппированные в 18 портов x4, что дает до 2 ТБ/с двунаправленной пропускной способности. Для сравнения, у предыдущего поколения Ascend 910C интерконнект был в 2,5 раза медленнее.
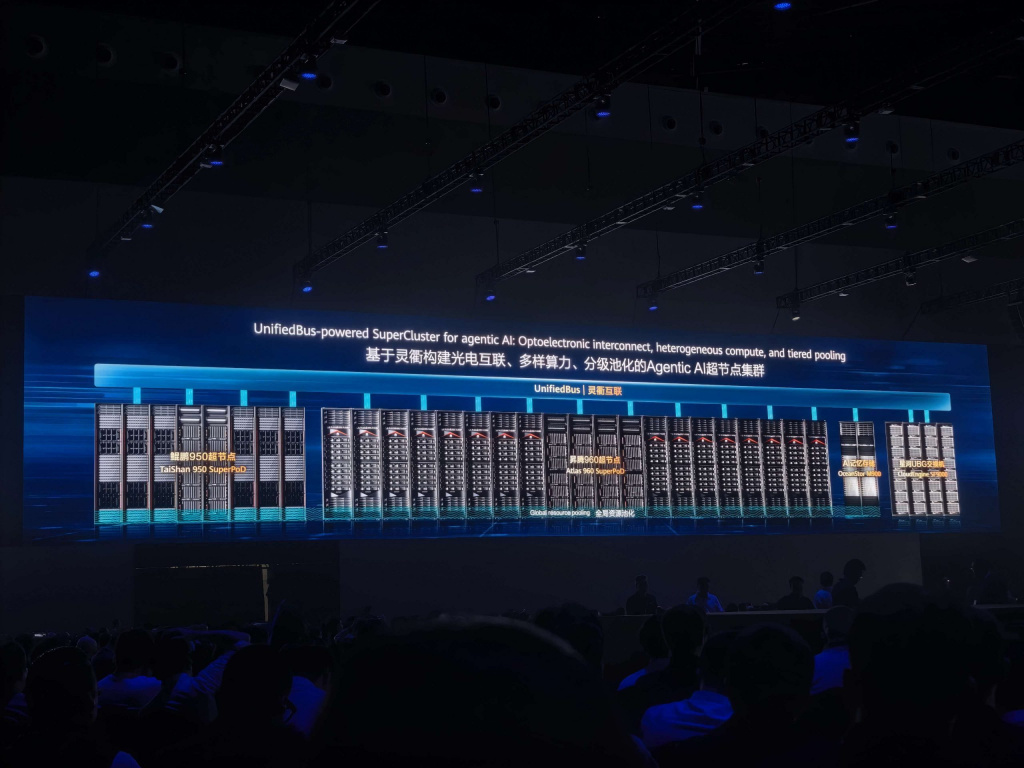
Возможности кластеризации ИИ-ускорителей за счет технологии Huawei Lingqu. Источник: .
Порты универсальны: часть из них можно отдать под PCIe 5.0 x16 для связи с хост-процессором, часть — под два линка UBoE по 400 Гбит/с для подключения к обычным Ethernet-коммутаторам, а остальные — под прямую связь между ускорителями. Причем Lingqu поддерживает не только передачу сообщений, но и прямые операции чтения и записи в память соседних чипов, а встроенный блок CCU берет на себя коллективные операции вроде All-Reduce и All-to-All, освобождая вычислительные ядра.
В Atlas 350 все это реализовано через специальный разъем на самой карте. Ускорители можно объединить двумя способами:
- Две карты соединяются четырьмя портами, каждая с пропускной способностью до 424 ГБ/с в обе стороны.
- Четыре карты связываются по схеме "каждая с каждой" тремя портами на карту с пропускной способностью до 318 ГБ/с.
Даже в худшем случае это в 2,5 раза быстрее, чем PCIe 5.0 x16 с его 128 ГБ/с. А в больших системах Huawei масштабирует ту же шину до суперузлов Atlas 950 SuperPoD на 8192 чипа и кластеров на более чем 128 тысяч ускорителей.
Atlas 350 против Nvidia
Теперь, когда понятно, что скрывается внутри, посмотрим на саму карту. Atlas 350 выполнен в формате полноразмерной двухслотовой PCIe-карты длиной 295 мм и весом 3 кг (очень много для PCIe-ускорителя). Охлаждение пассивное, то есть рассчитано на продув серверными вентиляторами, а энергопотребление достигает 600 Вт.
Для сравнения возьмём NVIDIA RTX PRO 6000 Blackwell Server Edition. Это тоже двухслотовая пассивная PCIe-карта мощностью до 600 Вт, но с 96 ГБ GDDR7 и пропускной способностью памяти около 1,6 ТБ/с. По форм-фактору и энергопотреблению ускорители практически одинаковы, однако по памяти есть существенные различия: у Huawei 112 ГБ собственной HBM с пропускной способностью 1,4 ТБ/с.
Вычислительные показатели тоже интересны. Atlas 350 выдаёт 1,56 PFLOPS в MXFP4, 804 TFLOPS в MXFP8 и 425 TFLOPS в BF16. У RTX PRO 6000 Blackwell заявлены пиковые показатели до 4 PFLOPS в FP4, 2 PFLOPS в FP8 и 1 PFLOPS в BF16. Однако здесь важно учитывать методику подсчёта: для Blackwell показатели Tensor Core могут учитывать структурную разреженность, поэтому напрямую сопоставлять их с плотными вычислениями Atlas 350 некорректно. В любом случае у NVIDIA есть полноценная поддержка FP4, а значит, прежний аргумент Huawei о преимуществе над ускорителем без этого формата здесь уже не работает.
Есть и третий интересный участник сравнения — AMD Instinct MI350P. Это, пожалуй, наиболее близкий конкурент Atlas 350 по сочетанию форм-фактора и энергопотребления. Ускоритель построен на архитектуре CDNA 4, оснащён 144 ГБ HBM3E с пропускной способностью 4 ТБ/с и также потребляет до 600 Вт. При этом AMD заявляет 4,6 PFLOPS в MXFP4, 2,3 PFLOPS в MXFP8 и 1,15 PFLOPS в BF16 без разреженности. То есть по заявленной плотной вычислительной производительности MI350P заметно опережает Atlas 350, а по объёму и пропускной способности памяти преимущество ещё существеннее. При одинаковом энергопотреблении AMD предлагает гораздо более широкую полосу доступа к данным — важный фактор для инференса больших языковых моделей, особенно на этапе генерации токенов.
Таким образом, Atlas 350 выглядит интересным прежде всего как попытка Huawei создать собственную полноценную платформу для AI-инференса. Но если сравнивать только характеристики железа, AMD MI350P предлагает более мощную память и вычислительные блоки, а NVIDIA RTX PRO 6000 Blackwell — зрелую программную экосистему CUDA и поддержку современных форматов низкой точности. Окончательный ответ дадут реальные тесты: пиковые FLOPS сами по себе ещё не говорят о скорости генерации токенов и эффективности работы с конкретными моделями.
Форм-фактор Atlas 350
Отдельного внимания заслуживает исполнение карты. Huawei использует форм-фактор OH FL DW (Oversized Height, Full Length, Double Width) — увеличенная высота, полная длина и двойная ширина. Это не стандартная двухслотовая PCIe-карта, несмотря на привычный интерфейс подключения.
Atlas 350 заметно выше и крупнее обычных серверных ускорителей, поэтому установить её в произвольный сервер с PCIe x16 не получится. Потребуется шасси, рассчитанное именно на такие габариты и соответствующую систему охлаждения. Для сравнения, NVIDIA RTX PRO 6000 Blackwell Server Edition использует гораздо более распространённый серверный формат и совместима с существенно большим количеством платформ.
В качестве подходящего решения можно привести ASUS ESC8000A-E13 DR — сервер, рассчитанный на установку таких ускорителей. Поэтому при закупке Atlas 350 придётся заранее подбирать не только сами карты, но и совместимые серверы. Это важный нюанс: наличие свободных PCIe-слотов ещё не означает, что ускоритель физически поместится в корпус.
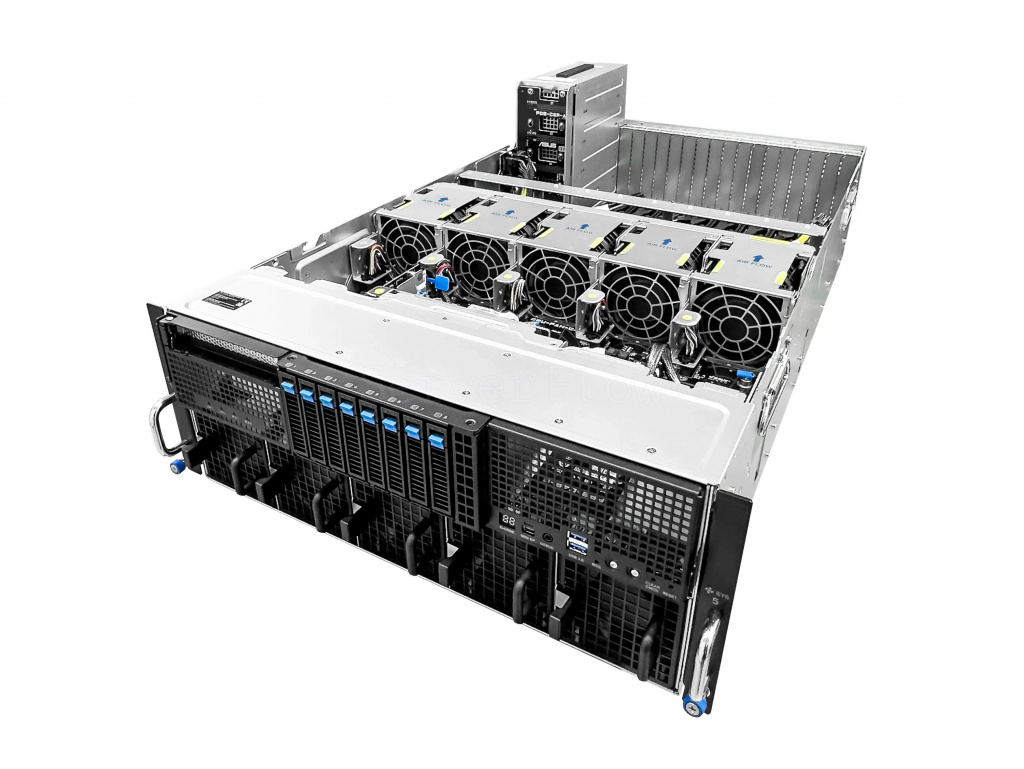
Серверная платформа ASUS ESC8000A-E13 DR.
ПО и экосистема
Впрочем, железо — это только половина дела. Главное преимущество Nvidia давно уже не в самих видеокартах, а в экосистеме CUDA, под которую за полтора десятилетия написаны почти все ИИ-библиотеки, фреймворки и оптимизированные ядра. И именно здесь Huawei приходится сложнее всего.
Своим ответом CUDA Huawei считает программный стек CANN (Compute Architecture for Neural Networks), который включает библиотеки ускорения, компилятор, среду выполнения и язык программирования ядер Ascend C. В последнее время компания открыла исходный код CANN, чтобы разработчики могли сами оптимизировать низкоуровневые операции, а PyTorch работает на Ascend через официальный плагин. Поддержка SIMT в 950PR — еще один шаг в ту же сторону: код, написанный в "потоковом" стиле CUDA, переносить на Ascend теперь заметно проще.
Но по-настоящему переломным моментом стала DeepSeek V4. Модель с самого начала оптимизировали под чипы Huawei, а сама Huawei заявила о поддержке V4 на всей линейке своих суперузлов с первого дня. Это показало китайскому рынку главное: топовые модели действительно могут работать на отечественном железе. Тем не менее заявления о совместимости с CUDA стоит воспринимать с осторожностью. Перенос сложных проектов с видеокарт Nvidia на Ascend по-прежнему требует времени, а набор готовых оптимизированных библиотек у Huawei пока несравнимо меньше.
Выводы
Так стал ли Atlas 350 настоящим ответом Nvidia? С оговорками — да. По вычислительной мощности новинка Huawei почти втрое обходит H20 даже в честном сравнении одинаковых форматов, получила поддержку FP4 и фирменного HiF8, гибридное программирование SIMD и SIMT, собственную память HiBL и скоростную шину Lingqu. И главное — на ней уже работают топовые китайские модели вроде DeepSeek V4, а крупнейшие IT-компании страны выстраиваются в очередь за поставками. Догнать флагманы Nvidia вроде Blackwell и Rubin Huawei пока не может, но для китайского рынка, отрезанного от передовых американских ускорителей, это уже не так важно: впервые у страны появился собственный ИИ-ускоритель, способный конкурировать с тем, что Nvidia вообще разрешено туда продавать. Если вы подбираете ИИ-ускорители под свои задачи и не знаете, какое решение окажется оптимальным по производительности и стоимости, обращайтесь к специалистам компании ServerFlow — мы подберем подходящую конфигурацию и проведем вас за руку от покупки оборудования до его запуска в продакшен.
