FP8: архитектура формата E4M3 и E5M2 и его роль в Mixed Precision вычислениях
Введение: новая волна форматов. От FP16 к FP8
Если вы разглядывали спецификации NVIDIA H100 или документацию AMD MI300, то наверняка видели упоминания про FP8 performance. Но что это значит на самом деле? Раньше, когда речь заходила о смешанной точности (mixed precision), инженеры говорили про FP16 и BF16 – это был стандарт для ускорения обучения и инференса сложных моделей. Работа велась так: основные вычисления в низкой точности, а веса и градиенты хранились в более высокой точности для стабильности.
Теперь появился новый стандарт. FP8 – это 8-битный формат с плавающей запятой, впервые появившийся в тензорных ядрах NVIDIA H100 Hopper (2022) и позднее внедренный AMD в MI300 (CDNA 3). Это принципиально отличается от INT8, который вы встречали раньше в примерах PTQ-квантизации. FP8 остаётся форматом с плавающей запятой, то есть использует экспоненту и мантиссу для кодирования чисел, а не целочисленное представление.
Практический результат впечатляет: FP8 даёт примерно вдвое больше ускорения по сравнению с FP16. Это значит, что на том же GPU вы можете обработать в два раза больше операций за единицу времени. Параллельно с этим снижается потребление памяти на 50 процентов, поскольку каждое число занимает половину места. Совокупный эффект – это возможность обучать и производить инференс модели на существующем железе, которое раньше для этого было недостаточно мощным, или одновременно обрабатывать в два раза больше запросов.
Главное отличие FP8 от INT8 состоит в том, что FP8 – это вычисления на уровне тензорных ядер (hardware-level quantization), в то время как INT8 – это оптимизация на уровне модели и инференса (PTQ, QAT). INT8 требует калибровки и часто применяется уже после обучения. FP8 же встроен в архитектуру GPU и может использоваться как во время обучения (через Transformer Engine), так и при инференсе. FP8 к тому же не монолитный формат, у него есть два варианта: E4M3 и E5M2.
Что такое FP8: принципы формата E4M3 и E5M2
Чтобы понять FP8, нужно разобраться в его двух вариантах: E4M3 и E5M2. Оба они уместили информацию о числе в 8 бит, но распределили эти биты по-разному.
E4M3 (1 бит знака + 4 бита экспоненты + 3 бита мантиссы). Этот формат приоритизирует точность. Четыре бита на экспоненту дают ему диапазон примерно от ±448, а три бита на мантиссу обеспечивают более точное представление чисел, близких к нулю. E4M3 используется для весов (weights) и активаций (activations) в прямом проходе (forward pass) нейросети. Здесь нужна точность, потому что небольшие изменения в значениях могут накапливаться и влиять на качество вычислений.
E5M2 (1 бит знака + 5 бит экспоненты + 2 бита мантиссы). Этот формат жертвует точностью ради диапазона. Пять бит на экспоненту расширяют диапазон до ±57 344, что позволяет представлять очень большие и очень маленькие значения. E5M2 предназначен для градиентов (gradients), которые вычисляются при обратном проходе (backward pass). Во время обратного распространения ошибки градиенты могут быть очень большими или очень маленькими, и тесный диапазон E4M3 привел бы к потерям информации.
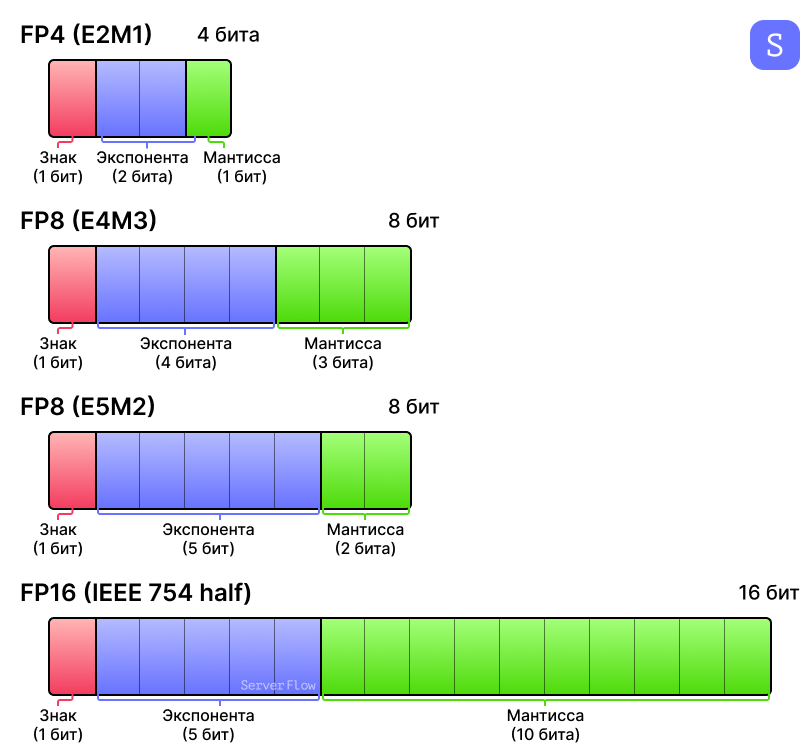
Схематика вариантов FP8: E4M3 и E5M2. И их сопоставление с другими форматами.
Выбор между E4M3 и E5M2 – это выбор между локальной точностью и глобальным диапазоном. Некоторые сети могут тренироваться целиком на одном из этих форматов, но большинство больших моделей требует обоих: E4M3 для forward pass и E5M2 для backward pass.
На уровне аппаратуры это означает, что операции в тензорных ядрах (Tensor Cores) напрямую работают с FP8, не требуя промежуточных преобразований. В NVIDIA H100 тензорные ядра четвёртого поколения поддерживают умножение и суммирование в FP8 с сохранением результата в более высокой точности. На уровне кода это выглядит простой операцией, но в электронике это требовало серьёзной переработки конвейера вычислений.
FP8 vs INT8: почему это не одно и то же
Путаница между FP8 и INT8 встречается часто, потому что оба – это 8-битные форматы. Но это совершенно разные подходы.
INT8 – это целочисленная квантизация (integer quantization). Числа представляются как целые числа в диапазоне от -128 до 127. Для этого требуется фиксированный scale (множитель), который определяется наибольшим значением в наборе данных. Если в ваших активациях есть выброс (outlier), он растягивает шкалу, и остальные значения представляются менее точно. INT8 применяется в основном для инференса и требует калибровки либо на этапе post-training quantization (PTQ), либо во время quantization-aware training (QAT).
FP8 – это плавающая запятая. Каждое число хранит свою экспоненту, что даёт адаптивный динамический диапазон. Если значение маленькое, экспонента подстраивается автоматически, и мантисса используется эффективнее. Если значение большое, экспонента растёт, сохраняя грубую точность. Этот подход естественнее для выбросов: они не «растягивают» шкалу для всех остальных значений.
На практике это означает, что FP8 лучше подходит для обучения больших моделей, где градиенты могут иметь широкий диапазон значений. INT8, напротив, показывает лучшие результаты на инференсе, когда активации и веса более стабильны и предсказуемы. Из исследований Qualcomm и NVIDIA видно, что FP8 покрывает 92.64% операций в современных сетях, в то время как INT8 справляется только с 65.87%. FP8 может работать с операциями типа LayerNorm и BatchNorm, где INT8 часто требует обхода.
По скорости на современном железе: INT8 может быть быстрее на специализированных inference-ускорителях (например, на edge-устройствах), но на H100 и MI300 FP8 работает на максимальной скорости благодаря встроенной поддержке в тензорных ядрах.
Аппаратная поддержка: NVIDIA и AMD
Поддержка FP8 на уровне железа – это то, что делает его реально применимым, а не просто теоретической конструкцией.

NVIDIA H100 – именно с неё началось внедрение FP8, она стала первым ускорителем поддерживающим этот формат аппаратно.
NVIDIA встроила FP8 в H100 через четвёртое поколение Tensor Cores (2022). H100 обеспечивает до ~1 PFLOP/s производительности для FP8 операций без структурной разреженности. Это достигается благодаря специализированным матричным умножителям в каждом Tensor Core, которые работают с FP8 и аккумулируют результаты в более высокой точности. На B200 Blackwell (2025) производительность выросла до 2.5 PetaFLOPS для FP8, и добавилась поддержка ещё более низких форматов (FP4, FP6). Transformer Engine в H100 автоматически выбирает между FP8 и FP16 для оптимизации обучения, переключаясь в зависимости от наслоения модели.

Эволюция тензорных ядер, от архитектуры Ampere с форматом FP16, до Hopper, в которых появилась поддержка FP8 вычислений. Источник: .
AMD пошла похожим путём. MI300 поддерживает FP8 через ROCm, и в ROCm 7.0 (2024) AMD представила Quark – фреймворк для квантизации, который включает полную поддержку FP8. Отличие в том, что AMD поддерживает E4M3 и E5M2, но с кодировкой, которая немного отличается от NVIDIA, хотя принципы остаются теми же. MI300X получает примерно 3.5х ускорение инференса при переходе на FP8 в ROCm 7.0.
Обе компании поддерживают стандарт, который предложили совместно NVIDIA, Arm и Intel, и который входит в Open Compute Project MX format наряду с FP4 и FP6.
FP8 в экосистеме LLM и квантизации
FP8 не конкурирует с методами весовой квантизации (weight quantization) вроде AWQ, GPTQ, NF4 и W4A16. Вместо этого он дополняет их.
Весовая квантизация (например, NF4 из BitsAndBytes) сжимает веса модели до 4 бит за счёт специальных методов калибровки. Когда вы используете QLoRA с NF4, веса хранятся в 4-битном формате, и они разворачиваются в BF16 только для вычислений. Это позволяет загрузить большую модель на GPU с ограниченной памятью.
FP8 работает на другом уровне: это формат вычислений, а не хранения. Когда вы делаете инференс или обучение, операции матричного умножения выполняются в FP8, даже если веса хранятся в другом формате. Более того, весовая квантизация и FP8-вычисления могут использоваться совместно. Например, вы можете:
- Хранить веса модели в NF4 (4 бита)
- Разворачивать их в INT8 или FP8 перед вычислением
- Выполнять операции в FP8 на Tensor Cores H100
- Сохранять результаты в FP16 или BF16 для следующего слоя
Фреймворк vLLM, который используется для инференса больших языковых моделей, начиная с версии 0.5, поддерживает статическую FP8-квантизацию. Инженеры из Neural Magic создали открытую библиотеку llm-compressor, которая позволяет квантизировать любую модель в FP8 с учётом калибровки на вашем датасете. При правильной настройке FP8-квантизация на инференсе даёт до 2х ускорения для плотных моделей (например, Llama* 3 70B) и 1.6х для MoE-моделей.
Совместное использование NF4-весов и FP8-вычислений открывает интересные возможности: вы сокращаете использование памяти за счёт NF4, а заодно получаете ускорение вычислений от FP8. Для инференса это критично при развёртывании на серверах с ограниченной памятью.
Заключение: FP8 — новый базовый уровень точности для ИИ
FP8 – это логичное продолжение исторической эволюции точности в вычислениях: от FP64 к FP32, потом к FP16 и BF16, и теперь к FP8. На каждом шаге мы теряли информацию, но выигрывали в скорости и эффективности. FP8 завершает эту цепь для современных нейросетей.
Главные плюсы FP8:
- Ускорение в 2 раза относительно FP16 благодаря встроенной поддержке в тензорных ядрах
- Экономия памяти на 50 процентов для весов, активаций и градиентов
- Снижение энергопотребления благодаря тому, что операции выполняются быстрее и с меньшей нагрузкой на шину памяти
- Лучшая точность при квантизации, чем INT8, за счёт адаптивного диапазона экспоненты
- Поддержка на современном железе: NVIDIA H100, B200, AMD MI300, MI355X
Важное уточнение: FP8 не заменяет INT8 для инференса на edge-устройствах, где нет встроенной поддержки. Он дополняет INT8 в центрах обработки данных с современными ускорителями. Если вы развёртываете модель на мобильном устройстве или на специализированном NPU без FP8-поддержки, INT8 остаётся вашим выбором.
Исторически, FP16 позволил делать то, что раньше было невозможно на одном GPU. Сейчас FP8 повторяет эту роль: он делает возможным обучение и инференс моделей, которые требуют слишком много памяти и времени в FP16. И тренд будет продолжаться: следующие поколения ускорителей уже поддерживают FP4 и ещё более низкие точности, но FP8 закрепит свою позицию как универсальный стандарт для эффективных вычислений в нейросетях на долгие годы.
FP8 — это новая точка баланса между скоростью и точностью.
В ServerFlow мы уже тестируем FP8 на серверах с NVIDIA H100 и AMD MI300, чтобы понять, как эта технология меняет инференс LLM в 2025 году.
*LLAMA — проект Meta Platforms Inc.**, деятельность которой в России признана экстремистской и запрещена
**Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
