cuBLAS и cuBLASLt: как NVIDIA ускоряет матричные вычисления
Введение
Когда нейросеть обрабатывает запрос, значительная часть её работы приходится на умножение матриц: такие операции нужны и при обучении, и при использовании готовой модели. Однако мощной видеокарте недостаточно просто поручить вычисления: необходимо правильно распределить работу, организовать движение данных и выбрать подходящий способ выполнения задачи.
В экосистеме NVIDIA этим занимаются, в частности, cuBLAS и cuBLASLt, библиотеки оптимизированных операций линейной алгебры для графических процессоров. Пользователь может даже не знать об их существовании: к ним обращаются средства машинного обучения, например PyTorch, скрывая сложную реализацию за короткими командами. Но именно устройство этих библиотек помогает понять, почему одинаковая видеокарта в разных программах показывает разную скорость.
Зачем компьютеру умножать матрицы
Матрица представляет собой прямоугольную таблицу чисел, а при умножении двух матриц каждый элемент результата получается из строки первой таблицы и столбца второй: соответствующие числа перемножаются, после чего произведения складываются. Например, для строки из чисел 2 и 3 и столбца из чисел 4 и 5 получится 23: дважды четыре плюс трижды пять.
За этим простым действием стоит удобный способ обрабатывать множество взаимосвязанных величин: матричные вычисления используются в моделировании, компьютерной графике, решении систем уравнений и машинном обучении. В полносвязном слое нейросети одна матрица может содержать веса, то есть обучаемые коэффициенты, а другая представляет входные данные сразу для группы примеров.
Умножение позволяет рассчитать взвешенные суммы для множества выходов, после чего к полученным значениям можно прибавить смещение и применить функцию активации, нелинейно изменяющую результат. Этот небольшой фрагмент нейросети станет сквозным примером: на нём хорошо видно, зачем вычислительным библиотекам нужно уметь больше, чем просто перемножать таблицы.
В документации матричное умножение часто обозначается GEMM, сокращённо от General Matrix Multiplication, или обобщённого матричного умножения. Обобщение означает, что произведение можно дополнительно умножить на коэффициент и сложить с другой матрицей, тоже с коэффициентом. Математическая запись такой операции компактна, но за ней может скрываться огромное количество однотипных действий.
Именно здесь возникает разрыв между простотой задачи и сложностью её эффективного выполнения: одни и те же матрицы можно перемножить разными способами, с неодинаковой загрузкой GPU и разным количеством обращений к памяти. Поэтому важен не только ответ на вопрос “что вычислить”, но и то, как организованы вычисления.
cuBLAS: готовые вычисления для GPU
Название BLAS расшифровывается как Basic Linear Algebra Subprograms, “базовые подпрограммы линейной алгебры”. Этот набор охватывает стандартные операции над векторами и матрицами. Идея заключается в разделении обязанностей: приложение обращается к известной математической операции, а библиотека предоставляет её реализацию для конкретного оборудования.
cuBLAS реализует эти операции поверх среды CUDA и позволяет выполнять их на графических процессорах NVIDIA. Причём библиотека не ограничивается умножением матриц: она поддерживает все три уровня BLAS, от действий над векторами до матрично-векторных и матрично-матричных вычислений. Для глубокого обучения особенно важна GEMM, поэтому её ускорению уделяется столько внимания.
Внутри находится не единственная универсальная программа умножения, а множество вычислительных реализаций, которые называют ядрами. Программное ядро здесь означает код, запускаемый на видеокарте, а не физическое ядро процессора. Библиотека выбирает реализацию с учётом параметров задачи, включая размеры матриц и используемые числовые форматы.
Это позволяет разработчику не писать низкоуровневую реализацию заново для каждого случая: за обычным вызовом скрываются решения о распределении вычислений и использовании аппаратных возможностей GPU. Однако библиотека не превращает любую программу в эффективную: данные должны быть доступны ускорителю, параметры заданы правильно, а результаты использованы без ненужных пересылок.
Полезно представить cuBLAS как специализированную вычислительную службу. Приложение передаёт ей математическое задание, а служба подбирает подходящий способ выполнения. Но если вызывающая программа постоянно отвлекает GPU мелкими поручениями или пересылает одни и те же данные туда и обратно, одной быстрой арифметики недостаточно.
Как GPU ускоряет умножение
Матричное произведение удобно делить на части: разные участки итоговой таблицы можно рассчитывать параллельно. GPU разбивает результат на небольшие прямоугольные блоки и распределяет их между группами вычислительных потоков. А каждая группа загружает необходимые фрагменты исходных матриц, перемножает их и накапливает частичные суммы.
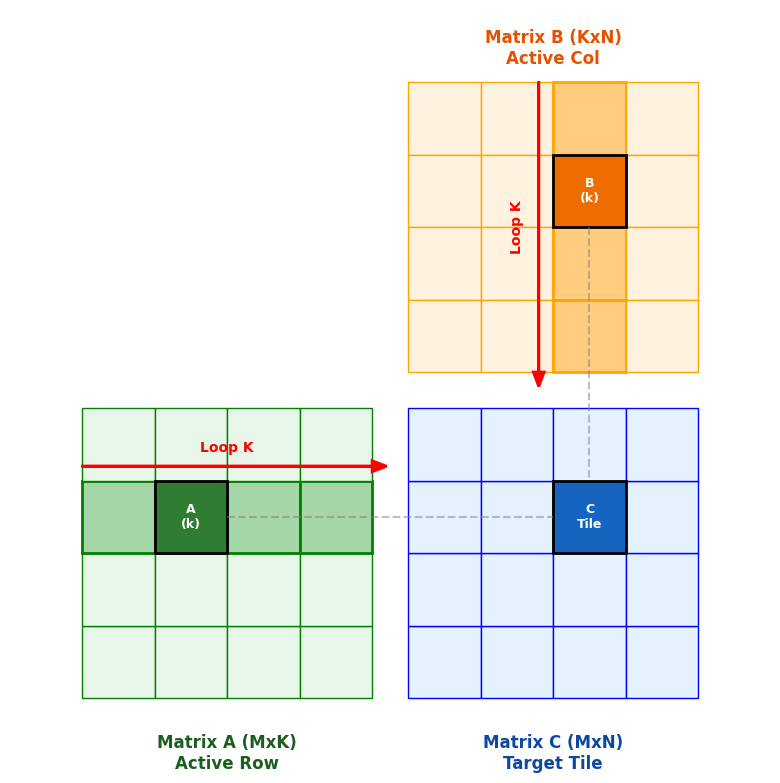
Матричное произведение разбито на прямоугольные участки: для вычисления блока результата используются соответствующие фрагменты исходных таблиц. Иллюстрация показывает общий принцип блочного умножения, а не внутреннюю реализацию конкретного вызова cuBLAS. Источник: .
При таком подходе одно загруженное число может участвовать во многих вычислениях, что позволяет уменьшить потребность в передаче данных. Если постоянно перечитывать исходные значения из видеопамяти, арифметические устройства будут проводить слишком много времени в ожидании, поэтому повторное использование данных становится важнейшей частью оптимизации.
Выбрать размер блока непросто: более крупные участки обычно позволяют эффективнее использовать загруженные числа, но оставляют меньше независимых заданий для параллельного выполнения. Слишком мелкое разбиение, напротив, увеличивает количество отдельных участков работы, но может ухудшить эффективность каждого из них. Библиотека ищет подходящий баланс, а не просто делит любую матрицу одинаковым способом.
Другая составляющая ускорения связана с тензорными ядрами, специализированными аппаратными блоками для матричных операций. При подходящих условиях библиотека выбирает реализации, использующие эти возможности, но эффективность по-прежнему зависит от параметров задачи и организации работы с данными.
При этом числа не обязательно везде имеют одинаковый формат: например, входные матрицы могут храниться в 16-битном представлении, а суммы произведений накапливаться в 32-битном. Это один из вариантов смешанной точности, при котором компактное хранение сочетается с более точным накоплением результата.
Однако уменьшение разрядности меняет набор представимых значений и особенности округления, поэтому формат выбирают с учётом требований к результату. Библиотека предоставляет различные режимы вычислений, но не решает вместо разработчика, какая погрешность допустима для его приложения.
Зачем появилась cuBLASLt
Классический BLAS хорошо описывает отдельные математические действия, а нейросетевым приложениям часто нужна более гибкая операция: с разными форматами входных данных, определённым расположением чисел в памяти и обработкой результата сразу после умножения. Для этого NVIDIA предлагает cuBLASLt, специализированный интерфейс матричного умножения с расширенными возможностями настройки.
NVIDIA описывает cuBLASLt как облегчённую библиотеку, сосредоточенную на GEMM. Причём речь не об урезанной производительности, а о более узкой специализации. Вместо полного набора BLAS она предоставляет гибкое описание матричной операции, включая типы данных, способ вычислений, завершающую обработку и выбор реализации.
Вернёмся к примеру со слоем нейросети: сначала входные данные умножаются на матрицу весов, затем прибавляется смещение и применяется активация. Если выполнять действия отдельно, промежуточный результат приходится передавать между отдельными операциями, тогда как объединённая реализация позволяет выполнить всю поддерживаемую последовательность совместно.
cuBLASLt умеет объединять матричное умножение с некоторыми последующими действиями, например прибавлением смещения и применением функций ReLU или GELU. В документации такую завершающую обработку называют эпилогом: она является частью общей операции, а не обязательно отдельным проходом по готовой таблице.
Для наглядности можно взять ReLU, простую функцию активации, которая заменяет отрицательные значения нулями и оставляет положительные без изменений. Обработать результат непосредственно при выполнении общей операции выгоднее, чем отдельно организовывать каждый шаг, и NVIDIA демонстрирует этот подход как для использования модели, так и для обучения.
При обучении появляются дополнительные задачи: необходимо вычислять, как изменение параметров влияет на ошибку модели, а для прохождения через ReLU сохранить сведения о знаке её входных значений. Некоторые эпилоги позволяют объединить связанные с этим действия с матричными вычислениями.
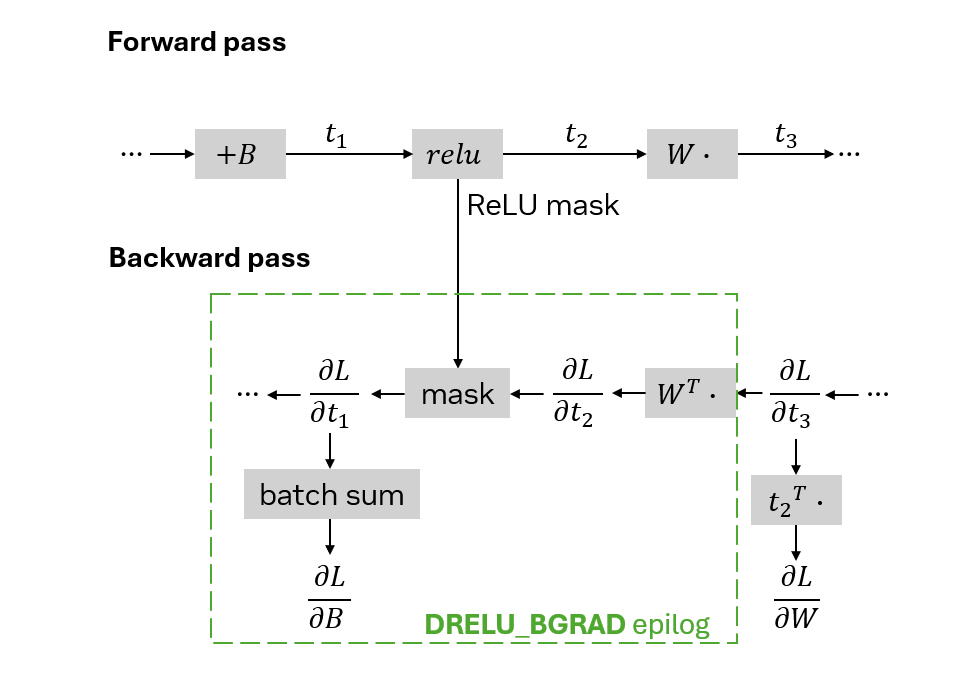
Схема показывает прямое вычисление и обратное распространение ошибки. Зелёной рамкой выделены действия, объединяемые с матричным умножением при обратном проходе: применение сохранённой маски ReLU и вычисление градиента смещения. Разбирать формулы для понимания принципа не требуется. Источник: .
Важно, что cuBLASLt поддерживает определённый набор эпилогов, а не произвольный пользовательский код, который можно без ограничений добавить к умножению. Доступность конкретных сочетаний также зависит от форматов данных и других параметров операции.
Ещё одна возможность касается расположения матриц в памяти: cuBLASLt позволяет гибче описывать, как именно размещены данные. Это помогает согласовать матричное умножение с устройством приложения, а выбранные настройки можно повторно использовать для других входных значений при сохранении параметров задачи.
Поэтому противопоставление “cuBLAS без тензорных ядер, cuBLASLt с ними” неверно: классическая cuBLAS тоже использует аппаратное ускорение матричных операций. Преимущество cuBLASLt заключается прежде всего в гибкости описания и настройки вычислений, а не в доступе к особой мощности, недоступной обычной библиотеке.
Почему ускорение бывает разным
Одинаковый объём исходных данных ещё не означает одинаковую нагрузку: крупное матричное произведение и множество маленьких операций по-разному используют вычислительные ресурсы. Большая задача чаще предоставляет достаточно независимой работы и возможностей повторного использования данных, а маленькая может не позволить эффективно загрузить GPU.
Значение имеет и форма таблиц: узкая матрица и большая квадратная матрица создают разные соотношения между количеством вычислений и объёмом передачи данных. В одном случае предел задаётся скоростью арифметики, в другом скоростью памяти, поэтому рост паспортных терафлопсов не гарантирует пропорционального ускорения.
Важен даже порядок обработки участков результата: если соседние задания используют общие фрагменты исходных матриц, удачная организация работы помогает чаще находить нужные данные в быстрой памяти. Меняется не математическая задача, а количество необходимых загрузок.
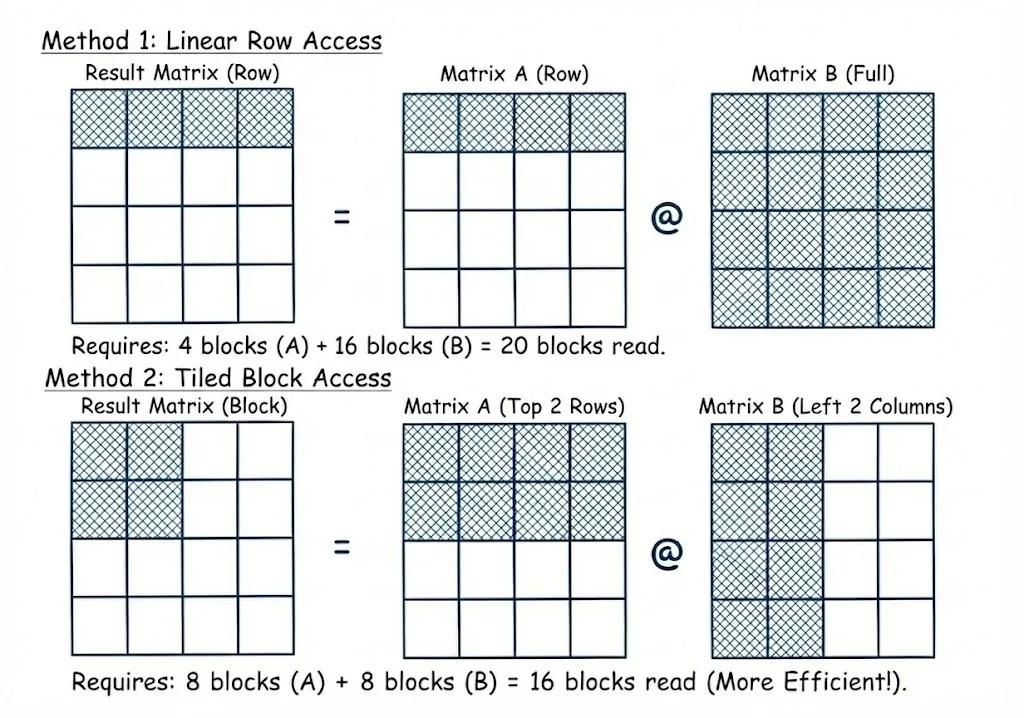
Два способа вычислить одинаковое количество участков результата требуют разного набора исходных данных. В приведённом примере обработка локального прямоугольного участка вместо целой строки сокращает число необходимых чтений блоков. Источник: .
Есть и менее очевидная причина: размеры таблицы могут плохо согласовываться с размерами вычислительных блоков. Если крайний блок заполнен лишь частично, часть предусмотренной работы не даёт полезных элементов результата, а небольшое увеличение матрицы иногда требует добавить целый ряд почти пустых блоков.
Выбор реализации тоже влияет на результат: cuBLAS использует эвристики, то есть по известным параметрам оценивает, какой вариант окажется подходящим. Это не полный перебор при каждом обращении, и оценка не гарантирует самого быстрого решения для каждой отдельной задачи.
Через cuBLASLt разработчик может получить несколько подходящих вариантов, измерить время выполнения и сохранить лучший для дальнейшего использования. Такой подбор особенно полезен при многократном повторении одинаковых по форме вычислений: первоначальные расходы на подготовку распределяются между последующими запусками.
Но даже идеально подобранное матричное умножение ускоряет только соответствующую часть приложения. Если программа тратит много времени на другие действия, нельзя ожидать, что выигрыш одной операции целиком перенесётся на обработку запроса. Поэтому оценивать результат нужно по времени выполнения полезной задачи, а не только по скорости отдельного произведения.
Что это меняет для пользователя
Большинство пользователей сталкивается с cuBLAS не напрямую, а через программы и средства машинного обучения: например, PyTorch поддерживает и cuBLAS, и cuBLASLt. Поэтому короткое выражение высокого уровня может запускать сложный оптимизированный код, который пользователь не писал и даже не видит.
Из этого, однако, не следует, что любое выражение автоматически выполнится самым быстрым способом: документация PyTorch предусматривает выбор используемой библиотеки, а доступные варианты могут давать разную производительность. Поэтому одинаковая математическая задача в двух приложениях способна по-разному использовать одну видеокарту.
Развитие библиотек связано и с более компактными числовыми форматами: поддержка блочного масштабирования FP4 и FP8 для архитектуры Blackwell появилась в cuBLAS 12.8, а в cuBLAS 12.9 NVIDIA расширила возможности масштабирования FP8 для ускорителей Hopper. Цифры в этих обозначениях указывают разрядность представления числа, но сами форматы различаются не только занимаемым объёмом, а также точностью и диапазоном значений.
При блочном масштабировании небольшая группа чисел получает собственный масштаб, что позволяет лучше приспособить компактное представление к значениям внутри этой группы. Это помогает находить компромисс между расходом памяти, скоростью и численными свойствами вычислений, но не превращает самый компактный формат в универсальную замену всем остальным.
Просто установить новую библиотеку недостаточно: приложение должно использовать соответствующий режим, а оборудование поддерживать необходимые возможности. Тем не менее готовые библиотеки делают эти возможности доступными без самостоятельного написания низкоуровневых вычислений, и в этом заключается их практическая ценность.
Пользователю полезно смотреть не только на название видеокарты, но и на программное окружение, выбранный формат данных и характер нагрузки. Когда эти условия различаются, сравнение одной лишь скорости GPU легко превращается в сравнение совершенно разных способов выполнения задачи.
Заключение: скорость требует организации
cuBLAS и cuBLASLt показывают, почему производительность нельзя объяснить только характеристиками микросхемы: быстрые вычислительные устройства нуждаются в подходящем разбиении задачи, эффективной работе с памятью и разумном выборе реализации. Видеокарты NVIDIA предоставляют вычислительные возможности, а библиотека превращает их в операции, доступные приложениям.
cuBLAS даёт широкий набор базовых действий линейной алгебры, а cuBLASLt сосредоточена на гибком матричном умножении, настройке его выполнения и поддерживаемой обработке результата. Это не соревнование двух поколений одной функции: важна не только скорость отдельного произведения, но и то, насколько удачно оно встроено в последовательность вычислений.
