Что такое UALink — интерконнект, бросивший вызов NVLink
58
Статьи
Введение
Технология NVLink долгие годы была и остается самым передовым интерконнектом для ИИ и HPC-кластеров. Не столько ИИ-ускорители, не столько ПО-стэк CUDA, столько возможность связывать сотни и тысячи GPU в единое целое и дала Nvidia карт-бланш на монополизацию рынка графических вычислений, и почти никто не мог дать индустрии достойный ответ на эту доминацию. Но два года назад группа компаний, которая не стала это терпеть, организовавалась в Ultra Accelerator Link Consortium, чтобы дать миру новый, открытый стандарт внутристоечного интерконнекта, который будет не только конкурентоспособен, но и превзойдет NVLink в дальнейшей перспективе — UALink. Да, этот интерконнект появился уже давно, но до текущего момента он жил лишь на бумаге, пока в июле 2026 года AMD не представила передовые стойки Helios для объединения десятков ИИ-ускорителей в единую вычислительную среду, чего удалось добиться именно благодаря UALink. Так что, пришло время рассказать вам, что из себя представляет интерконнект UALink, как он работает, какие версии UALink существуют, сравним его с NVLink и объясним, куда будет развиваться открытый стандарт внутри стоечного соединения в ближайшем будущем.
Что такое UALink
UALink (Ultra Accelerator Link) — открытый стандарт высокоскоростного межсоединения, разработанный в 2024 году для прямого объединения ИИ-ускорителей (GPU, ASIC, FPGA) в пределах одного масштабируемого узла, то есть одной вычислительной стойки. Созданием UALink занимаются инженеры из консорциума Ultra Accelerator Link Consortium, в который вошли компании, больше всего нуждающиеся в открытом стандарте межсоединения для своих передовых вычислительных решений: разработчики ИИ-ускорителей AMD, Intel и Broadcom, облачные гиперскейлеры Google, Microsoft и Meta*, а также ведущие серверные вендоры HPE, Cisco, Lenovo и другие.
В отличие от Nvidia, которая продвигает NVLink как проприетарное, но жизненно необходимое решение, поддерживаемое только ИИ-ускорителями Hooper, Blackwell, Rubin и т.д..UALink нацелен на полную открытость, чтобы позволить компаниям уйти от монополии одного вендора, объединяя единым, унифицированным межсоединением ИИ-ускорители разных вендоров. Более того, универсальность UALink выходит за пределы “only-экосистем” (условно AMD-only, Intel-only) — в одной стойке могут соседствовать GPU от AMD, ASIC от Broadcom или TPU от Google, и это никак не будет препятствовать эффективности вычислений. До появления UALink каждый крупный игрок использовал либо собственные закрытые протоколы, либо выстраивал инфраструктуру вокруг NVLink, либо ограничивался универсальными шинами вроде PCIe/CXL, чья пропускная способность и задержки недостаточны для тесного объединения сотен вычислительных чипов. Сейчас же любая заинтересованная компания может взять открытые спецификации UALink, создать контроллеры UALink в своем кремнии и просто подключиться к стандартному коммутатору в стойке, не испытывая лицензионных тяжб и не завися от проприетарных технологий.

Схема подключения интерконнекта UALink. Источник: .
По сути, UALink сделал для мира ИИ-ускорителей то же, что PCI-Express когда-то сделал для обычных компьютеров: открытый, быстрый и не зависящий от одного вендора интерфейс, и эта концепция подкупает каждого.
PS: Конечно, в экосистеме Nvidia тоже есть технология, которая позволяет объединять сторонние ИИ-ускорители с железом зеленой компании — NVLink Fusion. Однако, это не та свобода, которую хотели ключевые вендоры на рынке ИИ-оборудования — интеграторам по-прежнему необходимо лицензировать интерконнект NVLink C2C у правообладателя, и технология все равно жестко привязана к ИИ-ускорителям и сетевым технологиям Nvidia. Это лишь компромисс для гибридных систем, а не открытый стандарт для свободного использования.

Схема работы UALink в системе с несколькими ускорителями. Источник: .
Как работает UALink
Суть UALink проста и изящна, но концепция на бумаге и аппаратная реализация — это не одно и то же. Давайте отбросим лирику и углубимся в технологический стэк UALink, чтобы разобраться, как унификация и эффективность межсоединения реализуется на практике.
- Топология. Ускорители подключаются не напрямую “каждый с каждым”, а через один или несколько центральных UALink-коммутаторов (UALink Switch). Коммутатор выполняет роль высокоскоростного кроссбара, арбитрирующего доступ к памяти всех подключенных устройств. Такая звездная или многоступенчатая коммутируемая топология обеспечивает полносвязное взаимодействие без экспоненциального роста числа линков и позволяет любому ускорителю обращаться к памяти любого другого с минимальным числом транзитных переходов.
- Прямой доступ к памяти. Ключевое архитектурное решение: UALink оперирует не сообщениями, а нативными инструкциями загрузки и сохранения в память удаленного узла. Когда вычислительному блоку на GPU A требуются данные, физически расположенные в HBM-памяти GPU B, он выполняет стандартную операцию load по виртуальному адресу, который через таблицу страниц отображается в адресное пространство удаленного устройства. Это полностью исключает программные прослойки сетевого стека и позволяет достичь задержек, характерных для внутрикристальных соединений, а не для традиционных сетевых протоколов.
- Единое когерентное адресное пространство. Все участники UALink-домена разделяют общее виртуальное адресное пространство. Аппаратный протокол когерентности (построенный на принципах, близких к MESI или MOESI, и адаптированный под сотни агентов) отслеживает состояние кэш-линий. Запись данных одним ускорителем мгновенно становится видимой остальным без явных инструкций синхронизации. Для разработчика это означает, что после завершения вычислений тензора на одном устройстве можно просто передать указатель на соседний ускоритель, и тот продолжит обработку, не ожидая копирования в промежуточный буфер.
- Атомарные операции между ускорителями. UALink реализует аппаратную поддержку атомарных операций чтения-записи на удаленной памяти — почти как RDMA, но на уровне линков внутри сервера, а не протокола. Это критично для распределенных коллективных операций, таких как All-Reduce: весовые градиенты от разных ускорителей могут суммироваться непосредственно в памяти целевого узла без сериализации доступа через единственный координатор. Коллективные обмены становятся низкоуровневой аппаратной функцией фабрики, а не программно-эмулируемой процедурой.
- Физические линии PAM4 и агрегация. Каждая дифференциальная линия связи использует четырех уровневую амплитудно-импульсную модуляцию PAM4, передавая два бита за символьный интервал. Несколько линий группируются в логические порты. Ускоритель, оснащенный четырьмя такими портами с пропускной способностью 200 Гбит/с каждый, получает агрегированную полосу в 800 ГБ/с. Коммутатор агрегирует порты со всех устройств и маршрутизирует трафик, опираясь на таблицы адресации памяти, что позволяет реализовать бесконфликтную передачу данных между парами ИИ-ускорителей.
Версии UALink
Эволюция стандарта идет полным ходом, но поэтапно: сначала закрепляется скоростной фундамент, затем вводятся умные механизмы обработки трафика, и только потом наращивается сырая пропускная способность.
- UALink 1.0. Спецификация утверждена в ноябре 2024 года. Обеспечивает до 200 Гбит/с на одну линию (112 Gbps PAM4) и до 1,6 ТБ/с на GPU. Максимальное количество устройств в одном когерентном домене — 1024. Физически опирается на электрические и оптические интерфейсы IEEE 802.3dj. Эта версия стандарта так и не была внедрена ни в один коммерческий аппаратный продукт.
- UALink 2.0. Спецификация опубликована в апреле 2026 года. Ключевым нововведением стала поддержка вычислений внутри сети (In-Network Compute). Теперь UALink-коммутаторы способны выполнять арифметические операции над транзитными данными — в первую очередь это касается операций редукции (суммирования градиентов, вычисления минимума/максимума). Это резко сокращает объем трафика и разгружает вычислительные блоки от рутинных коллективных обменов. Скорость линии осталась на уровне 200 Гбит/с и до 1,6 ТБ/с на GPU, а полоса на ускоритель — до 800 Гбит/с, однако протокол был серьезно оптимизирован: за счет конвейеризации управляющих сообщений и улучшенной арбитража буферов достигнуто существенное снижение задержек по сравнению с версией 1.0 (точные значения консорциум пока не раскрывает). UALink 2.0 будет использоваться в новейших ИИ-ускорителях AMD Instinct MI455X.
UALink vs NVLink
Прямое сравнение двух интерконнектов неизбежно, поскольку UALink создавался как альтернатива проприетарной технологии NVIDIA.
- Открытость и экосистема. NVLink жестко интегрирован в экосистему CUDA и доступен только для GPU NVIDIA, взаимодействующих через фирменные коммутаторы NVSwitch. UALink — открытая спецификация, которую могут реализовать любые производители ускорителей и коммутаторов. Это означает потенциальную возможность строить гетерогенные пулы (например, GPU + ASIC + FPGA) и использовать коммутаторы от разных поставщиков.
- Пропускная способность. NVLink 5.0 в составе NVIDIA Blackwell дает до 200 Гбит/с на линию и до 1,8 ТБ/с на GPU, что эквивалентно текущим 200 Гбит/с у UALink 1.0 и 2.0. Однако запланированный на 2027 год UALink 3.0, как ожидается, удвоит скорости до 400 Гбит/с и до 3,6 ТБ/с на GPU, что сравняет скорости с текущим флагманом NVIDIA NVLink 6.0 в GPU Rubin.
- In-Network Compute. Здесь UALink 2.0 догоняет NVLink. UALink-коммутатор с поддержкой спецификации 2.0 может производить суммирование градиентов “на лету”, разгружая как ускорители, так и межсоединение — точно также, как работают NVSwitch с помощью технологии Nvidia Sharp. Для рабочих нагрузок, завязанных на пропускную способность редукций, это дает эффективный выигрыш даже при меньшей пиковой полосе.
- Программная зрелость. Главное слабое место UALink сегодня — софтверная поддержка. Библиотеки коллективных операций (NCCL), фреймворки (PyTorch, JAX), профилировщики NVIDIA знают топологию NVLink и умеют планировать передачи оптимальным образом. Для UALink аналогичный уровень автоматической оптимизации еще предстоит создать, и ближайшие годы уйдут на интеграцию с открытыми библиотеками коллективных обменов. Тем не менее, поддержка со стороны AMD ROCm, стэк которого в последнее время значительно окрепнет, может кратно ускорить адаптацию UALink в программной экосистеме.
Таким образом, UALink уступает NVLink в пиковой пропускной способности и зрелости ПО, но выигрывает в открытости, гибкости и архитектурной инновации в виде вычислений внутри сети.
Связь UALink и Ultra Ethernet
UALink закрывает уровень масштабирования “вверх” (scale-up) внутри одного вычислительного узла, где требуется когерентная память и экстремально низкие задержки. Когда же необходимо объединить сотни и тысячи таких узлов в единый кластер, в дело вступает Ultra Ethernet — открытый стандарт сетевого взаимодействия (scale-out), продвигаемый консорциумом Ultra Ethernet Consortium, в который также входят многие члены консорциума UALink.
Связка UALink + Ultra Ethernet образует полный открытый коммуникационный стек для ИИ-инфраструктуры: внутри стойки ускорители общаются через UALink, как если бы они были единым многочиповым модулем, а между стойками данные передаются по Ultra Ethernet с оптимизированными профилями под коллективные операции и RDMA. Оба стандарта развиваются скоординированно, что позволяет проектировать системы без “бутылочных горлышек” при переходе с intra-node на inter-node соединения. Интересно, что развитием Ultra Ethernet также занимается и Nvidia, активно интегрируя протокол Ethernet-линейке коммутаторов Spectrum-X. Это связано с тем, что Ultra Ethernet — это более гибкая технология, которая легко интегрируется с существующими Ethernet-сетями, в отличие от проприетарного InfiniBand, который компания все еще активно развивает в Nvidia-only инфраструктурах.
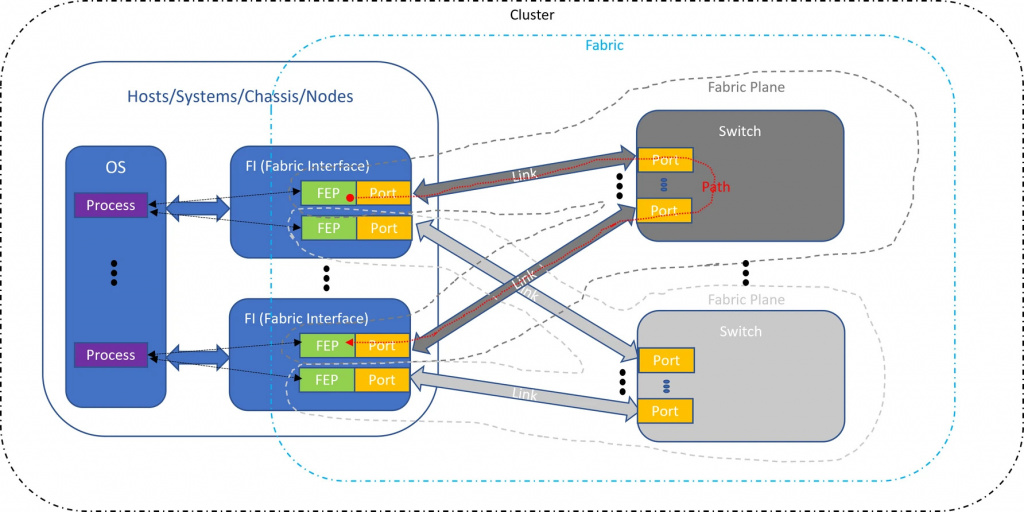
Схема работы сетевой инфраструктуры на базе Ultra Ethernet. Источник: .
Будущее интерконнекта UALink
Ближайший рубеж — выход UALink 3.0 в 2027 году, который принесет удвоение скорости линий до 400 Гбит/с. Это поставит открытый стандарт в один ряд с передовыми проприетарными решениями, такими как NVLink 6.0 с 400 Гбит/с на одну линию. Дальше развитие пойдет по пути углубления возможностей In-Network Compute: коммутаторы научатся выполнять более сложные операции (умножение матриц, применение нелинейностей), превращая фабрику в распределенный вычислительный конвейер. Параллельно продолжится интеграция с экосистемой CXL и сближение с Ultra Ethernet в части унифицированной телеметрии. Если софтверная поддержка UALink в ведущих фреймворках достигнет зрелости, открытый стек “UALink + Ultra Ethernet” рискует стать стандартом де-факто для крупнейших ИИ-инсталляций следующего десятилетия.
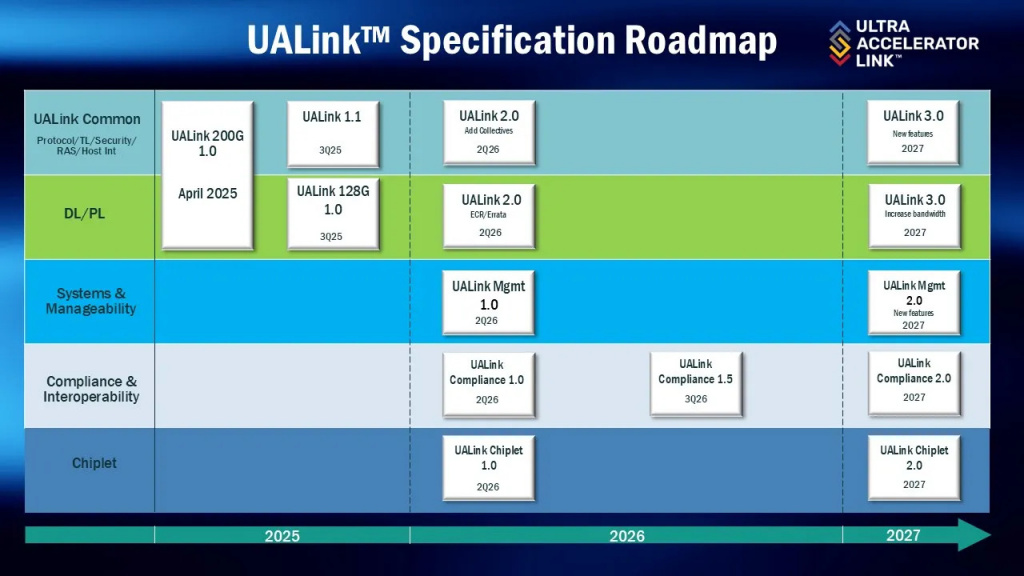
Дорожная карта интерконнекта UALink. Источник: .
Выводы
UALink — это одна из немногих технологий, которая напрямую бросила вызов доминации NVLink в сегменте внутристоечных межсоединений. Несмотря на то, что в данный момент UALink отстает от NVLink по скоростям, нужно сделать скидку на возраст интерконнекта — проприетарный NVLink развивается уже более 12 лет, тогда как открытый UALink существует всего 2 года и уже предлагает интеграторам уникальные возможности, такие как вычисления в сети, которых нет даже в экосистеме Nvidia. В дальнейшей перспективе, когда консорциум выпустит UALink 3.0, отставание от NVLink значительно сократится.
*Деятельность Meta Platforms Inc. в России признана экстремистской и запрещена
