Архитектура инференса нового поколения: как устроен и работает NVIDIA NIM
Введение
Когда индустрия искусственного интеллекта преодолела этап первого восторга перед генеративными возможностями больших моделей, инженеры столкнулись с суровой реальностью. Запустить сеть в блокноте с помощью пяти строк кода оказалось просто. Однако перевод той же модели в надежную промышленную эксплуатацию стал для сотен команд настоящей инфраструктурной стеной.
Вывод современных трансформеров требует колоссальных мощностей, тонкой настройки низкоуровневых библиотек, аккуратного управления видеопамятью и сложной оркестрации. Именно для устранения этой пропасти компания NVIDIA представила NIM – NVIDIA Inference Microservices. Это готовые OCI-контейнеры для инференса: внутри – выбранный движок, профиль под GPU и OpenAI-совместимый API. Открытые библиотеки никуда не делись, NIM их упаковывает и фиксирует версии, чтобы один и тот же сценарий работал от RTX до серверного кластера.
Почему инференс оказался сложнее обучения
На старте бума генеративного ИИ инвестиции шли прежде всего в обучение. Компании соревновались объемами выборок, размерами GPU-кластеров и сотнями миллиардов параметров. Жизненный цикл прикладной системы устроен иначе: обучение происходит периодически, а инференс создает круглосуточную нагрузку на серверы годами. Именно поэтому стоимость и сложность вывода быстро обогнали романтику первого запуска модели.
Инференс генеративных сетей кардинально отличается от классических микросервисов. Здесь нельзя обойтись Python-скриптом за балансировщиком нагрузки. Генерация каждого следующего токена зависит от всех предшествующих, и это формирует KV-кэш, чей объем растет вместе с длиной ответа, размером контекста и числом параллельных диалогов. Без строгого контроля памяти GPU неминуемо падает с ошибкой Out Of Memory.
Вторая ловушка – фрагментация программного стека. Чтобы выжать максимум скорости, inference runtime необходимо оптимизировать под конкретную архитектуру GPU, формат весов, точность вычислений и схему параллелизма. Для разных конфигураций используются разные ядра, числовые форматы и профили исполнения. Инженеру приходится связывать CUDA, cuDNN, TensorRT, FlashAttention и сервер очередей. Ошибка в версиях компонентов легко снижает пропускную способность в разы, даже если «на бумаге» железо выглядит избыточным.
Третий конфликт лежит между задержкой и пропускной способностью. В боевых сервисах одновременно важны время до первого токена, определяющее отзывчивость интерфейса, и скорость генерации последующих токенов. Балансировка между ними требует динамического планирования запросов, а не наивного ожидания полного пакета. Самостоятельная сборка такого production-стека для многих команд превращалась в бесконечное профилирование ядер и отладку сбоев.
Что скрыто внутри контейнера NIM
NVIDIA подошла к задаче системно, задействовав главное преимущество компании – вертикальный контроль над кремнием и программным обеспечением. NIM представляет собой стандартизированный контейнер формата OCI с полным комплексом для быстрого исполнения модели. Разработчик получает не «голый» интерпретатор, а заранее согласованный runtime, который знает, на каком железе он запущен.
В современных NIM для языковых моделей контейнер объединяет inference backend с инфраструктурным слоем NVIDIA. В основной ветке NIM LLM 2.x центральную роль играет vLLM: он загружает модель, управляет GPU-инференсом, KV-кэшем и планированием запросов. Перед ним работает лёгкий proxy, отвечающий за маршрутизацию, health checks, TLS и другие эксплуатационные функции. Для отдельных образов NVIDIA также поддерживает другие backend, включая SGLang и TensorRT-LLM.» Актуальный NIM 2.x следует принципу «один контейнер – один backend
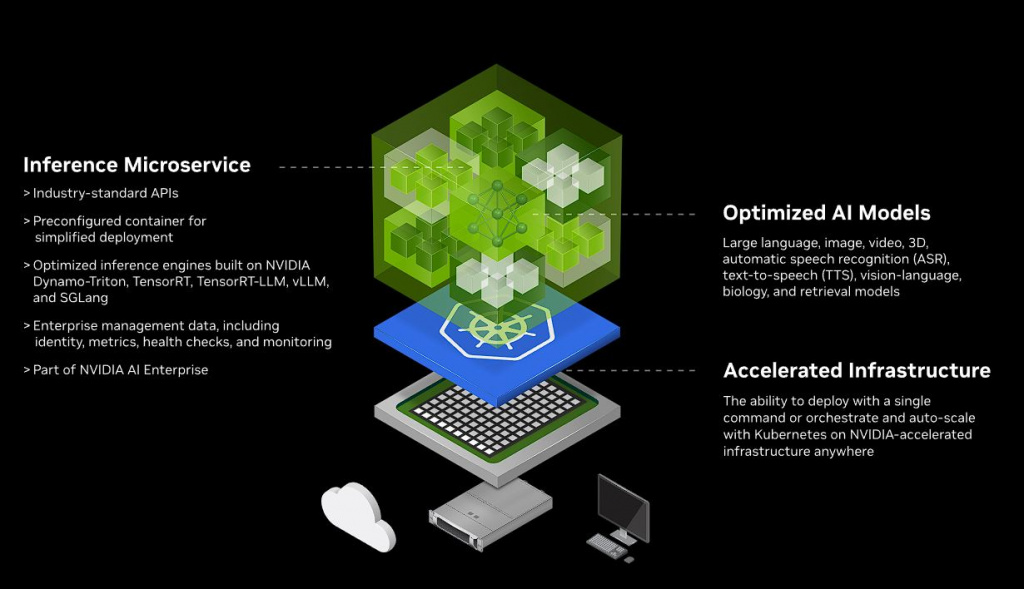
Архитектурная инфографика NVIDIA NIM. Источник:
При старте контейнер сам профилирует оборудование. На потребительской видеокарте RTX он включает ядра FP16 или INT4 и экономит видеопамять. На серверных чипах H100 или B200 в работу вступают блоки Transformer Engine с поддержкой FP8, шины NVLink и межпроцессорный параллелизм. Один и тот же образ ведет себя по-разному не потому, что «магия контейнеров», а потому что профиль исполнения выбирается под конкретный кремний.
Не менее важна унификация интерфейса. До NIM мир открытых моделей страдал от зоопарка JSON-схем, нестандартных эндпоинтов и самодельных веб-сокетов. Микросервис нативно реализует спецификацию OpenAI API, поэтому существующий корпоративный софт часто переключается сменой базового адреса. Через HTTP доступны потоковые ответы в формате Server-Sent Events, векторизация текста для поиска и RAG, а также выдача метаданных модели. NIM предоставляет OpenAI-совместимый HTTP API с поддержкой потоковой выдачи ответов, поэтому многие существующие клиенты можно переключить на локальный endpoint без существенной переработки прикладного слоя.
Образ отделяет исполняемый код от параметров сети. Контейнер несет логику вычислений и скомпилированные ядра, а веса подгружаются из локального кэша или защищенного реестра NVIDIA NGC. Такое разделение уменьшает размер базовых образов, упрощает обновления и закрывает типичную дыру безопасности: непроверенный сторонний код больше не путешествует вместе с весами в одном непрозрачном архиве.
Как NIM выжимает железо
Высокая производительность в NIM следствие конкретных алгоритмов на стыке софта и архитектуры чипа. Классический пакетный режим объединяет запросы в батч и заставляет видеокарту ждать самого длинного из них, даже если короткие ответы уже готовы. In-Flight Batching планирует работу на уровне отдельных шагов итерации. Как только один запрос завершил выдачу токенов, освободившиеся ресурсы сразу отдаются новому входящему клиенту. GPU перестает простаивать между «короткими» и «длинными» диалогами.
Отдельная история – память контекста. Непрерывное выделение пространства под диалог быстро ведет к фрагментации. PagedAttention режет KV-кэш на небольшие страницы виртуальной памяти по аналогии с диспетчером операционной системы и позволяет задействовать практически весь доступный видеобуфер без падения из-за дыр в адресном пространстве. К этому добавляется контекстное кэширование: если пользователи приходят с одним и тем же системным промптом, ключи и значения общей части считаются один раз, а следующие запросы берут уже готовое состояние. Время до первого токена падает не за счет «магии модели», а за счет повторного использования вычислений.
Квантование закрывает другую узкую горловину – пропускную способность памяти. Хранить веса в полной точности на современных моделях расточительно. NIM поставляет профили, откалиброванные под семейства видеокарт. На Hopper, Blackwell и серверных Ada (L40, L40S) NIM опирается на FP8 и Transformer Engine: шире динамический диапазон, меньше порчи логики, чем у старого INT8. На GeForce RTX, хотя это тоже Ada, чаще берут FP16 или 4-бит AWQ, чтобы модель влезла в память игровой карты, а не требовала L40.
Для инженера, который привык собирать стек вручную, здесь важна не только скорость бенчмарка, но и предсказуемость. Профиль квантования, размер страницы кэша и политика батчинга не размазаны по пяти репозиториям и трём переменным окружения: они уже согласованы внутри образа. Это не отменяет необходимости понимать, что происходит под капотом, но резко сокращает число способов сломать сервис до первого рабочего запроса.
Какие модели живут в этой экосистеме
NIM давно вышел за пределы текстовых чат-ботов. Платформа становится шлюзом к мультимодальным системам, где один и тот же способ доставки обслуживает разные классы задач. В каталоге есть ведущие открытые языковые модели семейств Llama, Mistral, Gemma, Qwen и Phi, а также собственные сети NVIDIA Nemotron, заточенные под синтез данных и агентные сценарии. Рядом с ними стоят визуально-языковые трансформеры, которые разбирают изображения, документы, графики и схемы.
Для корпоративного поиска важны не только генераторы, но и модели эмбеддингов вместе с реранкерами линейки NeMo Retriever: они образуют ядро RAG-контуров и внутренних баз знаний. Отдельный пласт – BioNeMo, где те же принципы упаковки применяются к предсказанию структуры белков и поиску лекарственных соединений. Идея одна: модель перестает быть набором файлов на диске и становится сервисом с предсказуемым API.
Переносимость здесь не маркетинговый эпитет. Один и тот же подход работает на локальном RTX AI PC под Linux или WSL2, когда нужно отладить интеграцию без счета за облако. Тот же контейнер поднимается на выделенном сервере через Docker Compose или Ansible, появляется в каталогах AWS, GCP, Azure, Oracle Cloud и профильных GPU-провайдеров, а в Kubernetes раскатывается официальными Helm-чартами с поддержкой KServe и горизонтального автомасштабирования. Код клиента почти не меняется: меняется только то, где крутится endpoint.
NIM на практике
Инженерная рутина сжимается до нескольких системных вызовов. Сначала выполняется вход в реестр NGC с токеном разработчика, затем контейнер запускается с пробросом GPU, общим сегментом памяти, ключом NGC и томом для кэша весов. Образ сам сверяет конфигурацию CUDA, подтягивает верифицированные веса и поднимает веб-сервер. Типичная команда выглядит так:
echo "$NGC_API_KEY" | docker login nvcr.io \
  --username '$oauthtoken' --password-stdin

docker run -d --name nim-service --gpus all --shm-size=16g \
  -e NGC_API_KEY=$NGC_API_KEY \
  -v /var/cache/nim:/opt/nim/.cache -p 8000:8000 \
  nvcr.io/nim/meta/llama-3.1-8b-instruct:latest
На стороне приложения достаточно клиента, который умеет говорить на диалекте OpenAI. Базовый адрес указывает на локальный порт, ключ для изолированного инстанса часто формален, а поток токенов читается привычным циклом по chunk. Ниже – минимальный каркас на Python:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="none")
stream = client.chat.completions.create(
    model="meta/llama-3.1-8b-instruct",
    messages=[
        {"role": "system", "content": "Ты системный инженер."},
        {"role": "user", "content": "Опиши принципы работы непрерывного батчинга."},
    ],
    temperature=0.3,
    stream=True,
)
for chunk in stream:
    print(chunk.choices[0].delta.content or "", end="", flush=True)
Именно эта скучная совместимость и есть главная практическая ценность. Команда не переписывает весь прикладной слой под новый SDK: она меняет адрес сервиса и начинает получать локальную потоковую генерацию с предсказуемой задержкой.
Безопасность, шаблоны и деньги
В реальном бизнесе запуск изолированной модели – только первый шаг. Дальше появляются инъекции в промпт, галлюцинации, утечки персональных данных и необходимость склеить несколько сервисов в один контур. Здесь NIM работает как кирпич, а не как готовый продукт целиком. NeMo Guardrails садится шлюзом на вход и выход диалога: отсекает jailbreak, держит модель в тематических рамках и снижает риск утечки чувствительных фрагментов. NVIDIA Blueprints дают эталонные архитектуры, в которых генерация, эмбеддинги, реранкинг и векторная СУБД уже связаны проверенным шаблоном, а не собраны на коленке. Для банков, медицины и госсектора критична возможность air-gapped режима: контейнер живет в закрытом контуре, и веса вместе с пользовательскими данными не уезжают во внешнее облако.
Модель доступа двухконтурная. Программа NVIDIA Developer позволяет бесплатно скачивать контейнеры для прототипов, учебы и некоммерческих экспериментов, а на портале часто выдают облачные кредиты, чтобы пощупать hosted-эндпоинт без локальной сборки. Условия использования зависят от варианта NIM. Обычные NIM доступны без отдельной платы по соответствующей лицензии и ориентированы на быстрый доступ к новым моделям. NIM Certified Feature Branch также может использоваться без отдельной платы, однако корпоративная поддержка требует NVIDIA AI Enterprise. NIM Certified Production Branch, предназначенный для стабильных и критичных production-систем, требует активной подписки NVIDIA AI Enterprise. Она оплачивается по числу GPU либо почасово в облаке и приносит то, чего нет у «скачал и запустил»: патчи уязвимостей базовых образов, доступ к LTS-веткам и поддержку от людей, которые пишут компиляторы, а не только обёртки вокруг них.
Заключение: Зачем это индустрии
NVIDIA NIM фиксирует момент, когда прикладной искусственный интеллект перестал быть набором хрупких пайплайнов вокруг открытых весов. Когда-то Docker стандартизировал запуск программ, а Kubernetes – управление ими. NIM делает следующий шаг и стандартизирует эксплуатацию нейросетевых моделей: один контейнер, знакомый API, профиль под конкретное железо и предсказуемый путь от ноутбука разработчика до кластера. Для команд, которые уже используют vLLM, SGLang или другие inference engines, NIM не вводит принципиально новый способ выполнения модели. Он предоставляет валидированный контейнер, профили оборудования, унифицированный API и эксплуатационный слой вокруг конкретного backend. Разница ощущается не в «ещё одном чате», а в том, сколько ночей больше не уходит на согласование драйвера, компилятора и формата весов перед релизом. Иными словами, платформа продаёт не новую архитектуру сети, а снижение операционного трения на пути к промышленному релизу.
Для инженера это означает смену фокуса. Вместо бесконечной борьбы с версиями CUDA, ручной сборкой TensorRT и ночными падениями из-за фрагментации KV-кэша можно заниматься продуктовой логикой, качеством ответов и безопасностью контура. Заботу о тактах GPU платформа берет на себя – ровно в той мере, в какой вендор железа вообще способен обещать производительность, а не только README.
