Z.ai выпустила GLM-5.3 — ИИ-модель с открытым исходным кодом на 753B параметров и фокусом на кодинг
Введение
Z.ai представила GLM-5.3 — новую модель с открытыми весами, которая приходит на смену GLM-5.2. Ключевая особенность релиза в том, что базовая архитектура осталась прежней: все улучшения достигнуты исключительно за счет пост-тренировки. Это позволило значительно усилить сложное программирование, длинные автономные задачи и, что особенно примечательно, кибербезопасность. Модель использует DeepSeek Sparse Attention для эффективной работы с длинным контекстом. При общем объеме 753 млрд параметров активируются лишь 40 млрд на токен, а контекстное окно расширено до 1 млн токенов с генерацией до 128K. GLM-5.3 уже называют самой способной открытой моделью для кодирования, а в ряде бенчмарков она вплотную приближается к закрытым флагманам.
Подробнее о GLM-5.3
Архитектурно GLM-5.3 повторяет GLM-5.2, включая использование DeepSeek Sparse Attention, которая снижает стоимость обработки длинных последовательностей. Однако пост-тренинг был проведен на новом уровне, что дало скачок в качестве. Во внутреннем бенчмарке Z.ai Code Bench прирост составил 50% по сравнению с GLM-5.2. На публичных тестах модель показывает открытый SOTA: Terminal Bench 3.0 — 28.3 против 4.6 у GLM-5.2, Terminal Bench 2.1 — 88.2 (против 81.0), DeepSWE v1.1 — 66.9 (против 46.2), SWE-Marathon — 42.5 (против 19.4). В NL2Repo результат 58.0, что на уровне Kimi K3 и выше GLM-5.2.
Особого внимания заслуживает кибербезопасность, где способности выросли быстрее, чем ожидали разработчики. На CyberGym модель набирает 84.5, устанавливая новый уровень для открытых моделей и опережая даже Opus 4.8 (78.1) и Fable 5 (83.8). Еще более впечатляет прогресс в эксплуатации уязвимостей: ExploitBench поднялся с 24.4 до 54.4, а ExploitGym за 2 часа — с 29 до 105, за 6 часов — с 39 до 130. Это более чем двукратное улучшение по сравнению с GLM-5.2.
Агентные возможности также усилены: Toolathlon Verified вырос с 59.9 до 73.0, AutomationBench — с 26.2 до 48.2, Agents' Last Exam — с 23.8 до 28.5. В HLE w/ Tools модель достигла 62.5 против 54.7 у предыдущей версии. GDPval-AA v2 поднялся с 1508 до 1769, что выше Qwen3.8-Max (1739) и DeepSeek-V4 Pro-0813 (1590), хотя и уступает Fable 5 (1743) и GPT-5.6 Sol (1730).
Важно, что все эти улучшения достигнуты без изменения базовой модели — только за счет пост-тренировки. Это подчеркивает растущую роль этапа дообучения в современных LLM и демонстрирует, что даже без масштабирования параметров можно добиться значительного прогресса.
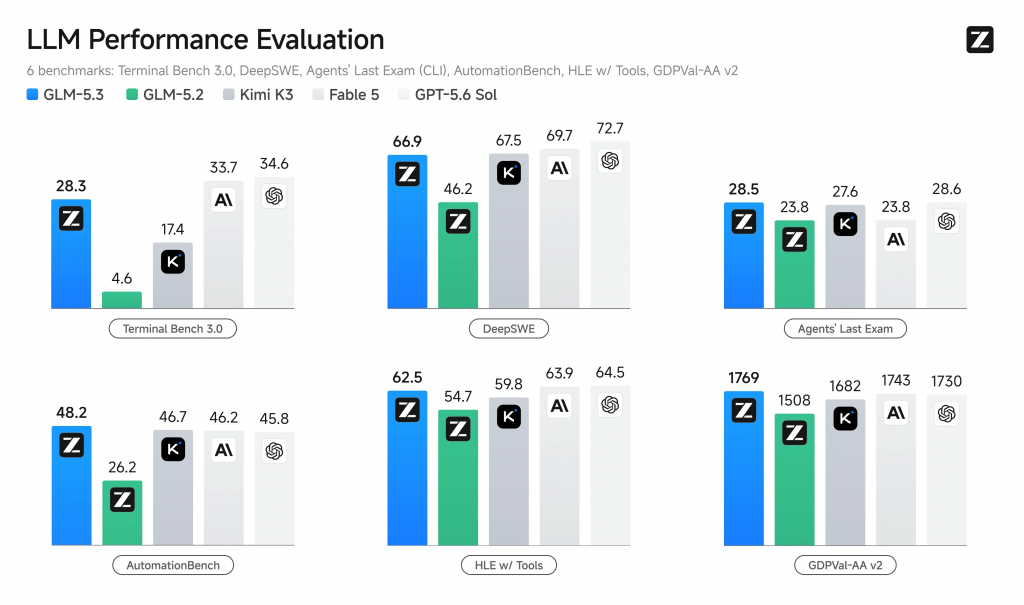
Результаты тестирования GLM-5.3. Источник: .
Выводы
GLM-5.3 показывает, что пост-тренинг становится самостоятельным и мощным инструментом развития моделей, а не просто финальной шлифовкой. Удержание той же базы с таким скачком производительности ставит под сомнение прежние представления о том, что для прогресса необходимо наращивать параметры. Для открытого сообщества это особенно ценно: теперь доступна модель, которая конкурирует с закрытыми фронтирами в кодировании, агентных задачах и кибербезопасности, оставаясь при этом полностью открытой. Резкий рост в области эксплуатации уязвимостей вызывает вопросы о двойном назначении, но также открывает возможности для создания более эффективных защитных инструментов. GLM-5.3 укрепляет позиции Z.ai в гонке открытых моделей, где Kimi K3, DeepSeek-V4 Pro и Qwen3.8-Max уже задали высокую планку. Если тренд на усиление пост-тренировки продолжится, следующее поколение может приблизиться к паритету с лучшими закрытыми системами без пропорционального увеличения вычислительных затрат.
