SambaNova SN50 — RDU пятого поколения с dataflow-архитектурой и технологией MBU
Введение
На Hot Chips 2026 компания SambaNova раскрыла технические детали своего ускорителя SN50 — пятого поколения реконфигурируемых dataflow-процессоров (RDU), ориентированных на инференс с акцентом на декодирование. SN50 был анонсирован ранее в этом году и уже привлек внимание благодаря партнерству с Intel, которая использует RDU для дополнения собственного ИИ-стека. Главная особенность SN50 — архитектура dataflow, в которой вычисления и перемещение данных управляются программно, без аппаратного менеджера памяти, что обеспечивает высокую утилизацию пропускной способности HBM даже при масштабировании на сотни чипов. SambaNova утверждает, что SN50 достигает Model Bandwidth Utilization (MBU) около 45% в конфигурации из 256 RDU, а в тестах DeepSeek утилизация полосы для загрузки экспертов приближается к 80%. Реальные замеры Artificial Analysis показывают свыше 750 токенов в секунду на модели MiniMax M2.7.
Подробнее о SN50
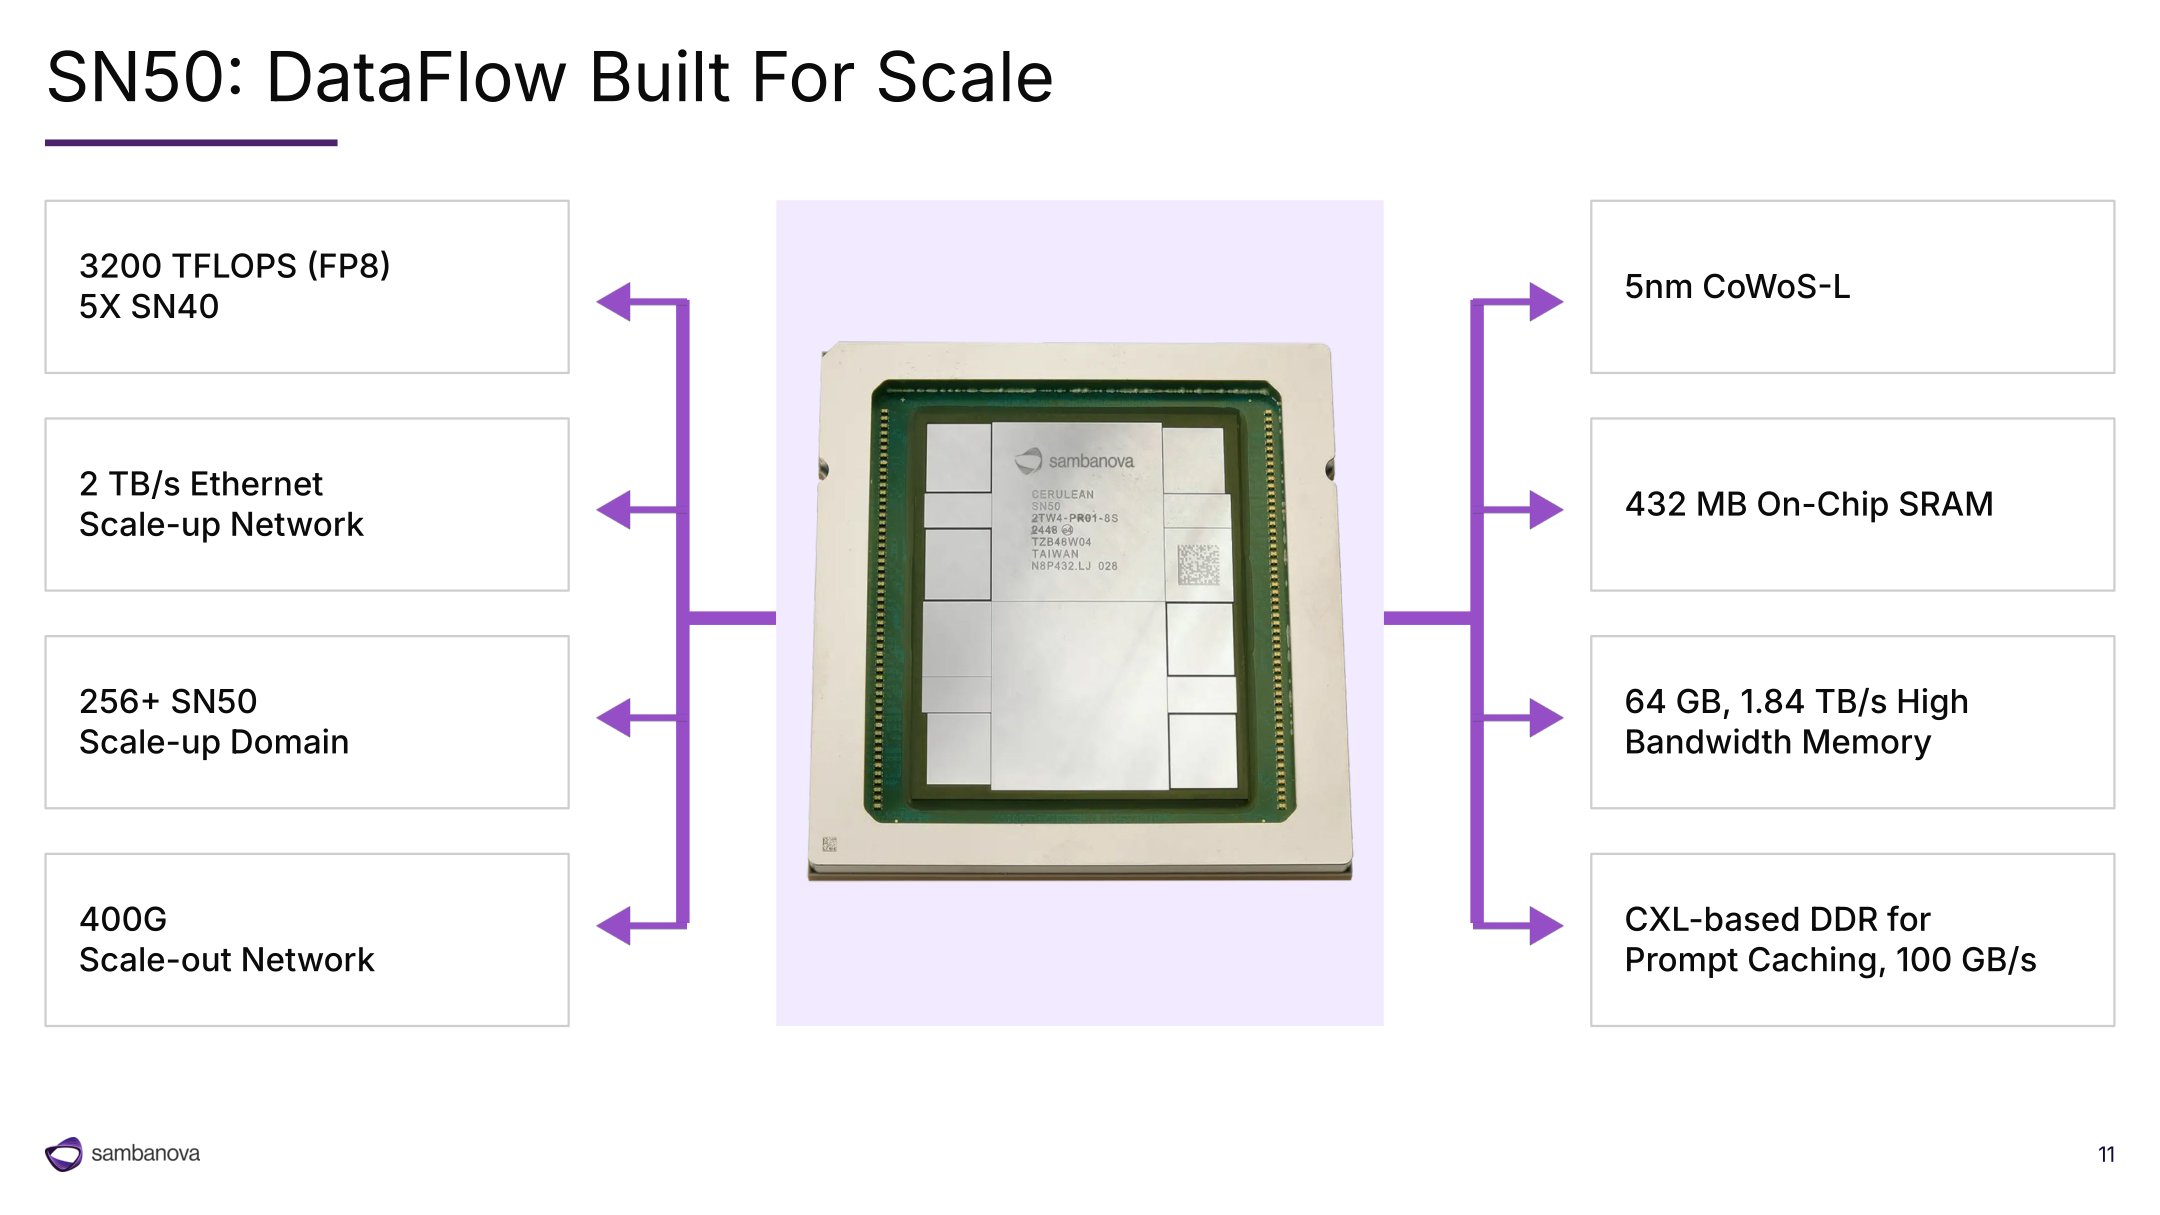
SN50 построен на двух максимальных по размеру кристаллах логики, без отдельных кристаллов ввода-вывода, и оснащен стеками памяти HBM2e. Хотя выбор HBM2e устаревшего стандарта вызывает вопросы на фоне HBM3e у конкурентов, он позволил сбалансировать стоимость и зрелость поставок. В отличие от GPU, где управление памятью частично аппаратное, SN50 полностью программно управляет потоками данных: тысячи вычислительных ядер (PCU) и ядер памяти (PMU) обмениваются информацией по готовности, без глобальной синхронизации. Это дает детерминированное исполнение и эффективное перекрытие вычислений и коммуникаций.
Центральная метрика, которую продвигает SambaNova, — Model Bandwidth Utilization (MBU). В отличие от простого измерения занятости полосы HBM, MBU показывает, какая доля полосы идет на полезную работу с данными модели, а не на служебные операции. По данным компании, у GPU этот показатель низок и падает с ростом числа ускорителей, тогда как SN50 удерживает MBU около 45% даже на 256 чипах. Это достигается за счет возможности пересылать данные напрямую между SRAM разных RDU, минуя HBM.
Масштабирование SN50 реализовано двухуровневой сетью: scale-up на 800GbE и scale-out на 400GbE. Для восьми сокетов используется all-to-all топология без коммутаторов. При переходе к 64 чипам применяются Ethernet-коммутаторы с объединенными линками, а конфигурации до 512 сокетов задействуют оба уровня. Такая архитектура поддерживает все виды модельного параллелизма: тензорный, экспертный и конвейерный. В тестах DeepSeek с tensor parallel 32 и expert parallel на 64 сокетах утилизация полосы при загрузке экспертов достигала близких к 80% значений.
Производительность GEMM на SN50 стабильно превышает 70% утилизации даже на 32 сокетах. Ключевое преимущество — способность перекрывать вычисления и коллективные коммуникации, что недоступно GPU в той же мере. В сценарии гетерогенной дезагрегации SambaNova использует NVIDIA H200 для префилла и SN50 для декодирования, соединяя их через RoCE. На бенчмарке Artificial Analysis SN50 показал более 750 токенов в секунду на модели MiniMax M2.7.
Выводы
SambaNova SN50 делает ставку на то, что для инференс-нагрузок, где доминирует decode-фаза, критична не пиковая вычислительная мощность, а способность эффективно использовать полосу памяти. Dataflow-архитектура с программным управлением данными позволяет удерживать высокую Model Bandwidth Utilization даже при масштабировании на сотни чипов, что напрямую бьет по слабому месту GPU. Сотрудничество с Intel усиливает рыночные позиции SN50, предоставляя гиперскейлерам альтернативу для низколатентного инференса больших моделей. Однако использование HBM2e и отсутствие собственного scale-out решения могут стать ограничением в долгосрочной перспективе, когда требования к пропускной способности продолжат расти. Тем не менее, показатели MBU и реальная скорость токенов делают SN50 одним из самых интересных специализированных ускорителей для инференса на рынке.
