Qwen3.8-Flash-Next — новая открытая ИИ-модель на архитектуре Qwen4 со 125 миллиардами параметров
Введение
Команда Alibaba представила Qwen3.8-Flash-Next — первую открытую модель на экспериментальной архитектуре, которая ляжет в основу будущего поколения Qwen4. Новинка переосмысливает взаимодействие ключевых компонентов современных LLM, делая упор на эффективность масштабирования и работу с длинными контекстами. Модель содержит 125 миллиардов общих параметров, но активирует лишь 6 миллиардов на запрос, и имеет дополнительные 51 миллиардами параметров n-грамм эмбеддингов и 4 миллиардов параметров для многошагового прогнозирования. Благодаря гибридному вниманию с Qwen Sparse Attention, Gated Residual и N-gram Embedding удалось достичь значительного снижения задержек на длинных последовательностях при сохранении качества, сравнимого с более тяжелыми моделями. Веса опубликованы на Hugging Face.
Подробнее о Qwen3.8-Flash-Next
Архитектурно Qwen3.8-Flash-Next развивает подход, заложенный в Qwen3.5 и Qwen3.8, но с тремя ключевыми инновациями. Первая — гибридное внимание, в котором пара Gated DeltaNet и Gated Attention заменена на Gated DeltaNet и Qwen Sparse Attention (QSA). Вместо выбора отдельных токенов QSA оперирует на уровне микро-блоков, что резко сокращает задержки при обработке длинных контекстов. Это особенно важно для агентных нагрузок, где окна в сотни тысяч токенов становятся нормой. Вторая инновация — Gated Residual. Остаточные потоки с нормализацией, обеспечивающие стабильность глубоких сетей, дополнены управляемыми воротами: поэлементный data-dependent read gate и скалярный write gate на каждую ветку. Это дает более тонкую экспрессивность между слоями без роста накладных расходов на инференс. Третья — N-gram Embedding. Вместо расширения Mixture-of-Experts для масштабирования параметров используется индексация коротких n-грамм (биграмм и триграмм) на уровне 20 млн эмбеддингов. Такой подход позволяет наращивать параметрическую емкость с меньшими вычислительными затратами и лучше подходит для устройств с ограниченной памятью.
Модель содержит 48 слоев, скрытую размерность 2560 и словарь на 248 320 токенов. Слой Mixture-of-Experts включает 512 экспертов, из которых на каждый токен активируются 10 маршрутизируемых и 1 общий. Нативная длина контекста — 262 144 токена с возможностью расширения до 1 000 000 токенов. Для инференса используются два оптимизатора: Muon и AdamW применяются к разным категориям весов, что повышает эффективность обучения. Благодаря обновленным законам масштабирования удалось отказаться от традиционного разогрева batch size и начинать сразу с целевого значения, существенно сокращая число шагов оптимизатора при безопасной поддержке больших learning rate.
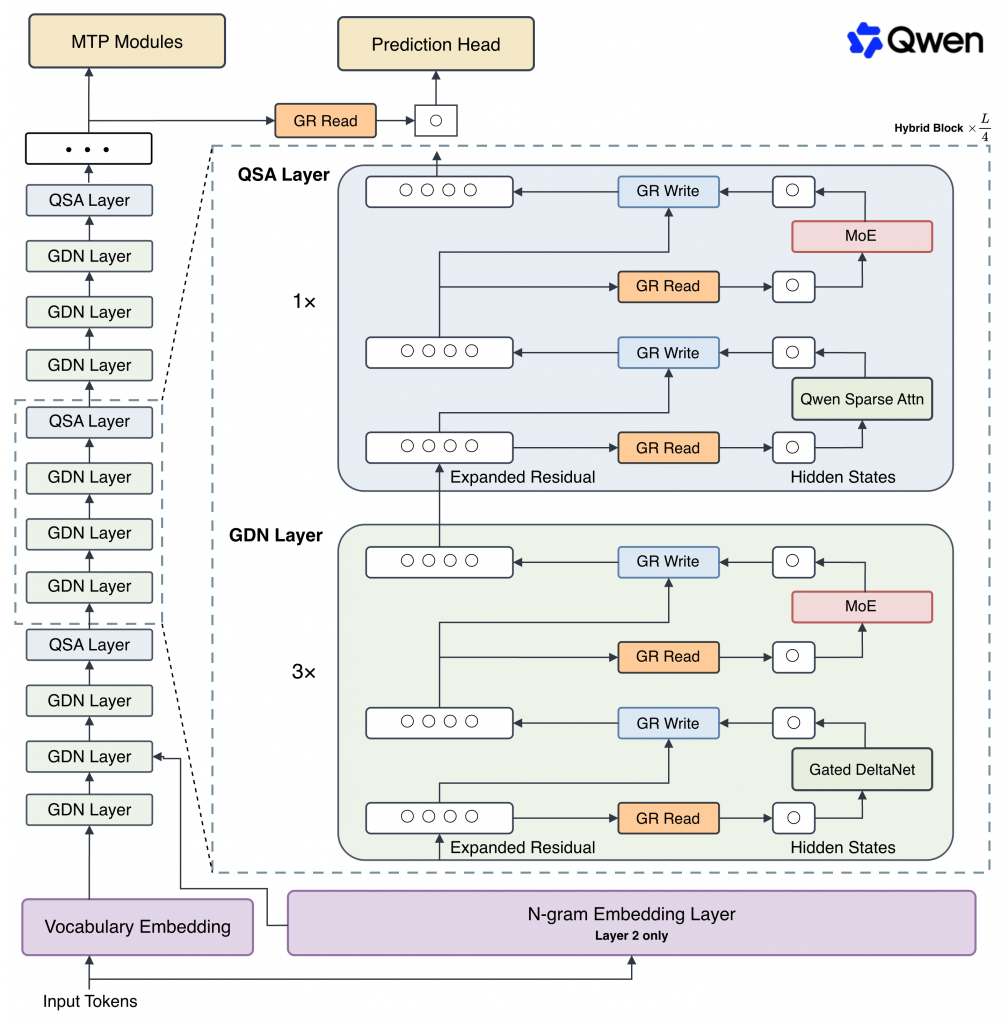
Архитектура Qwen3.8-Flash-Next. Источник: .
В результатах тестов Qwen3.8-Flash-Next демонстрирует значительный прогресс. В агентном кодировании DeepSWE 1.1 модель набирает 58,7, опережая Qwen3.8-27B (42,2), Qwen3.7-Plus (16,5) и DeepSeek-V4-Flash-0731 (54,4). SWE-bench Pro результат 62,5 — выше Qwen3.8-27B (61,7) и Qwen3.7-Plus (55,8). В SWE-bench Multilingual достигнуто 81,0 против 73,8 у Qwen3.8-27B и 77,5 у Claude Opus 4.6. В генерации кода NL2Repo-Bench — 48,1, уступая только DeepSeek-V4-Flash-0731 (54,2). Агентные способности также усилены: CoWorkBench 73,9 (против 70,7 у Qwen3.8-27B и 68,2 у Opus 4.6), JobBench 55,7 (против 33,4 у Qwen3.8-27B и 36,6 у Opus 4.6), Agents' Last Exam Pass@1 24,3 и Score 51,2 (против 20,4/42,9 у Qwen3.8-27B и 13,2/33,6 у Qwen3.7-Plus). В использовании инструментов Toolathlon Verified набрано 73,5, уступая лишь Opus 4.6 (76,2). В общих задачах: IFBench 81,3 (выше Opus 4.6 62,5), GPQA Diamond 91,7 (на уровне Opus 4.6 91,3), HLE 35,9 (против 40,0 у Opus 4.6), LiveCodeBench v6 91,9 (выше Opus 4.6 88,8).

Результаты тестирования Qwen3.8-Flash-Next. Источник: .
Выводы
Qwen3.8-Flash-Next — это в первую очередь экспериментальная проверка архитектурных решений, которые будут использоваться в Qwen4. Сочетание QSA, Gated Residual и N-gram Embedding демонстрирует, что эффективность длинного контекста и масштабируемость параметров могут быть достигнуты без раздувания активных вычислений. При 125 миллиардах общих и 6 миллиардах активных параметров модель конкурирует с системами, активирующими в разы больше, а по ряду агентных бенчмарков опережает даже значительно более крупные Qwen3.7-Plus и DeepSeek-V4-Flash. Это открывает путь к экономичным развертываниям сложных агентов на более легком железе.
