NVIDIA представила Nemotron 3.5 Super VL — открытая мультимодальная модель на 120 млрд параметров для ИИ-агентов
Введение
NVIDIA представила Nemotron 3.5 Super VL — открытую мультимодальную модель для корпоративных ИИ-агентов. Она построена на архитектуре MoE со 120 млрд параметров, из которых на токен активируется 12 млрд, и объединяет рассуждения, вызов инструментов и понимание текста, изображений, документов и видео. По данным NVIDIA, на одном GPU модель выдает более 600 токенов в секунду — до пяти раз больше, чем открытые аналоги ее класса. Контекстное окно нейронки достигает 1 млн токенов. Веса доступны на Hugging Face в формате BF16 и NVFP4.
Подробнее о Nemotron 3.5 Super VL
Модель сочетает слои Mamba-2, MoE и attention с визуальным энкодером C-RADIO и получена дистилляцией из флагманской Nemotron 3 Ultra. Веса NVFP4-версии занимают примерно 60–70 ГБ против около 240 ГБ в BF16. Для NVFP4 достаточно одного DGX Spark, одной H200, двух H100 или одного GB200, для BF16 нужны четыре H100 или два GB200. Скорость обеспечивают встроенное предсказание нескольких токенов, техника спекулятивного декодирования LiLiCorr, ускоряющая генерацию на DGX Spark до 2,3 раза, и квантизация NVFP4 с дистилляцией, сохраняющей точность BF16-версии.
NVIDIA видит модель как универсального исполнителя для агентов в программировании, веб-исследованиях, обработке документов, кибербезопасности и анализе видео. В экосистеме компании она занимает среднее место: массовые текстовые задачи берет на себя компактная Nemotron 3.5 Lightning, а сложное планирование — флагманская Nemotron 3 Ultra. При обучении NVIDIA использовала дистилляцию от нескольких специализированных учителей, данные агентных траекторий и репозиториев кода.
В сравнении NVIDIA ближайший по размеру конкурент Qwen3.5-122B-A10B уступает Super VL в большинстве текстовых и агентных тестов: 89,52% против 86,7% на GPQA-Diamond, 88,22% против 76,7% на LiveCodeBench v6, 78% против 58,1% на BrowseComp и 66,7% против 48,7% на Terminal-Bench 2.1. На SWE-bench Verified модели почти равны (71,1% против 71,9%), а в знаниях и работе с длинным контекстом Qwen сильнее. Super VL также обходит флагманскую Nemotron 3 Ultra на Hermes Bench (63,44% против 56,33%) и выделяется низким уровнем галлюцинаций в AA-Omniscience — 30% против 84,5% у Qwen3.5 и 95,9% у DeepSeek-V4-Flash.
Более новые Qwen3.8-Flash-Next, GLM-5.3-Flash и DeepSeek-V4-Flash при этом заметно сильнее в агентном программировании: на Terminal-Bench 2.1 они набирают от 76,8% до 85,8%, на SWE-bench Verified — от 75,4% до 79,1%. В визуальных тестах Super VL держится на уровне Qwen3.5-122B-A10B: 80,8% на CharXiv против 83,5% и 51,14% на OSWorld-Verified против 51,5%.
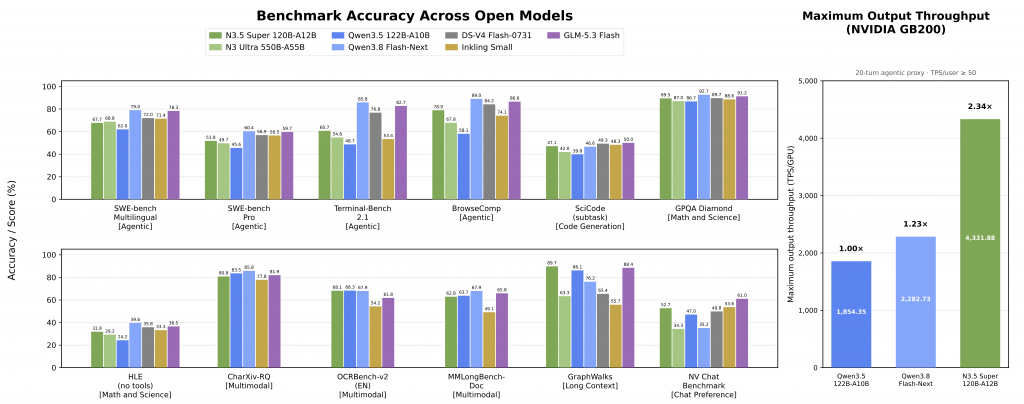
Результаты тестирования NVIDIA Nemotron 3.5 Super VL. Источник: .
Главная ставка NVIDIA — на дообучение модели под задачи компаний с помощью открытых библиотек NeMo: AutoModel для SFT и LoRA, а также NeMo RL и NeMo Gym для обучения с подкреплением. Scale AI дообучила Super VL для обработки кредитных документов в Skydance, снизив стоимость инференса в 40 раз и задержку в пять раз. Ramp преобразует фотографии чеков в структурированный JSON и ожидает до 50% роста пропускной способности при в 10 раз меньшей задержке, а AI21 и Alice повысили точность анализа угроз на 41%. Вместе с моделью NVIDIA выложила открытые датасеты, включая 40 визуально-языковых наборов, рецепты обучения и среды для RL. Веса доступны на Hugging Face и ModelScope.
Выводы
Nemotron 3.5 Super VL не лидирует в своем классе безоговорочно, но предлагает редкое сочетание: одна открытая модель для текста, изображений и видео, конкурентоспособная производительность, низкий уровень галлюцинаций и высокая скорость при всего 120 млрд общих и 12 млрд активных параметров. Для компаний, которые строят агентов на собственной инфраструктуре и готовы дообучать модель на своих данных, это одно из самых практичных открытых решений, а для NVIDIA — еще один аргумент в пользу GPU Blackwell и собственного программного стека.
