NVIDIA представила Nemotron 3.5 Bolt — ИИ-модель на 74 млрд параметров для ИИ-агентов с запуском на 24 ГБ VRAM
Введение
NVIDIA представила Nemotron 3.5 Bolt 74B-A9B 24GB — гибридную Mamba-Transformer открытую модель с архитектурой MoE для повседневных агентных задач, которая работает локально на ПК с видеокартой RTX и мини-компьютерах DGX Spark/RTX Spark. Модель получена сжатием Nemotron 3.5 Super VL со 120 до 74 млрд параметров, из которых на токен активируется 9 млрд, и агрессивной 2-битной квантизацией. В итоге она умещается в 24 ГБ памяти и генерирует около 84 токенов в секунду. Главный тезис NVIDIA: при одинаковом ограничении по памяти выгоднее сжать большую модель, чем обучать маленькую с нуля и квантизовать ее в 4 бита. По данным компании, Bolt превосходит Qwen3.6 35B-A3B и Gemma 4 26B-A4B в большинстве агентных тестов.
Подробнее о Nemotron 3.5 Bolt
NVIDIA ставила перед собой конкретную задачу: локальный агент должен работать параллельно с другими приложениями пользователя, поэтому модель обязана укладываться в 24 ГБ памяти, выдавать не менее 80 токенов в секунду и при этом быть максимально умной. Для сжатия компания использовала собственный фреймворк Star Elastic, который с помощью маршрутизатора сам подбирает архитектуру под заданный бюджет: число экспертов и ширину MoE-слоев в каждом слое. Количество активных экспертов на токен сократилось с 22 до 9, а целевой размер с самого начала рассчитывался с учетом последующей квантизации. После сжатия модель дообучили, чтобы восстановить работу с изображениями, а затем провели обучение с подкреплением в симулированных средах для локальных агентов и финальную RL-оптимизацию рассуждений и вызова инструментов.
Самое необычное в Bolt — квантизация. Веса полносвязных слоев экспертов, которые составляют большую часть модели, сжаты до формата IQ2_XXS, то есть всего 2,0625 бита на параметр. Линейные слои Mamba квантизованы в NVFP4, а эмбеддинги, attention и выходной слой — в Q8_0. Квантизуются только веса, поскольку скорость на RTX и DGX Spark ограничена прежде всего пропускной способностью памяти. Чтобы компенсировать потерю точности, NVIDIA применила дистилляцию с учетом квантизации (QAD), при которой сжатая модель учится повторять ответы исходной. По данным компании, это подтверждает выводы исследований ParetoQ и Quest: при одинаковом объеме памяти крупная модель в 1–2 битах точнее, чем небольшая в более высокой разрядности.
Скорость обеспечивает спекулятивное декодирование LiLiCorr, которое NVIDIA уже использовала в Super VL. Черновую модель на 1,13 млрд параметров обучили вместе с головой LiLiCorr, которая оценивает кандидатов по всему черновику за один проход. При 7 предсказанных токенах она в среднем принимает 4,68 токена при жадном декодировании и 4,25 при вероятностной выборке. По данным NVIDIA, LiLiCorr превосходит аналоги DSpark и DFlash2 по доле принятых токенов и задержке.
По точности Bolt опережает Qwen3.6 35B-A3B и Gemma 4 26B-A4B в тестах на общие агентные навыки, веб-навигацию и работу в терминале. Среди моделей с похожим объемом памяти она занимает первое место в PinchBench и второе — в WebArena и BrowseComp. По скорости картина менее однозначна. Тесты проводились в llama.cpp на ноутбуке Surface Laptop Ultra на платформе RTX Spark со 128 ГБ памяти. В бенчмарке AIPerf SPEED-Bench-Coding Bolt выдает 84 токена в секунду против 96,6 у Qwen3.6 35B-A3B и 100,6 у Gemma 4 26B-A4B, но втрое быстрее плотной Qwen3.8 27B с 28,3 токена в секунду. В AA-AgentPerf Local, где воспроизводятся реальные траектории агентов, Bolt справляется за 601 секунду против 454 у Qwen3.6, 481 у Gemma 4 и 1043 у Qwen3.8 27B. Иначе говоря, модель медленнее легких конкурентов с 3-4 млрд активных параметров, но точнее их.
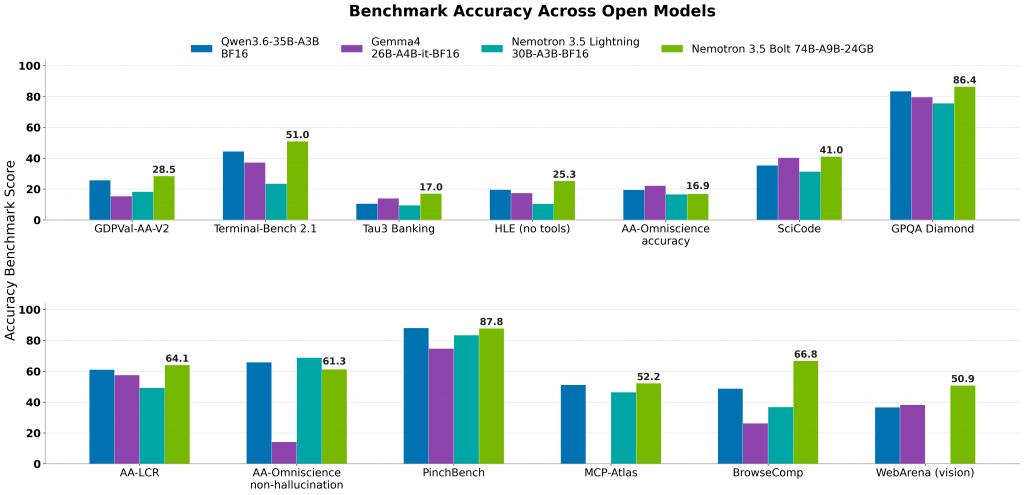
Результаты тестирования Nvidia Nemotron 3.5 Bolt. Источник: .
NVIDIA выложила основную 24 ГБ версию модели в формате NVFP4 и в GGUF, черновую модель LiLiCorr в обоих форматах, а также неквантизованный чекпоинт в BF16 для дообучения. Квантизованная версия оптимизирована для llama.cpp на RTX Spark и vLLM на DGX Spark.
Выводы
Nemotron 3.5 Bolt — интересный эксперимент, который бросает вызов привычному подходу к локальным моделям. Вместо того чтобы обучать компактную модель с нуля, NVIDIA сжала крупную и квантизовала ее до 2 бит, и, судя по тестам компании, такой путь дает более умную модель при том же бюджете памяти. Bolt не самая быстрая в своем классе, но для локальных агентов, где важнее правильно выполнить задачу, чем выдать ответ на долю секунды раньше, это разумный компромисс.
