MiniMax открыла исходный код MiniMax M3.1-Flash — мультимодальная MoE-модель на 428 млрд параметров для агентов и кодинга
Введение
MiniMax опубликовала на Hugging Face веса MiniMax M3.1-Flash — новой нативной мультимодальной MoE-модели для программирования, агентных задач и кибербезопасности. В MiniMax M3.1-Flash около 428 млрд параметров, из которых на токен активируется 23 млрд. Модель принимает текст, изображения и видео и поддерживает контекст до 1 млн токенов. Полный чекпоинт занимает около 252 ГБ, а по сравнению с MiniMax-M3 новинка заметно прибавила в агентных задачах и стала эффективнее при инференсе благодаря разреженному вниманию, обучению с учетом квантизации и спекулятивному декодированию DSpark.
Подробнее о MiniMax M3.1-Flash
MiniMax M3.1-Flash сохраняет базовую MoE-архитектуру MiniMax M3, но получила три важных изменения. Во-первых, разреженное внимание MiniMax Sparse Attention (MSA) теперь используется во всей модели: первые три слоя с полным вниманием заменены разреженными. Во-вторых, маршрутизируемые эксперты и пути внимания квантизовались прямо во время обучения, что уменьшает объем памяти и повышает эффективность обслуживания. В-третьих, вместо прежнего подхода MTP в духе EAGLE используется спекулятивное декодирование DSpark, черновая голова для которого входит в релиз.
Благодаря квантизации экспертов в NVFP4 чекпоинт сократился с 451,5 до примерно 250 ГБ, а с черновой моделью репозиторий весит 252,4 ГБ. Объем KV-кэша тоже уменьшился: в формате NVFP4 на токен уходит около 34,5 КБ вместо 61,4 КБ в FP8, то есть на 44% меньше. В рецепте vLLM модель разворачивается на четырех NVIDIA B300 с 288 ГБ памяти каждая, то есть примерно 1,15 ТБ видеопамяти. При контексте 256 тысяч токенов такой сервер одновременно обслуживает 76 запросов против 28 у MiniMax-M3. В vLLM поддержка M3.1-Flash появилась в день релиза для NVIDIA Blackwell, Rubin и AMD MI350. На GB300 модель выдает до 419 токенов в секунду на пользователя в режиме низкой задержки.
По агентным бенчмаркам MiniMax M3.1-Flash находится на уровне лучших открытых моделей и местами догоняет закрытые флагманы. На Automation-Bench она набирает 62,8% — больше, чем DeepSeek V4.1-Flash-1017 (60,5%), GPT-5.6 Sol (45,8%) и Claude Opus 5 (50,3%). На BankerToolBench результат 76,2 совпадает с Opus 5 и превосходит GPT-5.6 Sol (74,6), а на тесте длинного контекста LOCA-Bench 256K модель лидирует с 60,3% против 60% у GPT-5.6 Sol и 53,7% у Opus 5. В кибербезопасности на CyberGym M3.1-Flash показывает 82,2, немного уступая GLM-5.3 (84,5) и GPT-5.6 Sol (83,6). В программировании картина менее однозначная: на DeepSWE v1.1 модель набирает 73,7% против 77% у DeepSeek V4.1-Flash-1017 и 74% у Opus 5, на Terminal-Bench 4.0 — 38,1% против 42,3% у DeepSeek и 51,8% у Opus 5, а на NL2Repo-Bench — 61,2% против 68,2% и 75,3%. В управлении компьютером на OSWorld модель набирает 61,7 против 65,7 у GPT-5.6 Sol и 70,6 у Opus 5, а на HLE без инструментов — 43,4% против 55,6% у Opus 5. Все результаты получены самой MiniMax на официальных весах.
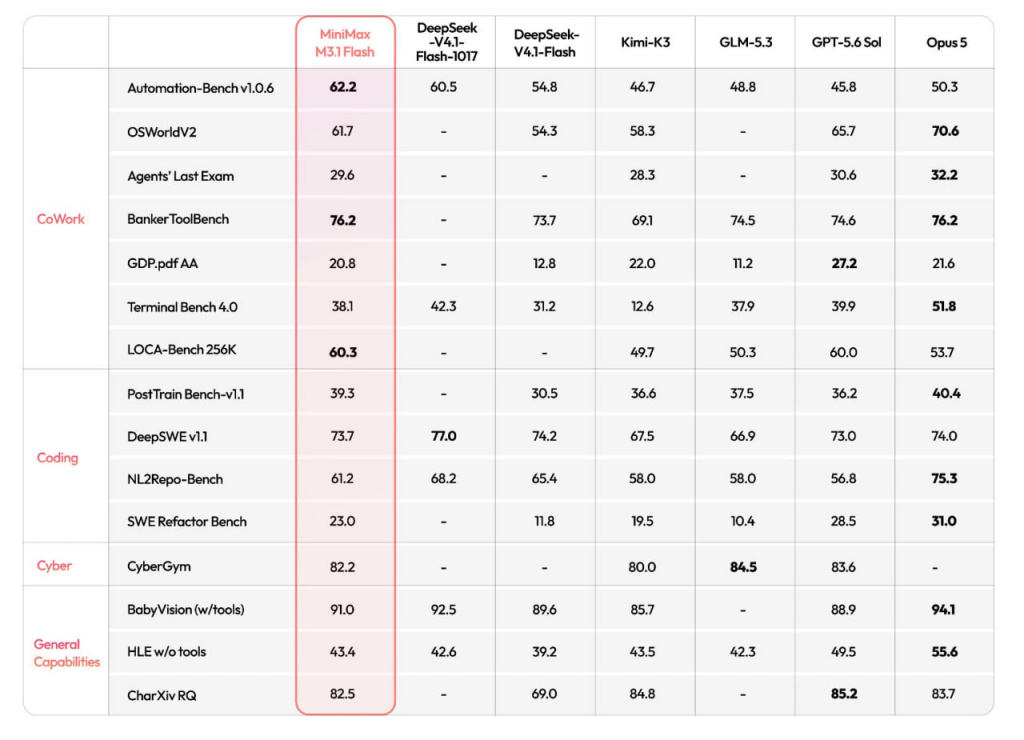
Результаты тестирования MiniMax M3.1-Flash. Источник: .
Через API модель стоит $0,15 за миллион входных токенов и $0,6 за миллион выходных токенов — столько же, сколько DeepSeek V4.1-Flash. Компания MiniMax также пообещала выпустить старшую версию MiniMax M3.1 Pro в ближайшее время.
Выводы
M3.1-Flash выходит всего через неделю после DeepSeek V4.1-Flash-1017 и становится его прямым конкурентом: та же цена в API, похожий класс задач и сопоставимые результаты. DeepSeek сильнее в программировании, а MiniMax — в автоматизации, работе с длинным контекстом и финансовых агентных задачах. Главное преимущество M3.1-Flash — компактность при развертывании: 252 ГБ весов против 510 ГБ у DeepSeek позволяют запустить модель на одном сервере и обслуживать много параллельных запросов с длинным контекстом. Это делает ее привлекательной для компаний, которым нужен собственный инференс без многоузловых кластеров.
