Microsoft представила Maia 300 — ИИ-ускоритель для инференса на уровне Nvidia B300
Введение
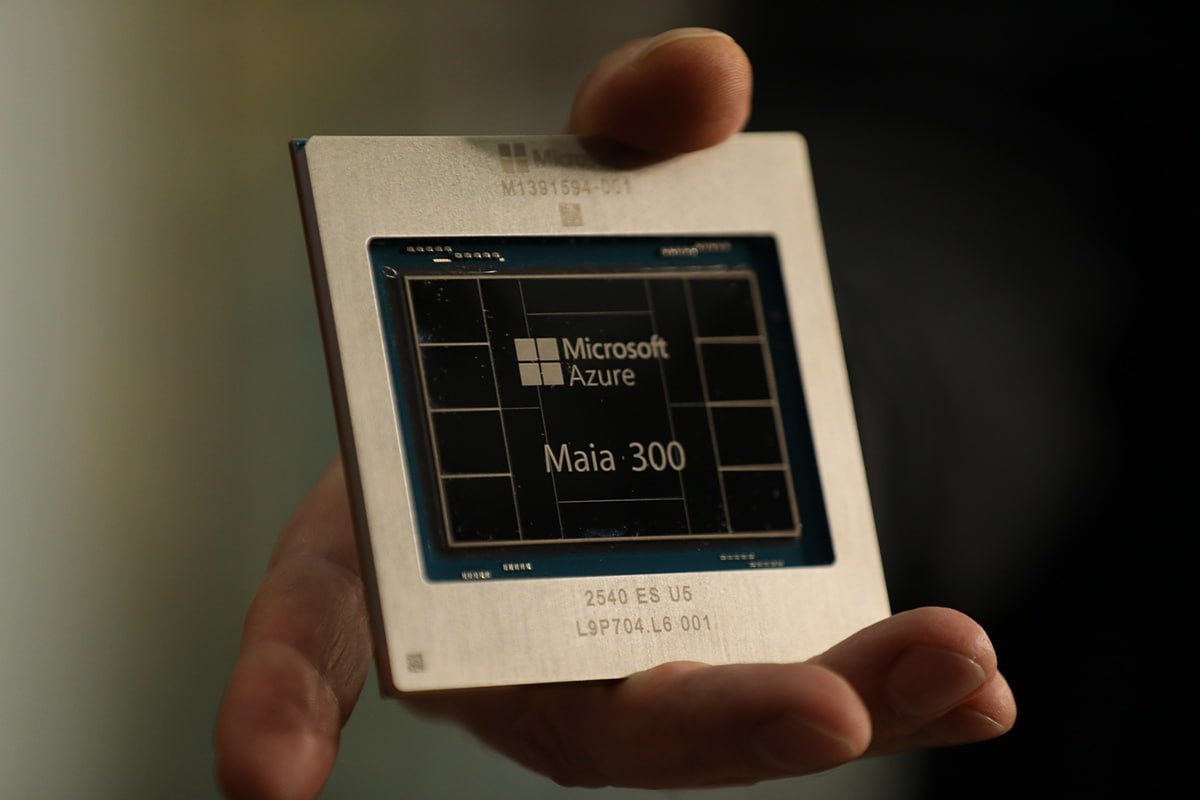
На OCP Global Summit Microsoft представила Azure Maia 300 — третье поколение собственного ИИ-ускорителя для инференса. По сравнению с Maia 200 новинка получила в 2,5 раза больше пропускной способности памяти, на 33% больше ее объема и примерно вдвое лучшее соотношение пропускной способности HBM к потребляемой мощности. Microsoft заявляет, что Maia 300 будет выдавать на 40% больше токенов на мегаватт, чем ведущие GPU-системы, а один шкаф с 96 ускорителями — до 7 раз больше токенов, чем шкаф Maia 200. Массовое развертывание начнется в 2027 году в масштабе нескольких гигаватт.
Подробнее о Maia 300
Maia 300 — многочиплетный ASIC-ускоритель, вычислительные кристаллы которого производятся по техпроцессу TSMC N2P. Ускоритель получил восемь стеков HBM4 общим объемом 288 ГБ и пиковой пропускной способностью 18 ТБ/с при TDP 950 Вт. Заявленная производительность составляет 13,8 PFLOPS в FP4 и 6,9 PFLOPS в FP8, что на 36% больше, чем у Maia 200. Microsoft не пытается построить аналог GPU от NVIDIA: архитектура оптимизирована под пропускную способность памяти, локальность данных и межчиповое взаимодействие, то есть под длинные контексты и нагрузки, в которых доминирует декодирование. Сеть при этом встроена прямо в модель исполнения ускорителя, а не работает как отдельный слой.
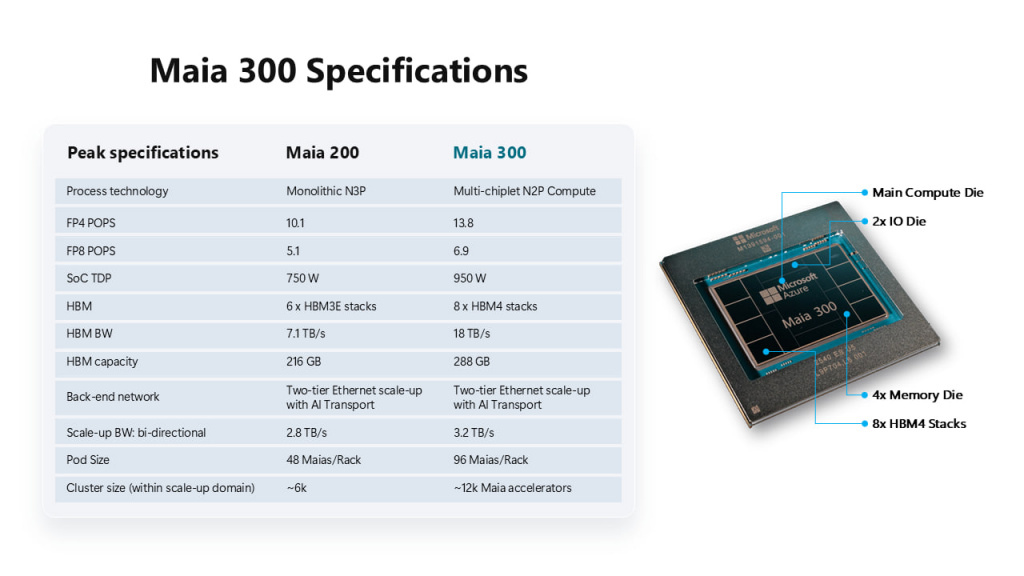
Характеристики процессора Maia 300 в сравнении с Maia 200. Источник: .
По вычислительной мощности Maia 300 находится примерно на уровне B300, но превосходит его в 2,34 раза по пропускной способности памяти и в 1,78 раза по пропускной способности интерконнекта по сравнению с NVLink 5. Открытым остается вопрос, в каком режиме посчитаны заявленные FP4 и FP8: Microsoft не публикует отдельные значения для плотных и разреженных вычислений. Однако в научной статье Microsoft о Maia 200, опубликованной в августе 2026 года, производительность рассчитывается из числа физических MAC-операций и частоты, без учета ускорения за счет разреженности. Прирост 13,8 PFLOPS к 10,145 PFLOPS у Maia 200 дает ровно заявленные 36%, поэтому с высокой вероятностью цифры Maia 300 относятся к плотным вычислениям. Если это так, Maia 300 почти догоняет B300 SXM в FP4 и опережает его примерно на 53% в FP8.
В одном серверном модуле Microsoft размещает 4 Maia 300, а в шкафу — 24 таких модуля, то есть 96 ускорителей, плюс три сетевых модуля с шестью коммутаторами. Шкаф потребляет 167 кВт и в сумме располагает 27,6 ТБ HBM с пропускной способностью около 1,7 ПБ/с. Это втрое больше, чем 576 ТБ/с у GB300 NVL72 на 72 GPU при мощности до 142 кВт. Суммарная пиковая производительность шкафа Maia достигает 1325 PFLOPS в FP4 и 662 PFLOPS в FP8 против 1080 и 360 PFLOPS dense у GB300 NVL72. Даже четыре Maia 300 по суммарной пропускной способности памяти (72 ТБ/с) примерно на 17% опережают HGX B300 (61,6 ТБ/с), хотя уступают ему по объему памяти и вычислительной мощности.
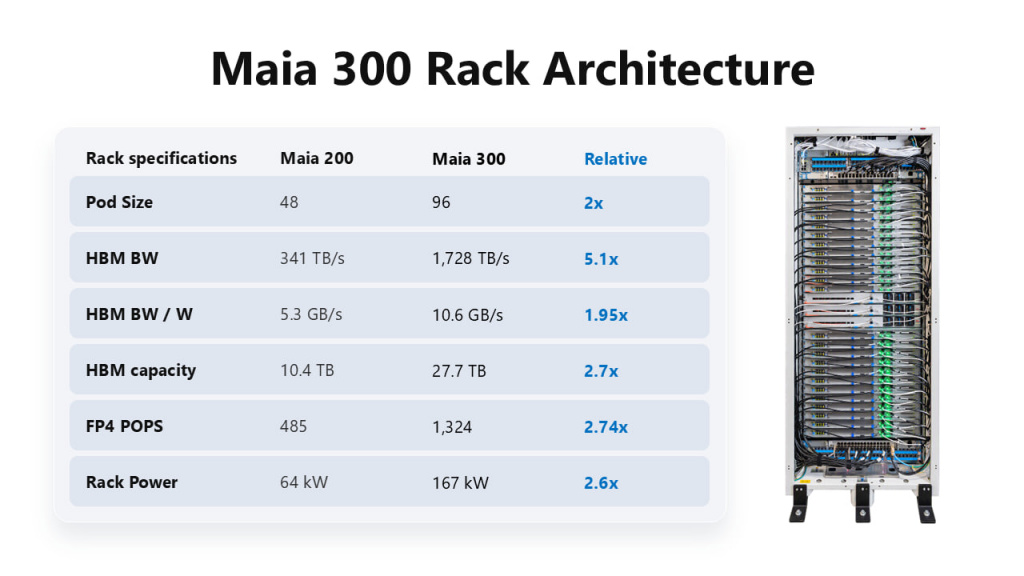
Характеристики ИИ-стоек на базе Maia 300. Источник: .
Еще одно отличие касается связи между ускорителями. Внутри модуля Maia 300 соединены попарно напрямую, внутри шкафа — через один коммутатор, а между шкафами — через три. Суперпод может объединять до 128 шкафов, то есть 12 288 ускорителей в одном scale-up-домене, а для масштабирования Microsoft использует собственный транспорт поверх Ethernet. По данным компании, при определенном распределении нагрузки ускоритель может передавать до 750 ГБ/с удаленному чипу в пределах суперпода, что намного больше 100 ГБ/с одного 800-гигабитного интерфейса InfiniBand у B300. Но 3,2 ТБ/с не означают гарантированных 1,6 ТБ/с между любыми двумя чипами, а 12 288 ускорителей не общаются друг с другом с одинаковой скоростью и задержкой. NVIDIA в этом плане сохраняет преимущество: в GB300 NVL72 все 72 GPU находятся в едином быстром NVLink-домене, что критично для тензорного параллелизма, AllReduce и MoE-моделей с интенсивным обменом данными.
Массовое развертывание Maia 300 начнется в 2027 году, когда главным конкурентом станет уже не только B300, но и NVIDIA Rubin. Rubin тоже имеет 288 ГБ HBM4 с пропускной способностью до 22 ТБ/с, NVLink 6 с 3,6 ТБ/с и до 50 PFLOPS в NVFP4 с учетом разреженности.
Выводы
С Maia 300 Microsoft впервые выпускает собственный ускоритель, который может всерьез заменить решения NVIDIA в ее дата-центрах, а не просто дополнить их. Главное достижение чипа — не 13,8 PFLOPS в FP4, а 18 ТБ/с памяти HBM4 при 950 Вт и сеть, встроенная прямо в архитектуру. Для декодирования с малым batch, длинных контекстов, распределенного инференса и раздельных prefill и decode это очень перспективная архитектура, которая на уровне одного чипа заметно лучше сбалансирована под инференс, чем B300. Тем не менее говорить о том, что Microsoft перехватила лидерство, рано. NVIDIA по-прежнему сильна зрелым стеком CUDA и TensorRT-LLM, высокой вычислительной мощностью, единым NVLink-доменом и поддержкой гораздо более широкого спектра задач, а к 2027 году на рынок выйдет Rubin.
