Microsoft Maia 200 — 3-нм ускоритель инференса со скоростью 7 ТБ/с и масштабированием до 6000 чипов
Введение
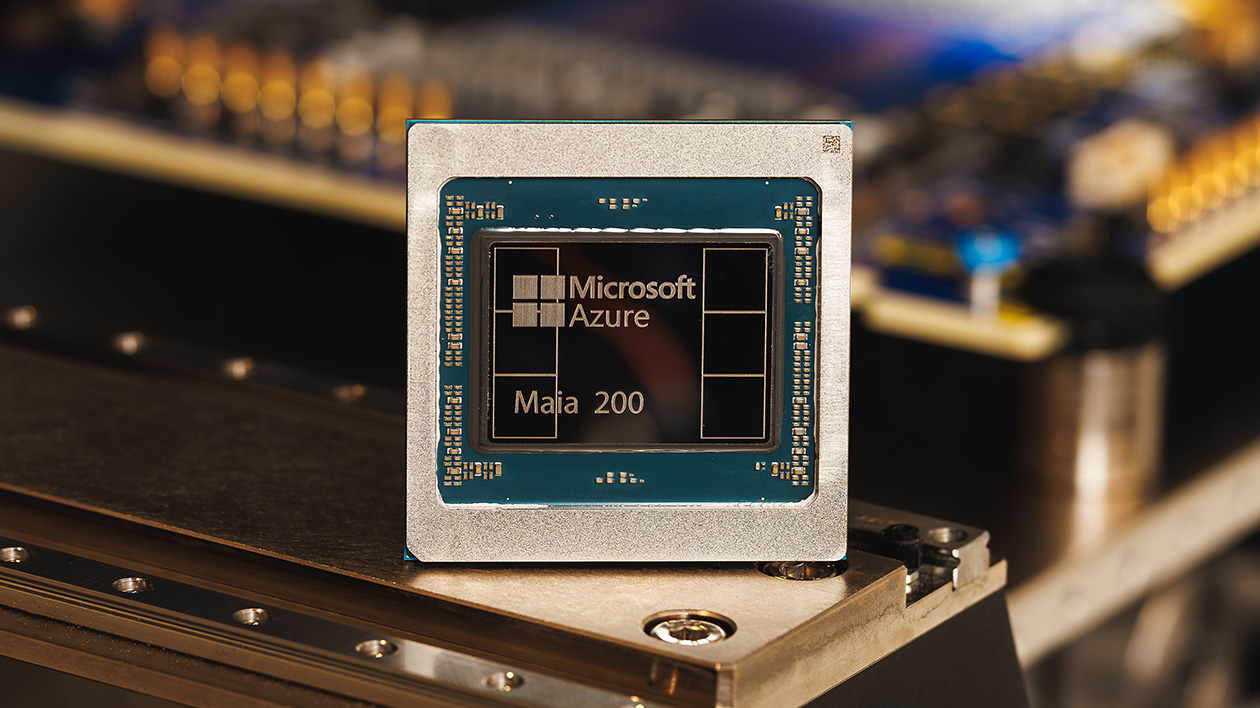
На Hot Chips 2026 Microsoft раскрыла детали своего второго поколения ИИ-ускорителя Maia 200, который вскоре начнет развертываться в дата-центрах Azure. Чип выполнен по техпроцессу TSMC N3 (3 нм), содержит 140 миллиардов транзисторов и оснащен шестью стеками памяти HBM3e с суммарной пропускной способностью 7 ТБ/с. При теплопакете 750 Вт ускоритель обеспечивает производительность 10 000 TFLOPS в формате FP4. Ключевая архитектурная особенность — Software Defined Local Access (SDLA), которая переносит управление потоком данных на уровень компилятора, гарантируя детерминированное исполнение. Сетевая подсистема построена на Unified Ethernet без отдельных коммутаторов scale-out, что упрощает развертывание и позволяет масштабироваться до 128 стоек и 6000 чипов. Первое поколение Maia 100 было анонсировано ранее, а теперь Microsoft раскрывает внутреннюю архитектуру и программный стек, включая библиотеку коллективных коммуникаций MCCL.
Подробнее о Maia 200
Основной вычислительный блок Maia 200 — тайл, включающий тензорный матричный движок (Tile Tensor Unit), векторный процессор с SIMD-движками, управляющий процессор, DMA-блок и L1-кэш. Тайлы объединяются в кластеры с L2-кэшем, образуя иерархическую подсистему памяти, где данные перемещаются между уровнями только при необходимости. Такой подход снижает трафик и энергопотребление.
SDLA-архитектура разделяет управление и данные: DMA-движки и вычислительные элементы работают независимо, а синхронизация выполняется через семафоры. Поскольку поток данных задается на этапе компиляции, поведение чипа предсказуемо, что критично для стабильной производительности инференса в мультиарендных средах.
Сетевая часть интегрирована в SoC: каждый чип имеет восемь Ethernet-линий, разбитых на четыре сетевые плоскости. Это позволяет строить полностью связанные топологии без внешних сетевых карт. На уровне стойки используются коммутаторы tier-0, на уровне кластера — tier-1. Microsoft отказалась от традиционного scale-out в пользу унифицированного scale-up, что упрощает эксплуатацию и повышает надежность за счет встроенных аппаратных механизмов восстановления.
Программный стек co-design: ядра операций (GEMM, attention, коллективные операции) специально оптимизированы под SDLA. Для GEMM используется gather-операция по центральной шине с загрузкой весов из HBM и фиксацией результата в L1 SRAM. В распределенном режиме применяется блочная интерливинг для полного перекрытия тензорных и SIMD-операций. Коллективные операции поддерживают адаптивную логическую топологию: для малых объемов — single-hop без накладных расходов, для больших — кольцевая схема.
Производительность, по данным Microsoft, приближается к теоретическому потолку (roofline) в GEMM-бенчмарках, достигая 1,65 PFLOPS в attention-операциях. Коллективные операции демонстрируют до 1,3 ТБ/с в BF16 AllReduce и 655 ГБ/с в All2All. Эти показатели подкреплены программной библиотекой MCCL, разработанной специально для Maia 200.
Выводы
Maia 200 отражает стратегию Microsoft на создание собственного ускорителя, оптимизированного именно под инференс и работу в масштабе гиперскейлера. Выбор SDLA с детерминированным исполнением снимает проблему вариативности задержек, свойственную GPU-подходам, а Unified Ethernet радикально упрощает сетевое развертывание по сравнению с гибридными схемами. Ограничение шестью стеками HBM и 750 Вт выглядит консервативным на фоне конкурентов, но позволяет упаковывать больше чипов в стойку и снижать стоимость владения. Если Maia 200 достигнет заявленной эффективности, он может стать ключевым элементом Azure для обслуживания больших моделей с длинным контекстом, где критичны пропускная способность памяти и стабильность. Microsoft делает ставку на вертикальную интеграцию — от кремния до коллективных библиотек, и это дает ей уникальную гибкость в оптимизации всего стека.
