DeepSeek представила DeepInfer — ИИ-движок для быстрого инференса LLM DeepSeek
Введение
DeepSeek открыла исходный код DeepInfer — фреймворка для ИИ-инференса, на котором работают крупномасштабные сервисы компании, включая API. Проект опубликован на GitHub под лицензией Apache 2.0 и на старте поддерживает только DeepSeek-V4.1-Flash, а код для будущих моделей компания обещает выкладывать туда же. По словам DeepSeek, она делится своим продакшен-стеком, чтобы помочь сообществу снизить затраты на вычисления и энергопотребление и сделать ИИ доступнее. Самая обсуждаемая деталь релиза — список поддерживаемого железа: помимо GPU NVIDIA поколения Blackwell, DeepInfer с первого дня работает на ускорителях Huawei Ascend 950. Вместе с фреймворком DeepSeek выложила библиотеку deepseek-recipe, которая повторяет то, как официальный API компании превращает запросы в токены и обратно.
Подробнее о DeepSeel DeepInfer
Веса своих моделей DeepSeek публикует давно, и их можно запускать в сторонних движках вроде vLLM или SGLang. Но то, насколько эффективно модель работает, во многом зависит от ПО, которое распределяет запросы, делит вычисления между чипами и генерирует ответы. DeepInfer дает разработчикам доступ к тому же подходу, который DeepSeek использует у себя. В основе фреймворка лежат ранее открытые библиотеки компании FlashMLA, DeepGEMM и DeepEP, а также TileKernels, DeepSelect и собственные ядра на TileLang. Для распределения вычислений поддерживаются параллелизм данных для attention и сбалансированный контекстный параллелизм, а для MoE-слоев — параллелизм экспертов с их динамической балансировкой (EPLB).
Декодирование ускоряет спекулятивная генерация DSpark: модель предлагает черновые токены, а проверка планируется с учетом оценки уверенности. По умолчанию длина черновика — до пяти токенов. Механизм SWA bounded replay сокращает объем вычислений на этапе prefill, повторно прогоняя только ограниченный хвост контекста, который должен покрывать окно скользящего внимания. Асинхронный планировщик совмещает формирование батчей на CPU с работой ускорителя и включен по умолчанию. Также поддерживаются структурированные выводы по регулярному выражению, JSON-схеме или грамматике EBNF. Отдельно стоит отметить режим инвариантности к батчу, при котором результаты модели не зависят от состава батча, и детерминированную выборку, которая выдает одинаковые ответы на одинаковые запросы с фиксированным seed. Эти две функции пока работают только на NVIDIA.
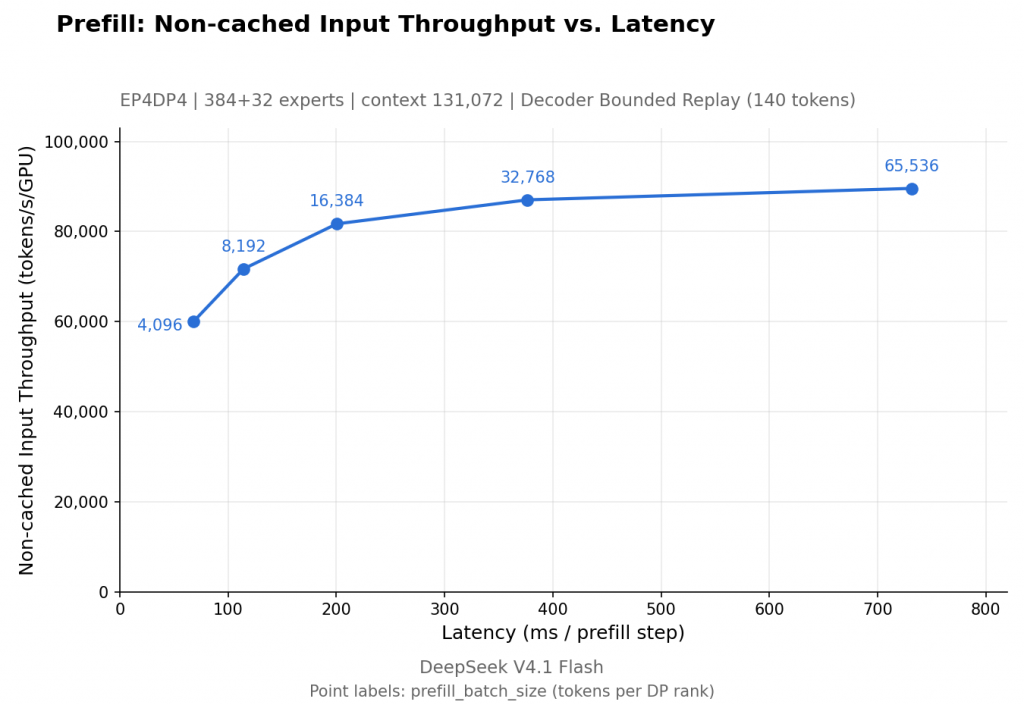
Скорость фазы префила при использовании DeepInfer. Источник: .
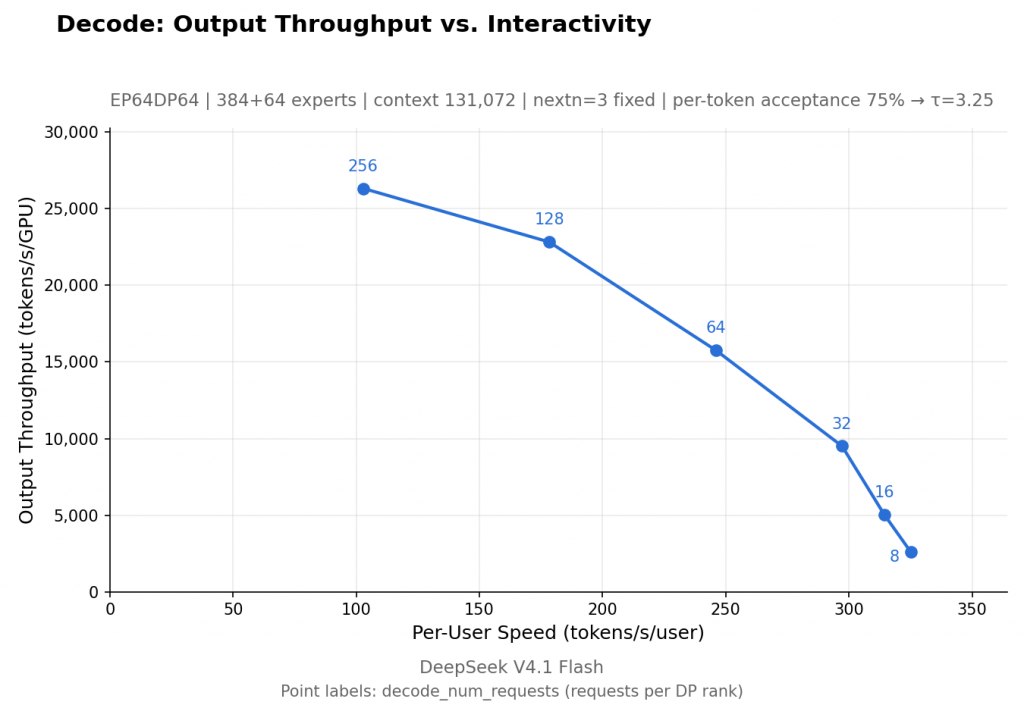
Скорость фазы декодирования при использовании DeepInfer. Источник: .
На старте DeepInfer поддерживает две платформы: GPU NVIDIA с архитектурой SM100, то есть дата-центровые Blackwell, и NPU Huawei Ascend 950. Более старые поколения NVIDIA, включая Hopper, в списке отсутствуют. Для работы нужны Linux, Python 3.12 и GCC 13 или новее, а также CUDA 13 для NVIDIA или CANN 9.2 для Ascend. Опубликованные DeepSeek замеры производительности сделаны на GPU NVIDIA: четыре ускорителя SM100 отвечали за prefill и 64 — за декодирование. Как фреймворк работает на чипах Huawei, пока неясно.
Важно понимать, что DeepInfer — не полный продакшен-стек. Открытая версия поддерживает офлайн-инференс с основными функциями для масштабной работы, но для полноценного сервиса не хватает системы управления KV-кэшем, разнесения этапов prefill и декодирования по разным машинам (хотя большая часть нужной функциональности уже реализована) и балансировки нагрузки между репликами. Эти компоненты разработчикам придется добавить самостоятельно.
Выводы
DeepInfer — редкий случай, когда ИИ-лаборатория открывает не только веса моделей, но и движок, на котором сама их обслуживает. Для компаний, которые хотят разворачивать DeepSeek-V4.1-Flash на собственной инфраструктуре, это возможность получить производительность, близкую к официальному API, без многомесячной оптимизации своими силами. Впрочем, на практике порог входа остается высоким: нужны новейшие Blackwell или Ascend 950, а KV-кэш, раздельный prefill и decode и балансировку придется строить самостоятельно. Поэтому для многих главная ценность релиза — в коде, оптимизации из которого можно перенести в vLLM и SGLang. Не менее важен и сигнал рынку: поставив Huawei Ascend в один ряд с NVIDIA, DeepSeek показывает, что китайское железо становится для нее полноценной платформой для инференса
