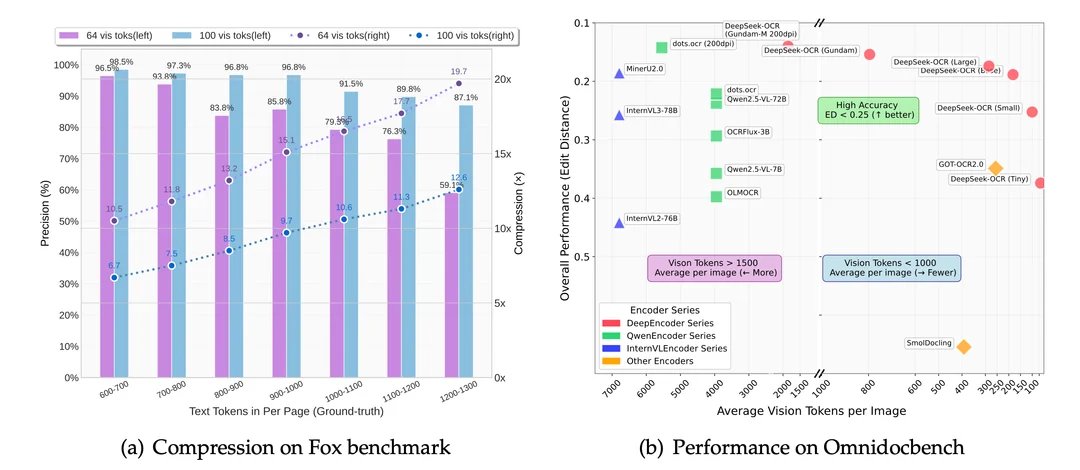
Компания DeepSeek анонсировала новую модель оптического распознавания символов — DeepSeek-OCR (Contexts Optical Compression), предназначенную для извлечения текста из документов с последующим сжатием данных.
Подробнее о DeepSeek-OCR
Модель построена на архитектуре Mixture of Experts (MoE). Объем модели составляет 6,68 ГБ, что соответствует примерно 3,6 миллиардам параметров, при этом она поддерживает вычислительную точность BF16, что обеспечивает баланс между производительностью и эффективностью.
DeepSeek-OCR поддерживает четыре основных режима работы, различающихся по разрешению и числу визуальных токенов:
Tiny: 512×512 (64 токена);
Small: 640×640 (100 токенов);
Base: 1024×1024 (256 токенов);
Large: 1280×1280 (400 токенов).
Кроме того, предусмотрен специальный режим Gundam с динамическим расширением n×640×640 + 1×1024×1024, который позволяет гибко масштабировать качество анализа в зависимости от сложности документа.
По данным компании, новая OCR-модель способна обрабатывать до 33 миллионов страниц в день при использовании кластера из 20 узлов по 8 GPU NVIDIA A100 (40 ГБ). Для открытой и компактной OCR-системы такие показатели считаются крайне высокими, что делает DeepSeek-OCR одним из самых производительных решений в своем классе открытых LLM. Веса модели уже лежат на GitHub и Hugging Face.
Выводы
Вполне возможно, что компания DeepSeek готовит к релизу новое поколение VL-нейросетей на фоне резкого взлета популярность больших языковых моделей для распознавания текста от Alibaba, IMB и других компаний. Также не исключено, что DeepSeek-OCR станет частью не просто семейства, а флагманской мультимодальной нейросети, вроде DeepSeek R2 или DeepSeek V4.
33 миллиона страниц в день на 160 GPU A100: это около 230 тысяч страниц на один ускоритель. Для открытой модели впечатляюще, но такой кластер доступен единицам команд. На одном A100 производительность будет на порядки ниже.
Serverflow
Вы правы: пиковая цифра рассчитана на индустриальный кластер. Для одного A100 оценка ближе к 200 тысячам страниц, что всё равно конкурентоспособно среди открытых OCR-решений.
Валерий
20.10.2025
Режим Gundam комбинирует два разрешения: n×640×640 и 1×1024×1024. Как именно выбирается n: по сложности документа или числу фрагментов на странице? В статье не уточнён порог срабатывания этого режима.
Serverflow
В режиме Gundam n действительно подбирается динамически под сложность входного документа, но в технической документации мы пока не раскрывали точный алгоритм выбора числа фрагментов.
Скидка 1 500 ₽ или бесплатная доставка - уже сейчас 🔥
Мы ценим обратную связь от клиентов. При оформлении заказа вы можете сообщить о своём намерении поделиться впечатлением о работе ServerFlow после получения товара.
* - скидка предоставляется при покупке от 30 000 рублей, в ином случае предусмотрена бесплатная доставка до ПВЗ СДЭК.
Продолжная использовать наш сайт, вы даете согласие на использование файлов Cookie, пользовательских данных (IP-адрес, вид операционной системы, тип браузера, сведения о местоположении, источник, откуда пришел на сайт пользователь, с какого сайта или по какой рекламе, какие страницы
открывает и на какие страницы нажимает пользователь) в целях функционирования сайта, проведения статистических исследований и обзоров. Если вы не хотите, чтобы ваши данные обрабатывались, покиньте сайт.
При оформлении заказа в ServerFlow вы можете сообщить о намерении оставить отзыв о нашей работе после получения товара.
Нам важно ваше честное мнение. Оно помогает развивать сервис и даёт другим клиентам представление о нашей работе.
Вы можете оставить отзыв на удобной для вас платформе:
Google Maps
2GIS
Яндекс Карты
Как работает акция
Применяя промокод, вы подтверждаете намерение поделиться впечатлением о работе ServerFlow после получения заказа. Мы применяем бонус уже к текущему заказу в знак благодарности за обратную связь.
Условия акции:
скидка 1 500 ₽ при заказе от 30 000 ₽
или бесплатная доставка* при заказе до 30 000 ₽
* Бесплатная доставка заказа осуществляется до ПВЗ СДЭК.