Anthropic выпустила Claude Fable 5.2 и Mythos 5.2 — новые лидеры в кодинге и кибербезопасности
Введение
Anthropic представила Claude Fable 5.2 и Claude Mythos 5.2 — обновление моделей, предназначенных для самых сложных технических задач. Это одна и та же базовая модель с разными уровнями защиты: Fable 5.2 доступна всем пользователям и имеет строгие ограничения в кибербезопасности и биологии, а Mythos 5.2 открыта через программы верификации для организаций, работающих в этих областях. Обе модели генерируют ответы до 30% быстрее предшественников и стоят дешевле: $8 за миллион входных токенов и $40 за миллион выходных. Опциональный быстрый режим ускоряет генерацию до 2,5 раз за $16 и $80 соответственно.
Подробнее о Claude Fable 5.2 и Claude Mythos 5.2
В кодировании Fable 5.2 устанавливает новые рекорды. На FrontierCode 2.0 при усилии Xhigh модель набирает 49,1% — лучший результат среди всех протестированных релизов, против 32,4% у Fable 5.1, 45,5% у Opus 5.5, 42,8% у GPT-6 Astra и 41,1% у Gemini 4 Carbon. На FrontierSWE v2 результат 69,9% против 56,3%, 62,3%, 65,5% и 61,2% соответственно. В AutomationBench — 51,4% против 31,4% у Fable 5.1, 42,5% у Opus 5.5 и 41,4% у GPT-6 Astra, хотя Gemini 4 Carbon здесь немного выше с 53,9%. На Terminal-Bench-Science 0.1 Fable 5.2 показывает 74,6%, а Mythos 5.2 — 75,3% против 52,6%, 58,7%, 68,1% и 64,8% у конкурентов.
В кибербезопасности Mythos 5.2 заметно сильнее предшественников. На CyScenarioBench результат 76,3% против 61,7% у Mythos 5.1 и 67,6% у Opus 5.5 без защит. В CVE Rediscovery — 89,6% против 78,3% и 81,3%. В дизайне белковых связывателей de novo — 85,1% против 79,1% и 82,6%. В агентном поиске WANDR — 82,1% против 68,7% и 72,3%. В использовании компьютера OSWorld 2.1 — 89,3% против 83,5% у Fable 5.1, 87,2% у Opus 5.5, 79,5% у GPT-6 Astra и 81,5% у Gemini 4 Carbon. В робототехнике RoboDojo Sim — 64,9% против 27,6% у Fable 5.1, 39,4% у Opus 5.5, 29,8% у GPT-6 Astra и 34,2% у Gemini 4 Argon.
Научные результаты выходят за рамки бенчмарков. Fable 5.2 решила две открытые задачи в теоретической физике, связанные с черными дырами и объединением общей теории относительности с квантовой механикой. В одной из них расчет, намеченный в 2003 году, считался слишком трудоемким для завершения — модель выполнила его почти автономно и показала, что фазовый переход остается резким и в малых вселенных. В формализации Великой теоремы Ферма команда из 1000 агентов Fable 5.2 справилась за 30 часов с минимальным вмешательством человека, тогда как исследовательская версия Claude потратила на это 11 дней, а Opus 5.5 с той же схемой за 18 часов завершил лишь 26% работы. Безопасность также усилена. Автоматический поведенческий аудит, охватывающий около 1900 сценариев, показал у Mythos 5.2 общий балл несоответствия 2,67 против 3,28 у Mythos 5.1, 2,79 у Opus 5.5 и 3,10 у Sonnet 5.5 — чем ниже, тем лучше.
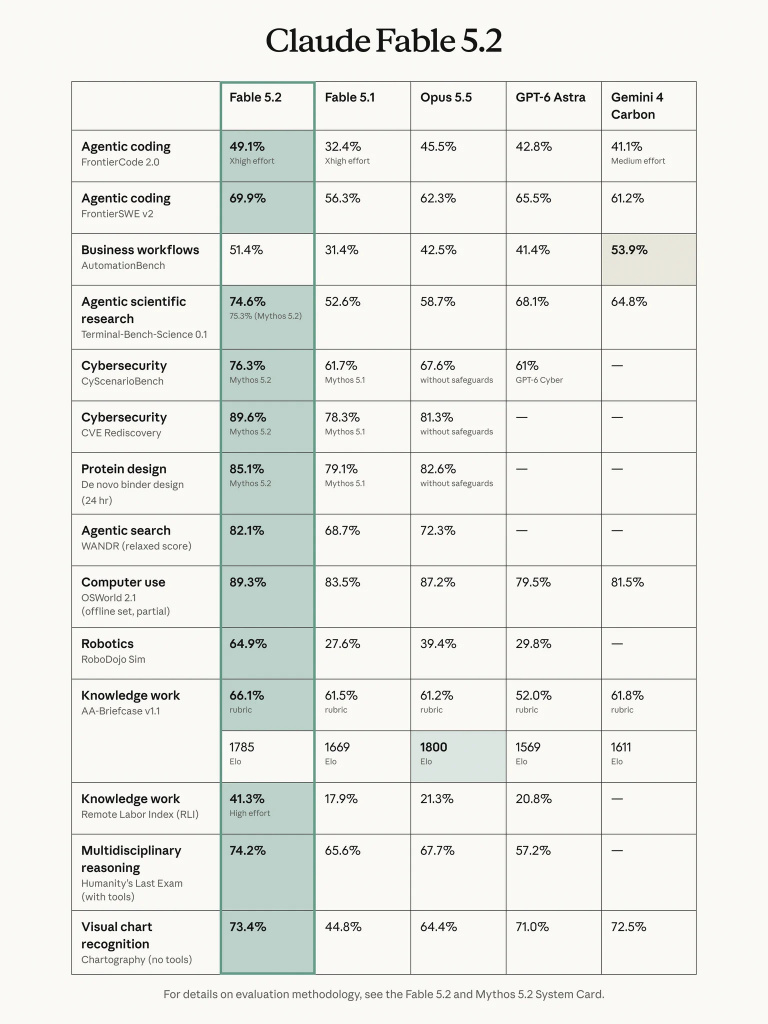
Результаты тестирования Claude Fable 5.2. Источник: .
Выводы
Claude Fable 5.2 и Mythos 5.2 — это не просто очередной шаг вверх по бенчмаркам, а демонстрация того, что топовые ИИ-модели начинают решать задачи, которые раньше считались уделом специализированных команд на месяцы. Одновременно Anthropic снижает цену, ускоряет генерацию и усиливает защиту от злоупотреблений, сокращая ложные блокировки. Если темп сохранится, следующее поколение таких моделей может окончательно размыть границу между инструментом и исследовательским партнером, а конкуренция с GPT-6 Astra и Gemini 4 перейдет из плоскости процентов на бенчмарках в плоскость реальных научных и инженерных результатов.
