Полный обзор GLM-4.7 от Z.ai: чем отличается от GLM-4.6 и как использовать новую LLM-модель
Введение
GLM-4.7 – это не еще одна большая модель, а заявка на пересборку того, как сегодня выглядят coding-агенты и инженерные AI-контуры. Релиз от Z.ai (Zhipu AI) 22 декабря 2025 года прошел без лишнего шума, но с набором цифр и обещаний, которые сложно игнорировать, если вы работаете с кодом, инструментами и длинным контекстом. Здесь речь уже не про чат-бота, а про модель, которую видят, как ядро агентных систем – с терминалом, функциями и многошаговыми действиями.
При этом важно сразу снять иллюзии: GLM-4.7 в API – текстовая модель, а все «мультимодальные» истории лежат на уровне платформы и обвязки. Вопрос, который стоит задать с порога, простой: это реальный шаг вперед для разработки и бизнеса или аккуратно упакованный апгрейд 4.6? Ниже – разбор без маркетинга: что умеет GLM-4.7, где она сильна, где ограничена и зачем она может пригодиться сегодня.
Кому статья поможет
Этот текст ориентирован на практиков, которые используют LLM не как эксперимент, а как рабочий инструмент и вынуждены принимать инженерные и продуктовые решения. Она будет интересна:
- ML/LLM-инженерам, выбирающим модели под кодинг, агентов и длинный контекст;
- техлидам и архитекторам, интегрирующим LLM в SDLC и корпоративные системы;
- разработчикам IDE-плагинов и агентных приложений с tool use и терминалом;
- DevOps и SRE, автоматизирующим диагностику и эксплуатационные задачи;
- продуктовым и R&D-командам, оценивающим реальную пользу бенчмарков и reasoning;
- специалистам по on-prem AI, считающим стоимость владения и инфраструктурные риски.
Если вы решаете, стоит ли включать модель в рабочий контур, а не просто немного попробовать ее возможности, эта статья для вас.
Термины и оговорки
Перед разбором возможностей GLM-4.7 важно зафиксировать несколько принципиальных моментов, которые часто искажаются в обсуждениях и маркетинговых материалах:
- Open-weights не равны open-source: лицензии и ограничения могут существенно различаться;
- Vendor-reported benchmarks – ориентир, а не доказательство превосходства без собственного PoC;
- результаты «w/ Tools» некорректно напрямую сравнивать с режимом без инструментов;
- агентность – свойство всей системы (модель + обвязка), а не самой модели;
- GLM-4.7 в API – Text → Text; визуальные сценарии описаны на уровне платформы;
- «Multimodal interaction» не означает image input у endpoint’а.
Эти оговорки помогают трезво оценивать модель и избегать ошибочных ожиданий при внедрении.
Когда брать GLM-4.7, а когда смотреть альтернативы
Если задача – coding-агенты, работа с репозиториями, терминалом и многошаговыми действиями, GLM-4.7 выглядит логичным кандидатом. Модель явно заточена под такие сценарии: улучшенные coding-бенчмарки, стабильный tool use, structured output и thinking-режимы дают преимущество именно в агентных пайплайнах. Альтернатива здесь – другие специализированные code-модели, но без длинного контекста или с менее зрелым инструментальным API.
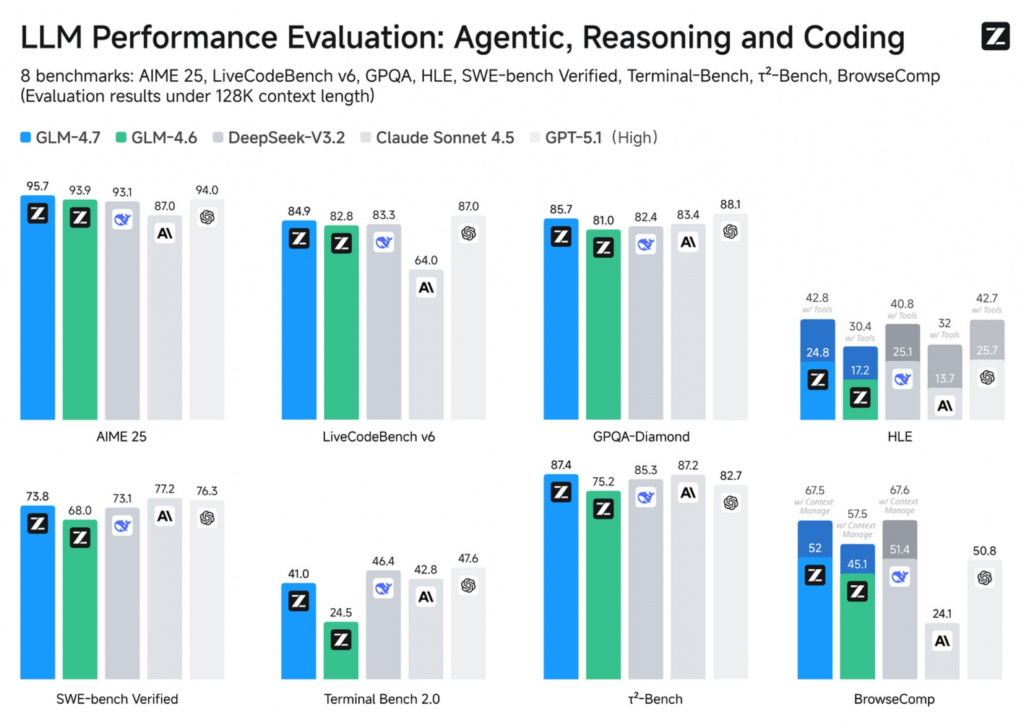
Сравнение производительности GLM-4.7 с другими LLM на 8 бенчмарках: модель лидирует по большинству метрик в задачах reasoning, кодирования и агентного поведения. Особенно выделяются AIME 25, GPQA и τ²-Bench. Источник: .
Для терминальных задач и DevOps-автоматизации (runbooks, диагностика, анализ логов) GLM-4.7 снова в «зеленой зоне». Связка reasoning + tools позволяет выстраивать цепочки действий, а большой контекст упрощает работу с логами и конфигами. Если же требуется минимальная латентность или жестко контролируемые шаблоны команд, иногда разумнее смотреть в сторону более узких, lightweight-моделей.
Когда ключевое требование – длинный контекст (большие кодовые базы, требования, спецификации), GLM-4.7 выигрывает за счет 200K контекста и 128K вывода. Альтернатива – модели с меньшим контекстом плюс сложный контекст-менеджмент, что повышает инженерную сложность и риск ошибок.
Для сценариев со строгими форматами ответа, function calling и JSON-выводом GLM-4.7 подходит хорошо: structured output и caching делают поведение модели более предсказуемым. Если же задача сводится к простым FAQ или чатам без инструментов, ее возможности будут избыточны – здесь проще и дешевле взять более базовую модель.
С точки зрения стоимости владения и on-prem-развертывания GLM-4.7 интересна тем, что веса доступны и модель можно встроить в собственный MLOps-контур. Но если инфраструктура ограничена или нет ресурсов на эксплуатацию, облачные альтернативы с меньшими требованиями могут оказаться практичнее.
Мини-сравнение моделей
Чтобы не утонуть в десятках характеристик и бенчмарков, ниже – сжатое сравнение ключевых классов моделей:
| Модель / класс модели | Ключевой сценарий | Модальности | Контекст / вывод | Сильные стороны | Ограничения |
| GLM-4.7 | Coding-агенты, tool use, длинный контекст | Text → Text | 200K / 128K | Агентные сценарии, structured output, reasoning с инструментами | Нет image input, выше требования к инфраструктуре |
| GLM-4.6 | Общие текстовые задачи, кодинг без агентов | Text → Text | 200K / 128K | Более простое внедрение, ниже нагрузка | Слабее в агентных и терминальных задачах |
| GLM-4.6V | Визуальные и мультимодальные задачи | Text + Image | Зависит от режима | Понимание изображений, vision-кейсы | Слабее в чисто кодовых агентных сценариях |
| Другие vision-модели | Компьютерное зрение, анализ изображений | Image / Multimodal | Зависит от модели | Специализация под vision | Не подходят для agentic coding |
| Lightweight LLM | FAQ, простые чаты | Text → Text | Ограниченный | Низкая стоимость, простота | Не тянут сложные пайплайны |
Ключевой вывод простой: GLM-4.7 имеет смысл рассматривать там, где важны код, инструменты и длинный контекст, а для визуальных задач стоит сразу смотреть в сторону GLM-4.6V или специализированных vision-моделей.
Что нового в GLM-4.7 по сравнению с GLM-4.6
Если коротко, GLM-4.7 – это не смена поколения, а целенаправленная доводка модели под инженерные и агентные сценарии. В сравнении с 4.6 акцент сместился от «просто сильного LLM» к роли ядра для coding-агентов, терминальных задач и многошаговых пайплайнов.
В core coding основной прирост виден именно там, где модель должна действовать, а не рассуждать абстрактно: исправлять баги, работать с репозиториями, выполнять цепочки команд. Параллельно прокачали так называемый «vibe coding» – генерацию более аккуратного фронтенда, документов и слайдов без ощущения «сырых» макетов.
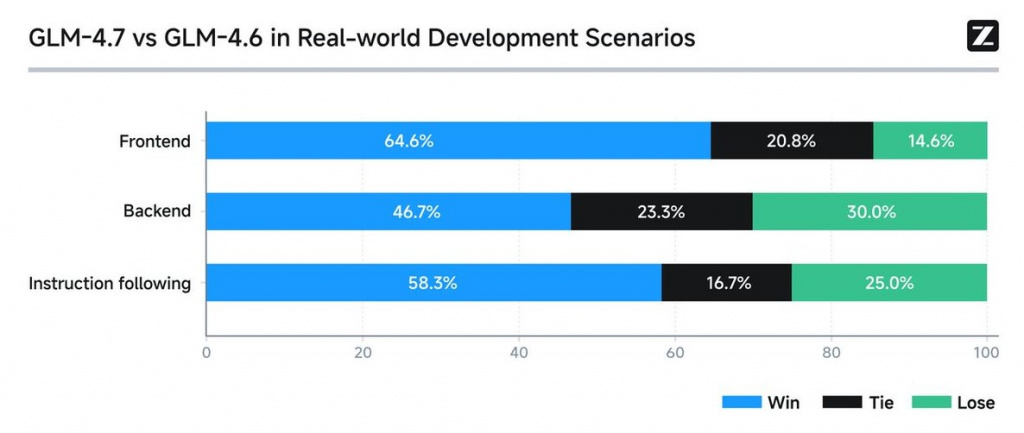
Сравнение GLM-4.7 и GLM-4.6 в реальных задачах разработки: фронтенд, бэкенд и выполнение инструкций. Источник: .
Отдельная линия развития – tool use: function calling, структурированный вывод и кеширование контекста стали заметно стабильнее в агентных сценариях.
Наконец, reasoning в GLM-4.7 меньше завязан на «красивые рассуждения» и больше – на устойчивое выполнение длинных цепочек действий с инструментами. Именно здесь дельты к 4.6 выглядят наиболее показательно, особенно в режимах “w/ Tools”, где модель работает как часть системы.
Кодинг и терминальные задачи
В части кодинга GLM-4.7 демонстрирует заметный прирост по ключевым инженерным бенчмаркам. По SWE-bench Verified заявлен результат 73.8 (+5.8 к GLM-4.6), по SWE-bench Multilingual – 66.7 (+12.9), а по Terminal Bench 2.0 – 41.0 (+16.5).
Эти цифры напрямую указывают на усиление именно агентных сценариев, где модель должна не только писать код, но и корректно работать с окружением и инструментами.
Важно сразу оговориться: все значения – vendor-reported и приведены в model card. Они полезны для ориентира, но не отменяют необходимости проверять модель на собственных репозиториях, языках и типовых задачах. Особенно это критично для Terminal Bench, где многое зависит от политики инструментов и окружения.
Vibe coding
Отдельно в GLM-4.7 подчеркивается улучшение качества генерации интерфейсов и визуально ориентированных артефактов. Речь идет не о дизайне «с нуля», а о более чистых и современных веб-страницах, аккуратной верстке и адекватных пропорциях элементов. Аналогичный акцент сделан на презентациях и документах: улучшены layout, отступы и sizing, меньше «расползания» контента.
Vibe Coding — это когда программирование становится доступным для тех, кто не готов тратить годы на изучение разработки. Источник: .
Это особенно полезно для быстрых прототипов, внутренних инструментов и генерации черновых презентаций. Модель чаще попадает в ожидаемую структуру и требует меньше ручной правки. При этом для production-UI ничего принципиально не меняется: без дизайн-системы, линтеров и визуальных тестов результат все равно остается нестабильным. GLM-4.7 ускоряет старт, но не заменяет фронтенд-контроль.
Tool use и агентные фреймворки
В GLM-4.7 заметно доработан инструментарий для агентных приложений. Поддержка function calling и structured output (JSON) стала стабильнее, снизилось число ошибок при строгой валидации схем. Контекст-кеширование позволяет экономить токены и уменьшать латентность в длинных диалогах и циклах агента.
В model card также заявлены улучшения на τ²-Bench и BrowseComp, что указывает на более предсказуемую работу в сценариях поиска и многошагового взаимодействия с инструментами. Здесь важно не путать уровни ответственности: модель умеет корректно вызывать инструменты, но реальные действия – это всегда зона ответственности агентного приложения. Без оркестратора, sandbox и политик безопасности даже улучшенный tool use не превращается в надежную систему.
Reasoning: thinking-режимы и не только
Одно из ключевых отличий GLM-4.7 – развитие thinking-режимов. Поддерживаются interleaved thinking (рассуждение вперемешку с действиями), preserved thinking (сохранение логики между шагами) и turn-level thinking, где рассуждение можно включать или отключать на уровне отдельных запросов. Это дает больше контроля над стоимостью, латентностью и поведением модели.
Характерный пример – HLE (w/ Tools): 42.8 (+12.4 к GLM-4.6). Этот прирост показателен именно для режимов с инструментами, где важна устойчивость цепочек действий, а не глубина абстрактных рассуждений. На практике это означает меньше «срывов» в середине сценария и более предсказуемое выполнение сложных задач.
Технический профиль и API-характеристики GLM-4.7
С технической точки зрения GLM-4.7 позиционируется как высокоуровневая текстовая модель для инженерных и агентных сценариев. В API она строго определена как Text → Text: модель принимает на вход текст и возвращает текст, без нативной поддержки изображений или аудио. Ключевая ставка сделана на масштаб контекста и управляемость поведения в сложных пайплайнах.
Контекстное окно составляет 200K токенов, а максимальный объем вывода – до 128K. Это выводит GLM-4.7 в класс моделей, рассчитанных на работу с большими кодовыми базами, многостраничными требованиями и длинными цепочками взаимодействия. Дополнительно в документации заявлены возможности, критичные для агентных систем: streaming-ответы, thinking mode, function calling, context caching и structured output.
В совокупности эти характеристики делают модель не столько «умным собеседником», сколько предсказуемым компонентом системы. При правильной интеграции GLM-4.7 можно использовать как ядро для агентов, IDE-ассистентов и автоматизированных инженерных процессов, где важны контроль, повторяемость и масштабируемость.
Контекст 200K и вывод 128K – что это дает на практике
Большое контекстное окно позволяет загружать в модель целые репозитории, наборы требований, логи инцидентов или многофайловые диффы без агрессивной нарезки. Это упрощает анализ связей между файлами и снижает риск потери важного контекста. Для агентных сценариев это особенно ценно: модель может держать в памяти историю шагов и состояние задачи.
Одновременно растут и риски. Длинный контекст напрямую влияет на стоимость запроса и латентность, особенно при повторных вызовах. Поэтому в практических системах без контекст-менеджмента не обойтись: суммаризация, выборочные окна и явное управление памятью становятся обязательными. GLM-4.7 дает простор, но не отменяет необходимости дисциплины в агентных пайплайнах.
Structured output, function calling, контекст-кеширование
Поддержка structured output позволяет задавать строгие JSON-схемы и получать валидируемые ответы, пригодные для автоматической обработки. В сочетании с function calling это упрощает построение агентов, которые принимают решения и передают параметры в инструменты без «ручного парсинга» текста. Строгая валидация снижает число ошибок и делает поведение системы более предсказуемым.
Контекст-кеширование играет ключевую роль в длинных диалогах и циклах агента. Оно позволяет не пересылать неизменные части контекста при каждом запросе, снижая стоимость и ускоряя отклик. В продакшене это особенно важно при retry-политиках и контроле idempotency инструментов, когда один и тот же шаг может выполняться повторно.
Где «мультимодальность» на самом деле (чтобы не ошибиться)
Важно четко разделять возможности модели и сценарии платформы. Endpoint GLM-4.7 остается текстовым и не принимает изображения на вход. Все упоминания “multimodal interaction” относятся к прикладным кейсам на платформе Z.ai, где используются камера, жесты или интерактивные интерфейсы.
Для задач понимания изображений или других визуальных модальностей у Z.ai существуют отдельные релизы, например GLM-4.6V. Смешение этих понятий часто приводит к неверным архитектурным ожиданиям. В случае GLM-4.7 мультимодальность – это уровень приложения, а не свойство самой модели.
Бенчмарки и методология сравнения
При оценке GLM-4.7 акцент сделан на бенчмарках, которые ближе всего к реальным задачам dev-агентов. SWE-bench и Terminal Bench проверяют не абстрактные знания, а способность модели исправлять код, ориентироваться в проекте и взаимодействовать с окружением.
Отдельно важно понимать различие между режимами “w/ Tools” и «без инструментов». В первом случае часть работы выполняют внешние системы – терминал, браузер, поиск, – поэтому такие результаты отражают эффективность связки «модель + инструменты». Сравнивать их напрямую с чистым reasoning некорректно: это разные классы задач и разные источники успеха.
Ниже приведен набор ключевых метрик, которые чаще всего используются для первичной оценки моделей в инженерных сценариях:
| Метрика | Что измеряет | Как интерпретировать |
| SWE-bench Verified | Исправление реальных багов | Близко к задачам code review и bugfix |
| SWE-bench Multilingual | Кодинг на разных языках | Важно для polyglot-репозиториев |
| Terminal Bench 2.0 | Работа с CLI и окружением | Ключевой индикатор агентного кодинга |
| HLE (w/ Tools) | Многошаговые задачи с инструментами | Показывает устойчивость пайплайна |
Эти показатели позволяют понять, в каких сценариях модель потенциально сильна, но не отвечают на вопрос, как она поведет себя в конкретном проекте.
GLM-4.7 vs GLM-4.6 по ключевым дельтам
Сравнение с предыдущей версией полезно для понимания, является ли релиз эволюционным или действительно дает практический прирост:
| Метрика | GLM-4.6 | GLM-4.7 | Дельта |
| SWE-bench Verified | ~68.0 | 73.8 | +5.8 |
| SWE-bench Multilingual | ~53.8 | 66.7 | +12.9 |
| Terminal Bench 2.0 | ~24.5 | 41.0 | +16.5 |
| HLE (w/ Tools) | ~30.4 | 42.8 | +12.4 |
Даже на уровне vendor-reported цифр видно, что основной прирост сосредоточен в агентных и терминальных сценариях, а не в «общих» текстовых задачах.
Сравнение с конкурентами
Ниже приведена сводка метрик, которые обычно публикуются в model card и используются для витринного сравнения с другими крупными моделями:
| Метрика | Назначение |
| MMLU-Pro | Общая академическая подготовка |
| GPQA-Diamond | Сложные вопросы и reasoning |
| LiveCodeBench-v6 | Современные coding-задачи |
| SWE-bench Verified | Исправление багов |
| Terminal Bench 2.0 | Терминальные и агентные сценарии |
| BrowseComp | Поиск и навигация с инструментами |
| HLE (w/ Tools) | Многошаговые агентные задачи |
Эта витрина полезна для первого скрининга, но любые выводы по ней требуют подтверждения через PoC и тестирование на собственных задачах.
Итоги – что важно запомнить про GLM-4.7
GLM-4.7 – это флагманская текстовая модель, ориентированная прежде всего на кодинг, агентные сценарии и работу с инструментами. Ее сильные стороны проявляются там, где нужны многошаговые действия, терминальные задачи и устойчивое выполнение цепочек с function calling. Большой контекст в 200K токенов и вывод до 128K упрощают работу с крупными кодовыми базами, требованиями и логами. Thinking-режимы добавляют управляемости и делают поведение модели более предсказуемым в сложных пайплайнах.
GLM-4.7 набирает популярность — новая версия модели вырывается вперед по ключевым метрикам и задачам. Источник: .
При этом GLM-4.7 не универсальна. Для vision-задач и мультимодального ввода нужно сразу смотреть на отдельные модели, такие как GLM-4.6V. В safety-критичных сценариях без песочницы, строгих политик и аудита ее использование требует особой осторожности. Как и в случае с другими LLM, заявленные бенчмарки – это ориентир, а не гарантия результата.
Практический вывод простой: оценивать GLM-4.7 стоит на одном и том же наборе собственных задач, фиксируя метрики качества, стоимости и латентности, а не полагаясь только на витринные цифры.
