Graph-RAG и Agentic RAG: следующий шаг в развитии Retrieval-Augmented Generation
Введение
Как вы помните из нашей прошлой статьи, RAG стал мощным инструментом для оптимизации больших языковых моделей, открывая им доступ для работы с актуальными или специализированными данными. Однако, классический RAG, основанный на векторном поиске, хорошо справляется только с задачами вроде ответов на вопросы из FAQ или анализа простого семантического поиска. Когда речь заходит о сложных, многоступенчатых запросах, взаимосвязанных документах или необходимости выполнения действий, его возможностей часто оказывается недостаточно. Именно эти ограничения стимулировали развитие двух мощных надстроек над классическим RAG — Graph-RAG и Agentic RAG. Но эти технологии стали не “убийцей” традиционного RAG, а продолжателями его идей, расширяя функциональность, эффективность и интеллектуальность базовых систем Retrieval-Augmented Generation. В этой статье мы разберемся, что из себя представляют Graph-RAG и Agentic RAG, зачем нужны эти передовые системы, как они используются, а также объясним, как в будущем будут развиваться RAG-технологии.
Graph-RAG вносит структурное понимание данных, превращая разрозненные фрагменты информации в связанное полотно знаний. Agentic RAG добавляет элемент принятия решений, позволяя системе самостоятельно планировать и выполнять последовательности действий для ответа на запрос. Вместе они представляют собой следующий логический шаг в развитии RAG-систем. Сначала мы разберем Graph-RAG как метод работы с графами знаний, а затем перейдем к агентам, которые оживляют эти данные.
Graph-RAG: когда база знаний превращается в граф
Основная идея надстройки Graph-RAG заключается в переходе от хранения документов в виде изолированных векторных представлений к построению динамического графа знаний. Граф знаний — это способ структурированного представления информации, который организует и связывает данные из различных источников, чтобы представить данные в максимально структурированном виде. В отличие от традиционной базы данных, где данные хранятся в таблицах, граф знаний сосредоточен на контексте и связях между частями информации. В такой системе каждый узел данных не просто находится в удобном доступе для RAG, а превращается в паутину, где из основного контекстного объекта (сущности) в центре ветвятся нити (связи) к логически связанным с ним объектам. Это коренным образом меняет подход к поиску информации. Если вы думаете, что RAG хорош сам по себе и ему не нужна дополнительная оптимизация поиска данных в виде Graph-RAG, то вы ошибаетесь, ведь эта технология не так проста, как кажется на первый взгляд. Благодаря Graph-RAG ваша LLM не только лучше справляется с поиском, но и начинает в разы эффективнее справляться с многоуровневыми операциями, перескакивая из одного блока знаний в другой.
Рассмотрим практический пример. Вы задаете вопрос ИИ: “Почему сайт начинает тормозить при росте количества пользователей?”. Векторный RAG, скорее всего, подберет тексты о проблемах с производительностью серверов, оптимизацией запросов к базе данных или масштабированием, но не установит причинно-следственную связь между этими явлениями — он просто выдаст сухие факты. Graph-RAG же может пройти по цепочке этих фактов последовательно: от сущности “увеличение нагрузки” по связи “приводит к” к сущности “рост числа запросов”, затем к сущности “увеличение времени отклика базы данных”, а оттуда к сущности “замедление работы сайта”. Такой подход особенно полезен в IT-аналитике, где важно выявлять не просто набор признаков проблемы, а их взаимосвязи — например, при исследовании архитектурных узких мест, анализе дыр в системах защиты или построении моделей причин отказов в распределенных системах.
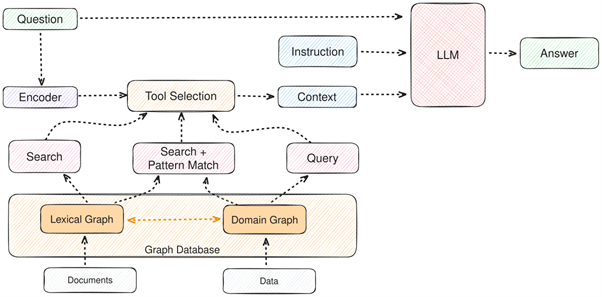
Схема работы графового RAG. Источник: Wikipedia.
Инструменты для Graph-RAG
Реализация Graph-RAG на практике опирается на использование специализированных инструментов и баз данных. Центральное место здесь занимают графовые базы данных, такие как Neo4j, TigerGraph и ArangoDB, которые идеально подходят для хранения и анализа сложных сетей взаимосвязей и имеют открытый исходный код. У Microsoft тоже есть свой GraphRAG база данных, но несмотря на свое название, она скорее является референсной архитектурой и одновременной библиотекой, которая демонстрирует полный цикл работы с базами графов: от извлечения сущностей и связей из текста с помощью LLM до построения графа и генерации ответов на основе глобального и локального поиска.
Фреймворки для построения LLM-приложений активно интегрируют возможности работы с графами. Например, LlamaIndex предоставляет мощные абстракции для создания и использования индексов на основе графов знаний, а LangChain позволяет интегрировать графовые базы данных через концепцию ритриверов и инструментов, делая Graph-RAG частью более сложных агентских рабочих процессов.
Процесс построения графа обычно включает в себя несколько этапов:
- Извлечение сущностей (NER): идентификация сущностей в тексте.
- Извлечение отношений: определение связей между этими сущностями.
- Кластеризация: алгоритмы, такие как Leiden, группируют тесно связанные сущности в сообщества.
- Суммаризация: LLM генерирует текстовые описания для этих сообществ, что позволяет системе эффективно отвечать на вопросы, используя имеющийся набор данных.
Стоит отметить, что построение и поддержка графов знаний — задача более сложная и ресурсоемкая по сравнению с созданием векторных индексов. Поэтому Graph-RAG не является универсальным решением, так как он не подойдет для развертывания на системах с ограниченным объемом ресурсов. Однако для сложных доменов, где связи между данными не менее важны, чем сами данные, Graph-RAG становится must-have инструментом.
Agentic RAG: когда к поиску добавляются действия
Если Graph-RAG делает систему "знатоком", то Agentic RAG делает ее "сообразительной". Это подход, в котором RAG сочетается с концепцией ИИ-агентов — программных модулей на основе искусственного интеллекта, способных к принятию решений и выполнению различных операций. Агент не просто пассивно извлекает контекст по запросу, а активно решает, как на этот запрос ответить: нужно ли обратиться к векторной базе, выполнить ли SQL-запрос, сделать ли вызов API или скомбинировать несколько этих действий.
Ярким примером является связка LangChain Agents и LangGraph. LangGraph позволяет проектировать сложные, многошаговые рабочие процессы (графы состояний), где LLM выступает в роли "мозга", принимающего решения о переходе между узлами-действиями. Например, на запрос пользователя "Покажи продажи за текущий квартал и сравни с прошлым годом" агент может выполнить следующую последовательность:
- Принять решение: LLM анализирует запрос и определяет, что для ответа нужны данные из базы.
- Вызвать инструмент: агент формирует и выполняет соответствующий SQL-запрос.
- Оценить результат: полученные данные могут быть переданы обратно агенту для анализа.
- Сгенерировать ответ: на основе извлеченных данных LLM формирует итоговый ответ для пользователя.
Важной особенностью Agentic RAG является возможность итеративного уточнения. Если первоначально найденные документы релевантны, система переходит к генерации ответа. Если нет — агент может принять решение переформулировать вопрос и повторить поиск. Этот цикл мышления превращает RAG из статичного инструмента поиска в динамичного интеллектуального ассистента.
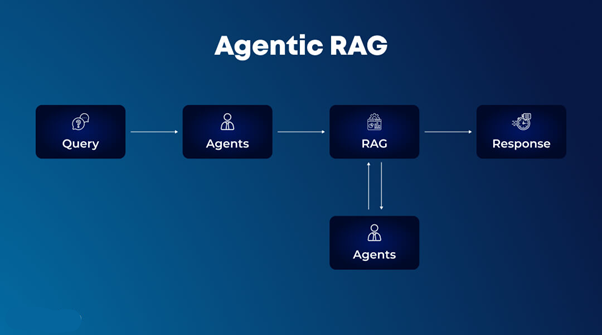
Схема работы системы агентского RAG. Источник: .
Примеры использования Graph-RAG и Agentic-RAG
Комбинации этих технологий находят применение в реальных бизнес-задачах, трансформируя области, где требуется глубокий анализ информации.
Сценарии для Graph-RAG:
- Медицина и фармацевтика: построение графов знаний, связывающих гены, болезни, симптомы, лекарства и клинические исследования. Это позволяет исследователям находить скрытые связи и генерировать новые гипотезы для изучения инновационных лекарств.
- Юриспруденция: анализ сложных юридических дел, где необходимо отследить взаимосвязи между статьями законодательства, судебными прецедентами, сторонами процесса и доказательствами.
- Корпоративные знания: управление внутренней документацией крупных компаний, где проекты, продукты, сотрудники и отчеты тесно переплетены друг с другом. Graph-RAG позволяет новым сотрудникам быстро погружаться в контекст и находить экспертов по нужным темам.
Сценарии для Agentic RAG:
- Бизнес-аналитика и отчетность: агент может самостоятельно, получая запросы на естественном языке, делать запросы к базам данных, извлекать ключевые метрики из CRM-систем, строить сводки и даже формировать визуализации.
- Автоматизация рутинных задач: Например, ассистент в службе поддержки, который не только находит информацию в базе знаний, но и может проверить статус заказа через API, а затем сообщить его клиенту.
Эти подходы переводят RAG из категории "умного поиска" в категорию "интеллектуальных партнеров", способных решать комплексные задачи.
Будущее: Multimodal RAG и комбинации
Эволюция RAG не заканчивается на изобретении Graph-RAG и Agentic-RAG. Набирает обороты направление так называемых Multimodal RAG, которые позволяют работать не только с текстом, но и с изображениями, таблицами, аудио и видео. Эти функции критически важны для обработки современных корпоративных данных, которые часто представлены в виде PDF-отчетов с графиками, технической документации со схемами или мультимедийных презентаций.
Существует несколько подходов к реализации Multimodal RAG:
- Единое векторное пространство: модели CLIP кодируют и текст, и изображения в едином латентентном пространстве, что упрощает поиск нужных данных.
- Приведение к одному формату: например, генерация текстовых описаний для всех изображений и таблиц с последующей работой только с текстом.
- Раздельные хранилища с реранкингом: создание отдельных индексов для каждого типа данных с последующим объединением и ранжированием результатов.
Наиболее перспективным выглядит сценарий, в котором Graph-RAG, Agentic RAG и Multimodal RAG связываются в единой интеллектуальной системе, где агент (Agentic RAG) для ответа на вопрос "Проанализируй динамику продаж по регионам на основе последнего отчета" сначала извлекает сырые данные из SQL-базы, затем обогащает их контекстом из графа знаний (Graph-RAG) о региональных менеджерах и маркетинговых активностях, а итоговый ответ представляет в виде текста и графика, сгенерированного мультимодальном LLM.
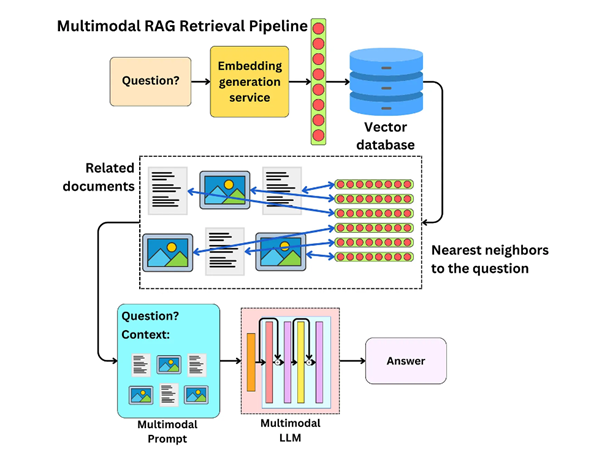
Пайплан мультимодального RAG. Источник: Zilliz.
Выводы
Graph-RAG и Agentic RAG — это не просто новые акронимы в мире ИИ, а закономерный шаг в эволюции RAG-систем, направленный на решение его ключевых ограничений. Graph-RAG вносит структурное понимание и способность к сложным логическим выводам, в то время как Agentic RAG добавляет гибкость, самостоятельность и возможность взаимодействия с внешними системами. Важно помнить, что эти подходы не отменяют и не заменяют классический RAG, а скорее дополняют его, создавая мощные гибридные архитектуры. Они превращают RAG из инструмента для поиска фактов в платформу для построения интеллектуальных ассистентов, способных решать реальные бизнес-задачи в сложных предметных областях.Такие фреймворки, как LangChain и LlamaIndex, уже сегодня предоставляют инструментарий для построения таких гибридных систем, открывая новые горизонты для разработчиков ИИ-приложений.
